LangChain入门:大模型调用、Agent实战与环境配置指南

为什么需要LangChain这样的框架
要理解LangChain的存在价值,得先从大语言模型(LLM)本身的局限说起。大模型的本质是基于训练数据进行概率推理的对话系统——你问它答,看似智能,实际上有三个绕不开的短板。
值得先了解一点背景:主流大语言模型基于Transformer架构,通过对海量文本进行预训练,将知识以统计规律的形式压缩进数十亿乃至数千亿的模型权重中。Transformer由Google在2017年论文《Attention Is All You Need》中提出,其核心创新是自注意力机制(Self-Attention),允许模型在处理序列时动态关注不同位置的信息,从根本上解决了此前RNN/LSTM架构难以捕捉长距离依赖的问题。预训练阶段,模型通过海量文本学习语言规律,将世界知识以权重参数的形式固化——这意味着知识更新必须重新训练或微调,无法像数据库那样实时写入。这种"知识固化在权重里"的设计是大模型架构的本质特征,而非工程实现上的缺陷,由此天然决定了它存在以下三大局限。
第一,知识存在时间边界。模型只掌握训练截止时间点之前的知识,此后发生的事件它一无所知。工程上解决这一问题的主流方案是检索增强生成(RAG,Retrieval-Augmented Generation):在用户提问时,先从外部知识库中检索出相关文档片段,再将这些片段连同问题一起送入模型,让模型基于实时检索到的内容生成回答,而非仅凭训练时的静态知识。RAG的核心依赖是向量数据库(如Pinecone、Chroma、Weaviate、Milvus),它将文本转化为高维稠密向量并建立近似最近邻(ANN)索引,使"按语义相似度检索"成为可能——区别于传统关键词搜索,向量检索能够找到意思相近但措辞不同的文档。LangChain为RAG流程提供了完整的抽象层,包括文档加载器(DocumentLoader)、文本分割器(TextSplitter)和统一的向量存储接口(VectorStore),开发者无需关心底层向量库的差异即可搭建端到端的知识问答系统。第二,模型本身没有记忆。你告诉它"我叫张三",下一轮对话再问"我叫什么",纯粹的大模型是记不住的,因为它不具备持久化存储能力——每次对话对模型而言都是全新的无状态请求。这一特性源于Transformer的推理机制:每次前向传播都从空白上下文开始,上一次调用的中间状态不会保留在模型内部,必须由外部系统显式维护。第三,无法接入业务数据,也就无法真正服务于具体的企业场景。
正是这三个痛点,催生了以LangChain为代表的AI应用开发框架。框架帮你系统地管理记忆、维护上下文状态、绑定并调用外部工具,让开发者无需从零处理这些底层细节。需要特别强调的是:学习大模型应用开发不等于研究算法。大模型的能力已经摆在那里,我们要做的是把这份能力更好地嵌入业务,构建真正落地的AI应用。
LangChain的核心定位与优势
LangChain本质上是一个用于开发AI应用的框架。它诞生于2022年底,恰好赶上ChatGPT引发的AI应用热潮,凭借活跃的社区和持续迭代,迅速成为AI应用开发领域的事实标准。类似产品还有OpenAI SDK、Anthropic(Claude)SDK等,但在企业实践中,LangChain及其配套的LangGraph生态使用率最高。
其中LangGraph是LangChain的延伸产品,专注于构建有状态、可循环的多智能体工作流。它基于有向无环图(DAG)思想构建工作流,节点代表计算步骤,边代表数据流转路径,支持条件分支和循环结构。这一设计借鉴了函数式编程与数据流编程的思想,使得复杂的多智能体协作成为可能,例如一个Agent负责搜索、另一个负责总结、第三个负责质量审核,形成流水线。与简单的链式调用不同,LangGraph的状态机设计让工作流可以根据中间结果动态调整执行路径,能够处理需要多步推理、循环验证的复杂业务场景。LangChain与LangGraph共同构成了目前最完整的AI应用开发生态。
为什么主流选择Python而非Java?原因有二:一是几乎所有大模型的私有化部署(如通过vLLM)都依赖Python生态,Java缺乏对应框架。vLLM是加州大学伯克利分校开发的高性能LLM推理引擎,其核心创新PagedAttention技术将GPU显存管理类比操作系统的分页内存,将KV Cache切分为固定大小的物理块按需分配,显著提升了并发推理效率和显存利用率,在高并发场景下吞吐量可比朴素实现提升数倍——而它完全依赖Python生态,CUDA绑定、Triton内核、PyTorch后端均无成熟的Java替代品。二是LangChain/LangGraph是最早一批AI应用框架,几乎所有新推出的大模型API都会优先适配这套生态,形成了强烈的网络效应。
框架的核心特点可以概括为两点:
统一的模型接口
过去调用不同厂商的大模型,每家接口各异,换一个模型就得改一次代码。LangChain提供统一的调用方式,只需替换模型名称,上层代码无需改动,框架自动兼容各厂商模型。这得益于LangChain在内部对各厂商SDK进行了统一封装:无论是OpenAI、Anthropic还是国内的DeepSeek广告、通义千问广告,都被抽象为同一套接口,切换成本极低。这种设计模式在软件工程中称为"适配器模式"(Adapter Pattern),LangChain充当中间层,将各厂商的差异化API统一翻译为一套标准化调用契约。从更宏观的视角来看,这一统一接口设计也降低了企业对单一模型供应商的依赖——当某家厂商调价、服务不稳定或出现更优替代品时,切换成本接近于零,这在商业上具有重要的战略价值,也是大型企业采用LangChain构建AI基础设施时的重要考量。
模块化架构
大模型交互中涉及的状态、上下文、历史消息、工具调用、提示词、中间件等,在框架里都被拆分为独立模块。这种设计让Agent智能体、工具调用、记忆管理等功能可以灵活组合,开发者可以像搭积木一样按需拼装所需能力,而不必关心底层实现细节。值得一提的是,LangChain的模块化设计在一定程度上遵循了**LCEL(LangChain Expression Language)**的管道理念——使用|操作符将不同组件串联,形成从提示词到模型到输出解析器的处理链,使数据流向清晰可读,并天然支持异步执行和流式输出,满足生产环境对性能的要求。
本文使用的版本为LangChain 1.3.2、LangGraph 1.2,开发环境是PyCharm + Python 3.13。
环境配置与API密钥准备
开始编码前,需要在项目中配置Python环境,并引入.env文件来管理密钥。虽然示例中配置项较多,但真正必需的只有两个:DEEPSEEK_API_KEY 和 DEEPSEEK_BASE_URL。
获取方式很直接:登录DeepSeek官网,进入API Keys页面创建新密钥,同时在接口文档中找到对应的Base URL,将两者填入.env即可。当然,DeepSeek只是示例选择,你也可以换成OpenAI、Anthropic、腾讯混元、阿里通义千问、智谱等任意厂商。
使用.env文件而非硬编码密钥,是工程实践中的基本安全规范——密钥一旦随代码提交到Git仓库,极易造成泄露。这在业界被称为"密钥泄露"(Secret Leakage)问题,GitHub官方统计显示每年有数以百万计的API密钥以这种方式暴露,轻则产生意外账单,重则导致数据安全事故。代码中通过dotenv加载.env文件,把配置好的密钥读取为环境变量,供后续初始化模型时使用。.env文件本身应加入.gitignore,只在本地和生产环境中存在,绝不提交到版本控制系统。在团队协作场景下,通常会额外提供一个.env.example文件,其中列出所有需要配置的变量名但不填写具体值,作为配置模板随代码库一起分发,让新成员能够快速了解需要申请哪些密钥——这是工程实践中被广泛采纳的约定俗成规范。

初始化并调用大模型
LangChain提供了通用的模型初始化方式 init_chat_model,这也是最推荐的做法。核心参数包括模型名称、模型提供商(provider)、API Key 和 Base URL。
示例中使用的是 DeepSeek V4 Pro 模型,provider 填 deepseek。这里有一个值得注意的参数——通过设置 extra_body 中的 thinking 类型为 disable,可以关闭思考模式。
为什么建议关闭思考模式
DeepSeek 推出了新模型体系:原来的 deepseek-chat 是非推理模型,deepseek-reasoner 是带思考过程的推理模型;Flash 版本对应思考模式,Pro 版本能力更强。所谓"思考模式",本质上是Chain-of-Thought(CoT,思维链)技术的工程实现。这一方法由Google Brain团队于2022年在论文《Chain-of-Thought Prompting Elicits Reasoning in Large Language Models》中系统提出,核心思想是让模型在输出最终答案前显式生成中间推理步骤,模拟人类解题时"打草稿"的过程。研究表明,CoT在数学推理、逻辑谜题、多步骤问题等任务上能将准确率提升数十个百分点,尤其在参数量足够大的模型上效果显著。然而其代价是Token消耗大幅增加——思考过程本身就要占用大量上下文窗口,一次推理可能生成数千乃至数万个思考Token,直接推高API调用成本并拉长响应延迟。在大模型计费模型中,输入Token与输出Token通常分别计价,而思考过程产生的Token属于输出Token,以DeepSeek等主流厂商的定价结构来看,输出Token的单价往往是输入Token的数倍,这意味着开启思考模式可能导致单次调用费用成倍上涨,在高并发的生产环境中会对成本控制构成显著压力。建议关闭 thinking 的理由有两点:
- 性能考量:开启思考模式后回复速度明显变慢,而构建智能体或简单大模型应用大多用不到深度推理。对大部分场景,DeepSeek Flash 已经足够准确。
- 兼容性考量:LangChain 目前对思考模式的兼容性还不够完善,可能出现意外问题。
换用其他厂商模型时,只需修改 provider 名称、API Key 和 Base URL,改动极小。
调用方式与消息类型详解
模型创建完成后,通过 invoke 方法即可发起调用。比如传入"请介绍一下自己",模型会返回结果,返回内容默认是 Markdown 格式——直接打印时可读性一般,但渲染后展示效果极佳。
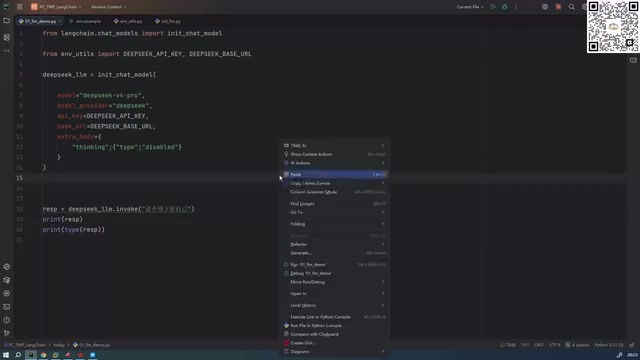
返回对象的类型是 AIMessage,这是理解 LangChain 消息体系的关键。LangChain 的消息类型设计参考了 OpenAI Chat Completions API 的角色划分——该API将对话参与者划分为三种角色:system(系统级指令,优先级最高)、user(用户输入)、assistant(模型回复)。这一设计后来成为行业事实标准,Anthropic、Mistral等主流厂商均采用兼容格式。值得一提的是,system角色的指令在模型处理时享有最高优先级,即便用户后续通过对话试图覆盖系统指令,模型通常也会遵循系统级约束——这正是企业在部署AI应用时用来限定模型行为边界的核心机制。LangChain将这套角色体系抽象为框架无关的消息类,SystemMessage、HumanMessage、AIMessage分别对应三种角色,从而实现跨厂商兼容——无论底层调用的是哪家模型,上层代码都使用同一套消息类型交互。除 AIMessage 外,框架中还有几类核心消息:
- SystemMessage:系统提示词存放于此,用于设定模型的角色、行为规范或背景信息,在每轮对话中通常固定不变
- HumanMessage:用户输入。你写的"请介绍你自己",底层会被自动包装成 HumanMessage 传入
- ToolMessage:工具调用返回的消息,与 Agent 的工具能力密切相关。Agent的工具调用本质上是**Function Calling(函数调用)**机制的应用层抽象——OpenAI于2023年在GPT-3.5/4系列中正式引入这一能力,允许模型在生成回复前输出结构化的函数调用意图(包含函数名和参数),由外部系统实际执行后将结果以ToolMessage形式注入上下文,供模型综合生成最终回复。这一机制打通了大模型与外部世界的交互通道:搜索引擎、数据库查询、代码执行器、企业内部API,乃至任何可以被封装为函数的能力,都可以通过Function Calling被大模型按需调用。LangChain将各厂商对Function Calling的不同实现统一封装为Tool接口,屏蔽了底层差异,使开发者只需定义工具的名称、描述和输入模式,框架自动处理与模型的交互协议。
这套消息类型的划分,正是 LangChain 模块化设计的直接体现,也是后续构建 Agent、实现记忆管理和工具调用的基础。
关于模型类的补充说明
新版 LangChain 除了通用的 init_chat_model,还提供了针对特定厂商的模型类,如 ChatDeepSeek、ChatOpenAI 等。建议很明确:优先使用通用方式,它已经兼容绝大多数厂商。只有当你使用自定义模型,或某些通用接口不支持的模型时,才需要用到具体的模型类。
小结
本文从大模型的三大局限出发,梳理了 LangChain 作为 AI 应用开发框架的核心价值,并完整走通了环境配置、API密钥准备、模型初始化到实际调用的入门流程。掌握大模型的基础调用与消息体系后,下一步就是深入理解 Agent 智能体与大模型的本质区别——这正是 LangChain 真正强大之处的起点。对于希望将 AI 能力落地到实际业务的开发者而言,打好这个基础至关重要。
核心要点
相关推荐
B站最细Codex保姆级攻略:从安装到实战全解析
B站最细Codex保姆级攻略:从应用商店安装到日常工作模式配置,用真实咖啡馆项目演示文件整理、数据提取、仪表盘制作等实战任务,教你用计划模式和桌面宠物高效使用Codex。

体渲染中的外观补偿:为何RGB准确无法保证密度正确
体渲染研究揭示:完美复现外部RGB视图的体数据仍可能存在密度错误。外观补偿机制使中心密度翻倍、L2误差超14.52%时外部射线仍不变,密度恢复依赖外观容量、空间分辨率与测量设计。

TMLE与AIPW的样本分割选择:交叉拟合与重复分割的影响
一项TMLE与AIPW模拟研究发现,样本分割方式显著影响区间覆盖率:样本内拟合倾向得分可使覆盖率跌至0.12-0.48,双nuisance交叉拟合则恢复至0.91-1.00;近正性下AIPW优于未加权TMLE,重复划分降低划分依赖但使区间更保守。