LangChain入门:统一接口与Agent实战详解

LangChain 是什么:AI 应用开发的统一底座
LangChain 是一个用于开发大模型应用的开源框架。它于2022年10月由 Harrison Chase 创立,彼时正值大语言模型技术的关键转折点——OpenAI 于同年11月发布 ChatGPT,引发全球 AI 应用开发热潮。在此之前,开发者若想将 GPT-3 等模型集成到应用中,需要手动处理 API 鉴权、提示词拼接、上下文窗口管理、多轮对话状态维护等大量繁琐的工程细节。LangChain 的出现,本质上是对这一时期工程实践的系统性总结与抽象——它将散落在各个开发者项目中的"胶水代码"标准化为可复用的组件体系,并随着 GPT-4 等大模型的爆发式增长,迅速成为 AI 应用开发领域最活跃的开源项目之一,GitHub Star 数在短短数月内突破数万。
它的核心价值在于为纷繁复杂的模型生态提供了统一接口——无论你使用 DeepSeek广告、OpenAI、Anthropic、通义千问广告、智谱还是腾讯混元,都可以用相同范式的代码去调用,底层只需替换模型即可,而不必针对每家供应商单独写一套适配代码。这一设计理念借鉴了软件工程中的"适配器模式"(Adapter Pattern)——通过统一抽象层屏蔽底层差异,使上层业务代码与具体实现解耦。
适配器模式与 LangChain 的抽象体系
适配器模式(Adapter Pattern)是 GoF(Gang of Four)设计模式中的经典结构型模式,其核心思想是通过引入一个"适配器"中间层,将不兼容的接口转换为调用方期望的统一接口——就像万能充电插头将不同国家的电源标准统一为设备可接受的输入。LangChain 在此基础上进一步延伸,不仅统一了底层 API 调用格式,还标准化了提示词模板(PromptTemplate)、输出解析(OutputParser)、对话记忆(Memory)、工具调用(Tool)等完整链路,构建了一套面向 LLM 应用开发的全栈抽象体系。这意味着开发者在 LangChain 框架内掌握的每一项技能,都能跨模型复用,极大降低了供应商迁移成本。
值得一提的是,LangChain 在0.1版本后重点推广的 **LCEL(LangChain Expression Language)**进一步深化了这一抽象哲学。LCEL 借鉴了函数式编程中的管道(Pipeline)概念,通过 | 操作符将 PromptTemplate、LLM、OutputParser 等组件串联成声明式的处理链,例如 chain = prompt | llm | parser。这种设计不仅让代码更具可读性,更使整个链路天然支持流式输出(Streaming)、批量处理(Batch)和异步调用(Async)。
函数式编程与管道范式的工程价值
函数式编程(Functional Programming,FP)中的管道(Pipeline)概念起源于 Unix shell 的
|操作符哲学:每个程序只做一件事,程序之间通过标准输入输出串联。在现代编程语言中,Elixir 的|>操作符、Haskell 的函数组合符.、以及 JavaScript 的提案 Pipeline Operator 均体现了这一思想。LCEL 将这一范式引入 LLM 应用开发,带来了多重工程收益:首先,每个组件(PromptTemplate、LLM、OutputParser)的职责边界清晰,单独可测试;其次,管道的组合性使得复杂处理链可以从简单组件逐步构建,而非写入单一的大型函数;最重要的是,LCEL 在管道层面统一实现了stream()、batch()、ainvoke()等能力,开发者无需为每种调用模式重写逻辑——这种"一次定义、多种调用"的特性正是 LCEL 相较于手写链路代码的核心竞争力。后文推荐的init_chat_model所返回的对象完全符合 LCEL 的 Runnable 接口规范,这正是它优于各供应商专属模型类的深层原因。
这对实际开发意义重大。过去接入不同模型时,开发者往往要研究每家 API 的鉴权方式、请求结构、返回格式;而在 LangChain 的抽象之下,这些差异被屏蔽,开发者只需专注于业务逻辑本身。对于需要在多个模型间做成本、性能权衡的团队,这种可切换性尤为关键。
环境准备:.env 文件与依赖安装
在正式写代码前,需要在项目根目录准备一个 .env 文件,用来存放各模型供应商提供的 API Key 与 Base URL。DeepSeek、OpenAI、Anthropic、混元、阿里通义、智谱等平台均需各自的密钥与连接地址,通常可在对应平台控制台的「API Keys」页面获取。
API Key 是访问大模型服务的凭证,本质上等同于账号密码,一旦泄露将导致费用盗刷或数据泄露。.env 文件与 python-dotenv 的组合是**十二因素应用(The Twelve-Factor App)**方法论中"配置与代码分离"原则的直接体现——这一由 Heroku 工程师于2011年总结的云原生应用最佳实践,明确要求将 API 密钥、数据库连接串等环境相关配置存储在环境变量中,而非硬编码在代码内。
十二因素应用方法论与密钥管理演进
十二因素应用(The Twelve-Factor App)是 Heroku 联合创始人 Adam Wiggins 于2011年总结的云原生应用构建方法论,其第三条因素"配置"明确指出:应用的配置(不同部署环境间存在差异的一切内容)应完全与代码分离,存储在环境变量中。这一原则催生了
.env+.gitignore的开发标准实践。然而随着云原生生态的成熟,密钥管理已发展出更完善的层次体系:开发环境使用.env文件满足便捷性,CI/CD 环境使用平台内置的 Secret 变量(如 GitHub Actions Secrets、GitLab CI Variables)满足安全隔离,生产环境则推荐使用 HashiCorp Vault(支持动态密钥生成与自动轮换)、AWS Secrets Manager(与 IAM 角色深度集成)或 Azure Key Vault 等专业密钥管理服务。这些工具不仅加密存储密钥,还提供审计日志、访问控制和自动轮换能力,能在密钥泄露时大幅缩短响应时间,是现代 AI 应用走向生产的必经基础设施。
在团队协作场景中,通常会同时维护 .env.example 文件(包含所有必填变量的键名但不含实际值)作为新成员的配置参考模板,同时将 .env 加入 .gitignore 以防止敏感信息进入版本控制系统。
依赖安装十分简单,以 DeepSeek 为例:
pip install langchain langchain-openai langchain-deepseek
安装完成后,通过 python-dotenv 加载环境变量:
from dotenv import load_dotenv
import os

load_dotenv(override=True)  # 优先从本项目 .env 加载
deepseek_api_key = os.getenv("DEEPSEEK_API_KEY")
deepseek_base_url = os.getenv("DEEPSEEK_BASE_URL")
override=True 表示优先使用本项目的 .env 配置,避免与系统级环境变量产生冲突。这在多项目开发场景中尤为重要——它确保当前项目的配置优先级高于系统级或 shell 级别的同名环境变量,避免跨项目污染。
两种模型创建方式:模型类 vs 统一接口
LangChain 提供了两种创建大模型对象的方式,理解它们的取舍是入门的关键。
方式一:模型类(不推荐)
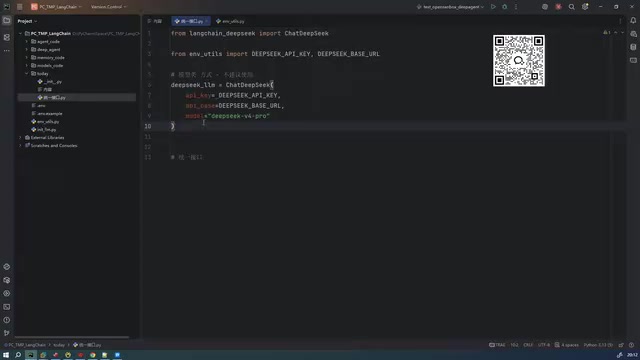
每个供应商都有对应的模型类,例如 DeepSeek 的 ChatDeepSeek、OpenAI 的 ChatOpenAI、Anthropic 的 ChatAnthropic:
from langchain_deepseek import ChatDeepSeek

llm = ChatDeepSeek(
    api_key=deepseek_api_key,
    api_base=deepseek_base_url,
    model="deepseek-chat"  # 更推荐最新的 deepseek-v3-pro
)
resp = llm.invoke("你好,请给我推荐几本书")
print(resp)
为什么不推荐? 原因有二:第一,各模型类命名不统一,难以记忆;第二,更关键的是——用模型类创建的对象在构建 Agent 或 DeepAgent 时,返回的嵌套结构可能与标准格式存在偏差(字段缺失或多余),导致解析时频繁报错。从 LCEL 架构视角来看,各供应商模型类对 Runnable 接口的实现完整度参差不齐,可能在流式输出或批量调用时出现意外行为,而 init_chat_model 则对这些能力做了统一保障。
方式二:统一接口 init_chat_model(推荐)
init_chat_model 是 LangChain 对各供应商兼容的统一创建方法,也是目前的最佳实践。其背后的支撑,是 OpenAI Chat Completions API 已事实上成为大模型接口的行业标准。
OpenAI Chat Completions API 成为行业标准的历史背景
OpenAI 于 2023 年推出的 Chat Completions API 设计了一套简洁而完备的消息协议:以
role(system/user/assistant/tool)区分对话参与方,以content承载文本与多模态内容,以tool_calls结构化描述工具调用意图。这套协议的精妙之处在于,它将对话上下文、指令注入与函数调用三者统一在同一数据模型中,极大降低了应用层的解析复杂度。正因为这套设计的前瞻性,国内外众多模型供应商(包括 DeepSeek、智谱 GLM、阿里通义、零一万物、Mistral、Together AI 等)纷纷选择主动兼容 OpenAI 协议,而非自行设计私有 API 格式。这种"协议标准化"带来了良性循环:开发者只需学习一套 API,生态工具(如 LangChain、LlamaIndex)只需维护一套核心解析逻辑,整个行业的研发效率因此显著提升。值得关注的是,这一现象在技术史上并不罕见——SQL 之于关系数据库、HTTP 之于 Web 服务,均经历了类似的从"单一厂商设计"到"行业事实标准"的演变路径,OpenAI 协议的胜出本质上是"先发优势 + 设计合理性 + 生态网络效应"三者共振的结果。
国内外众多模型供应商(包括 DeepSeek、智谱 GLM、阿里通义、零一万物等)均选择兼容 OpenAI 协议,这意味着只需修改 base_url 和 api_key,即可用完全相同的代码调用不同厂商的模型。
from langchain.chat_models import init_chat_model

llm = init_chat_model(
    model="deepseek-v3-pro",
    model_provider="deepseek",  # 也可写 openai、anthropic、google、ollama 等
    api_key=deepseek_api_key,
    base_url=deepseek_base_url
)
model_provider 支持 OpenAI、Anthropic、AWS、Google、Ollama、Groq、HuggingFace 等众多平台。如果找不到某个国内供应商(如智谱),只要它兼容 OpenAI 协议,直接填写 openai 同样可以正常工作。若不指定 provider,框架还会尝试自动推断。这种"OpenAI 协议兼容"策略降低了开发者的迁移成本,也加速了整个行业的生态融合。
关键坑点:DeepSeek 思考模式建议关闭
这是一个非常值得关注的实战经验。DeepSeek-v3-pro 默认开启思考模式,在 LangChain 中会带来两个明显问题:
- 响应速度明显变慢:思考模式会让每次响应变得迟缓,对简单任务而言完全没有必要。
- 兼容性存在隐患:在 Agent 或工具循环执行过程中,LangChain 对思考模式的兼容尚不完善,容易因「丢失 thinking 参数」而抛出各类错误。
链式思维(Chain-of-Thought)推理的技术原理
链式思维推理(Chain-of-Thought Reasoning,CoT)由 Google Brain 团队于 2022 年的论文《Chain-of-Thought Prompting Elicits Reasoning in Large Language Models》中正式提出并系统验证。其核心发现是:当模型在生成最终答案前先输出中间推理步骤时,在复杂数学运算、多步逻辑推理等任务上的准确率能大幅提升——因为每一步输出的文字本身会成为后续推理的上下文,引导模型"按步骤思考"而非直接跳跃到结论。DeepSeek-R1 系列将 CoT 进一步内化为训练目标:通过大规模强化学习(GRPO 算法),使模型自发学会在
<think>标签内产生结构化推理链,再从中提炼最终答案。然而,这种额外的 token 输出流(
thinking_tokens)在 LangChain 的 Agent 框架中会打断标准的 JSON 工具调用解析流程。Agent 框架以 ReAct(Reasoning + Acting)范式运行——这一范式由普林斯顿大学与 Google Brain 于 2022 年联合提出,核心思想是让模型交替执行"推理(Reasoning)"与"行动(Acting)"两个阶段:推理阶段产生对当前情境的分析,行动阶段则输出严格符合tool_calls格式的 JSON 以驱动工具调用。当 DeepSeek 的 CoT 内容插入这一循环时,<think>标签内的推理文本会与tool_callsJSON 混杂在同一响应中,使解析器无法正确提取工具调用指令,进而触发异常并中断整个 Agent 循环。因此,对于不依赖深度推理的任务(如信息提取、文档分类、问答路由),显式关闭思考模式是兼顾稳定性与响应速度的最优实践。
因此,创建模型时建议显式关闭思考模式:
llm = init_chat_model(
    model="deepseek-v3-pro",
    model_provider="deepseek",
    api_key=deepseek_api_key,
    base_url=deepseek_base_url,
    extra_body={"thinking": {"type": "disabled"}}
)
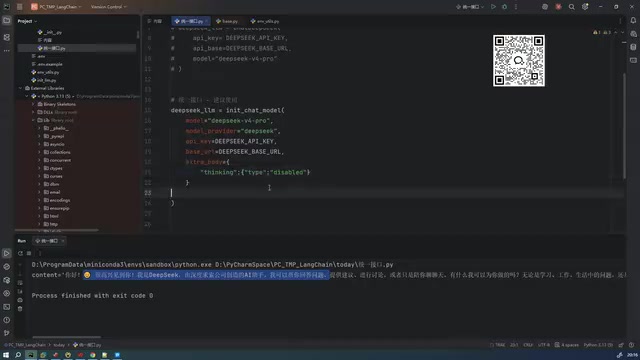
单轮对话时思考模式影响尚小,但一旦进入 Agent 多轮循环,禁用它能让整个流程更稳定、更高效。
AI 应用如何与现有业务结合
很多开发者会有一个困惑:学了大模型,是否意味着要抛弃原有技能栈?答案恰恰相反。AI 能力应被看作现有技术的扩展,而非独立割裂的新方向。
无论你从事 Java 后端、前端、测试还是数据分析,AI 应用都不是孤立存在的,它一定服务于具体业务:前端可以嵌入智能客服对话,后端可以承载 AI 功能开发,测试与数据分析同样能与 AI 结合来提升效率。
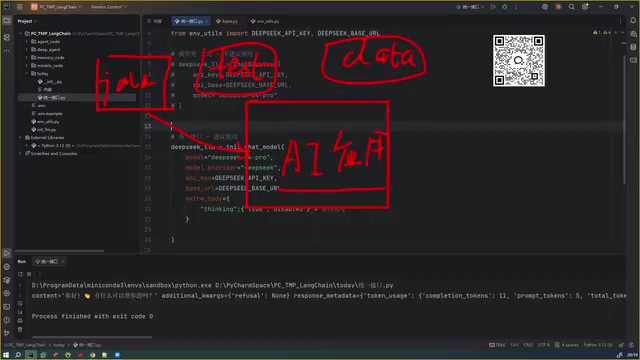
一个真实案例:某手机 APP 中的智能文档排版功能,表面上是 Python 处理排版,背后实则大量依赖 AI Agent。例如识别文档中的作者信息、区分标题与副标题、判别「图题/图注/表题/表注/图解」这些高度相似的内容——这些任务依靠传统规则代码几乎无法准确完成,必须结合上下文由 AI Agent 理解和处理,最终将杂乱无序的学术文档输出为标准化格式。
这正揭示了 AI Agent 相较于传统代码的核心优势:传统规则代码依赖显式的 if-else 逻辑和正则表达式,在面对自然语言的语义歧义时天然失效。这一现象在工程界被称为**"规则爆炸"(Rule Explosion)**——当输入空间的语义变化足够丰富时,覆盖所有边界情况所需的规则数量会呈指数级增长,最终导致系统难以维护、召回率极低。以"图注"识别为例,它可能出现在图的下方、右侧或嵌入正文段落中,且可能以"注:"、"来源:"、"图X:"等多种形式呈现,仅凭正则表达式几乎不可能穷举所有变体。
"规则爆炸"问题与 AI Agent 的结构化输出能力
AI Agent 的解决之道,是通过大模型预训练阶段习得的语义表征,将表面形式多样的自然语言片段映射到统一的语义类别空间,再结合结构化输出技术(如 JSON Schema 约束、Pydantic 模型校验)将语义理解结果转换为下游系统可直接消费的标准格式。"图注"与"图题"在字面上极为相似,但语义和排版规则截然不同,只有理解上下文的 AI 才能可靠区分。这种"语义理解 + 结构化输出"的组合,正是 AI Agent 在文档处理、信息抽取、内容分类等场景中相较于传统规则系统的核心竞争力所在。
值得深入了解的是,Pydantic 在这一组合中扮演着至关重要的角色。Pydantic 是 Python 生态中最主流的数据验证库,它通过 Python 类型注解(Type Hints)定义数据结构的 Schema,并在运行时进行严格的类型验证与自动转换。在 LangChain 中,
with_structured_output()方法接受一个 Pydantic 模型类作为输入,框架会自动将其转换为 JSON Schema 并注入到模型提示词或 Function Calling 参数中,引导模型严格按照预定义结构输出内容,最终返回经过验证的 Pydantic 对象。这一机制将"自然语言理解"与"强类型数据约束"无缝桥接,使 AI 输出的不确定性在进入下游业务逻辑前得到有效约束,是构建生产级 AI 应用的关键工程实践。
这个例子说明:AI 应用开发的真正价值,往往藏在那些「看似简单、实则充满语义理解难点」的业务场景之中。
小结
本教程从 LangChain 的定位出发,系统梳理了环境配置、两种模型创建方式的取舍,以及 DeepSeek 思考模式这一实战坑点。对于初学者来说,优先使用 init_chat_model 统一接口、关闭 DeepSeek 思考模式是两条可以立即落地的黄金实践。
在此基础上,逐步深入的学习路径大致如下:掌握 LCEL 管道组合能力后,便可构建具备工具调用能力的 AI Agent(基于 ReAct 范式的推理-行动循环);结合向量数据库与文档检索,则能搭建 RAG 知识库(检索增强生成,使模型具备访问私有知识的能力)。
RAG 技术的工作原理与工程价值
RAG(Retrieval-Augmented Generation,检索增强生成)由 Meta AI Research 于 2020 年在论文《Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks》中正式提出,其核心洞见在于:将"知识存储"与"语言生成"解耦——知识不必全部编码进模型权重,而是存储在外部的向量数据库(如 Chroma、Faiss、Pinecone、Weaviate)中,在推理时动态检索相关片段拼入上下文。具体流程是:首先将文档切片(Chunking)并通过嵌入模型(Embedding Model)转换为高维向量存入向量数据库;用户提问时,同样将问题转为向量并执行近似最近邻搜索(ANN Search),取回语义最相关的文档片段;最后将检索结果与原始问题一同注入 LLM 的提示词,由模型基于这些"现场证据"生成答案。RAG 的工程价值体现在三个维度:知识可实时更新(无需重训模型)、答案可溯源验证(可标注参考文档)、幻觉率可显著降低(有据可查时模型编造的概率大幅下降)。这三点恰好击中了企业将大模型落地于内部知识库场景时的核心痛点,使 RAG 成为目前最主流的企业级 AI 应用架构之一。
RAG 是目前将大模型落地于企业内部数据场景的主流技术路径,其核心思想是将"记忆"从模型权重剥离到可独立更新的向量数据库中,使知识更新无需重新训练模型。两者结合,便能构建出真正服务于业务的 AI 应用。
核心要点
- 使用
init_chat_model而非供应商专属模型类,确保与 LCEL 管道的完整兼容性 - 关闭 DeepSeek 思考模式(
extra_body={"thinking": {"type": "disabled"}}),避免 Agent 工具调用解析失败 .env文件 +.gitignore是密钥管理的基础实践,生产环境应升级至专业密钥管理服务- OpenAI 协议兼容性是选择国内模型供应商时的重要参考指标,兼容协议意味着零迁移成本
- AI 能力是现有技能栈的扩展,而非替代——AI Agent 的价值在于攻克传统规则代码无法处理的语义理解难题
相关推荐
Vibe Coding是什么?程序员必须掌握的AI编程能力
Vibe Coding(AI编程)到底是什么?本文解析AI编程如何重塑研发流程、为何传统程序员面临淘汰、Cursor与Claude Code两大工具,以及程序员、PM、运营等岗位为何都该掌握这项能力。
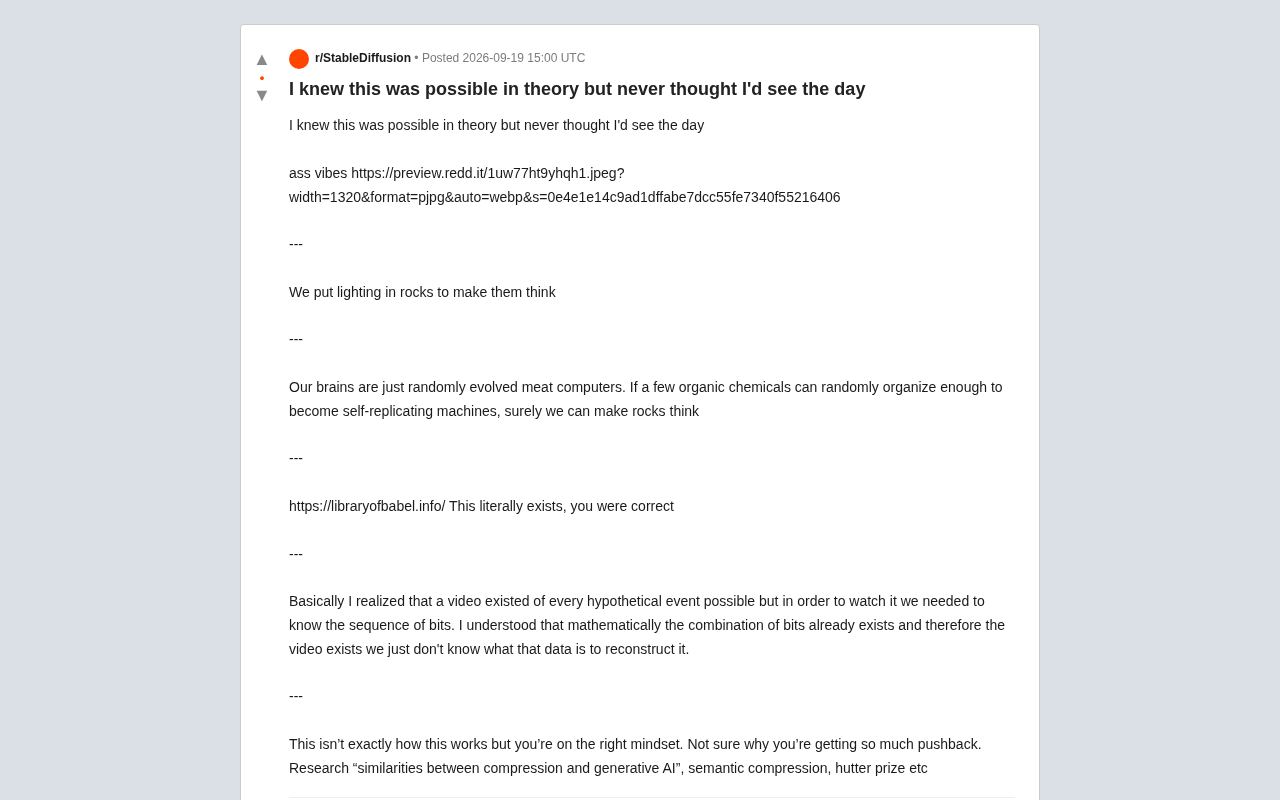
让石头思考:生成式AI与信息压缩的哲学思考
从Reddit热帖「让石头思考」出发,探讨生成式AI的信息论本质:为何压缩等价于理解,巴别图书馆式的可能性空间思辨,以及语义压缩、Hutter Prize与AI原理的深层联系。
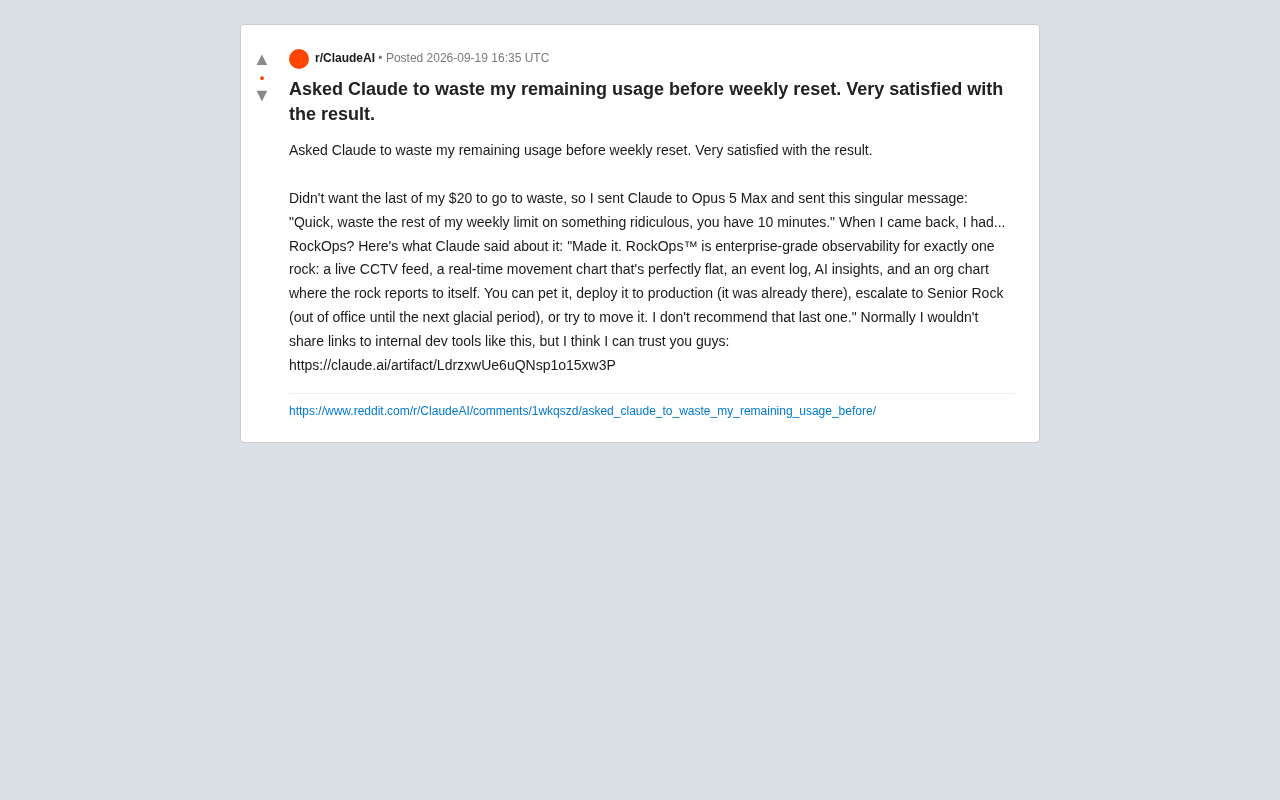
让Claude"浪费"额度:一场AI创造力的意外实验
一位Reddit用户让Claude用剩余额度"做件荒唐的事",结果AI生成了监控一块石头的企业级平台RockOps。本文分析这一趣味案例背后的AI创造力与产品设计能力。