LangChain Core 1.6.8 发布:修复 IPv6 SSRF 安全漏洞

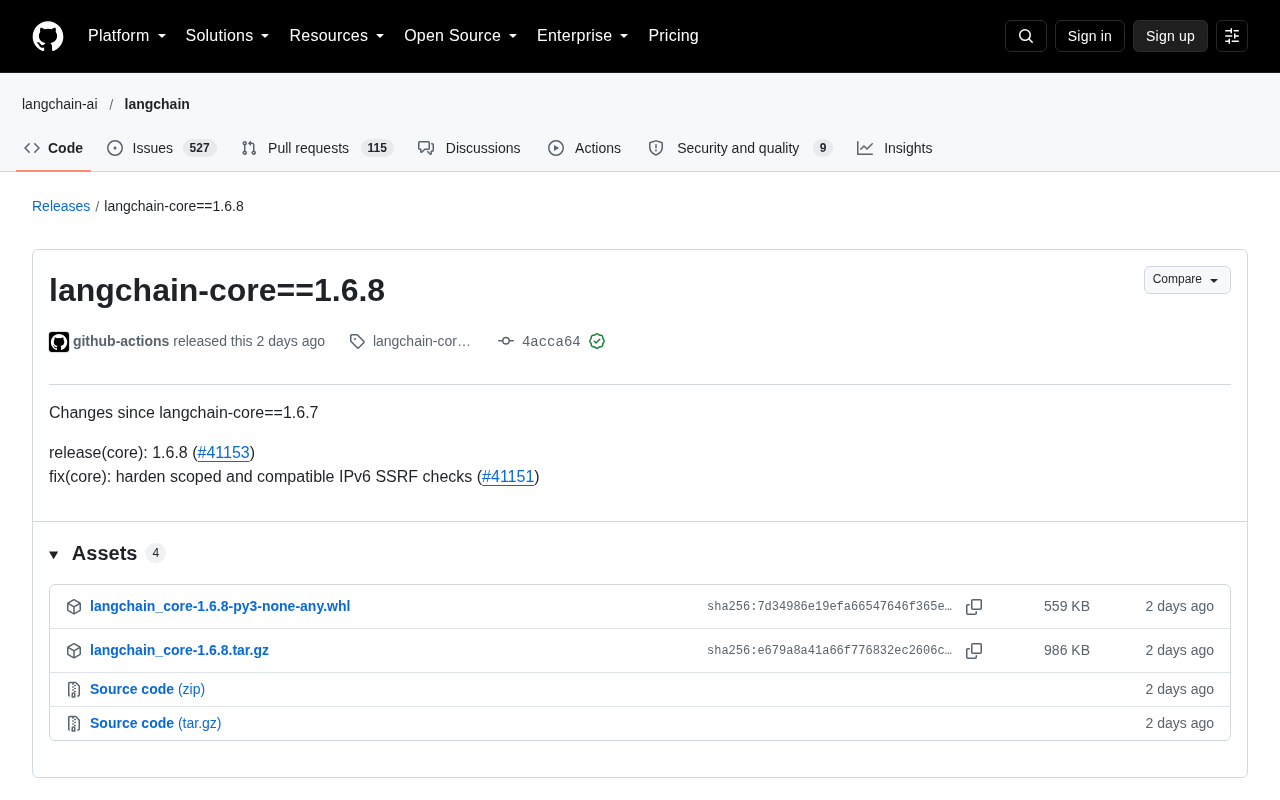
langchain-core 1.6.8 发布,核心修复为加固 IPv6 地址的 SSRF 检查,建议开发者尽快升级。
LangChain 核心组件 `langchain-core` 发布了 1.6.8 安全补丁版本,核心改动为加固了 scoped 与 IPv4-compatible/IPv4-mapped 等特殊 IPv6 地址格式的 SSRF 防护(PR #41151)。SSRF 攻击可诱导服务端访问内网资源或云元数据接口,而 IPv6 的多种等价地址写法容易绕过仅针对 IPv4 的黑名单校验,使得此类防护盲区长期被忽视。由于 LangChain 应用普遍涉及远程 URL 加载、网页抓取、Agent 工具调用等场景,底层地址校验的疏漏会直接扩大攻击面。此次修复下沉至核心库层面,所有依赖 `langchain-core` 的上层应用均可自动受益。建议开发者通过 `pip install -U langchain-core==1.6.8` 尽快升级。
LangChain Core 迎来安全修复版本
LangChain 生态的核心组件 langchain-core 发布了 1.6.8 版本。这是一个以安全加固为主的小版本更新,由 GitHub Actions 自动发布流程签名并通过 GitHub 验证签名(GPG key ID: B5690EEEBB952194),确保了发布包的可信度。
对于构建生产级 AI 应用的开发者来说,langchain-core 是整个 LangChain 技术栈的底层基础,承载了消息抽象、Runnable 接口、回调机制等关键能力。因此,即便是补丁级别的更新,也值得团队及时关注与跟进。
核心变更:加固 IPv6 的 SSRF 防护
相较于上一个版本 1.6.7,本次更新的核心改动是一项安全修复(PR #41151):加固了作用域(scoped)与兼容性(compatible)IPv6 地址的 SSRF 检查。
SSRF(Server-Side Request Forgery,服务端请求伪造)是一类常见且危害严重的 Web 安全问题。攻击者通过构造特殊的请求地址,诱导服务端向内部网络或非预期目标发起请求,从而探测内网、访问受限资源甚至发起进一步攻击。
在 IPv6 场景下,攻击面变得更加复杂。IPv6 存在多种地址表示形式,包括:
- Scoped 地址:带有区域标识符(zone ID)的地址,如
fe80::1%eth0 - IPv4-compatible / IPv4-mapped 地址:将 IPv4 嵌入 IPv6 表示的地址,如
::ffff:127.0.0.1
这些特殊写法容易绕过只针对 IPv4 或标准 IPv6 格式的黑名单校验。本次修复正是针对这些边界情况进行了更严格的检查,收窄了潜在的 SSRF 绕过路径。
SSRF 攻击在大模型应用中尤为值得警惕。传统 Web 应用中,SSRF 的典型利用方式包括:通过访问 http://169.254.169.254(AWS EC2 元数据服务地址)窃取云实例的临时凭证,或探测内网数据库、Redis、Elasticsearch 等未对外暴露的服务。在 LangChain 这类 AI 应用框架中,文档加载器(Document Loader)、网页抓取工具、以及允许 LLM 自主调用 URL 的 Agent 工具链,都是潜在的 SSRF 入口。
针对 IPv6 的 SSRF 绕过之所以危险,在于 IPv6 提供了多种等价写法来表示同一个地址。以本地回环地址 127.0.0.1 为例,在 IPv6 中可写作 ::1(纯 IPv6 格式)、::ffff:127.0.0.1(IPv4-mapped 格式)或 0000:0000:0000:0000:0000:ffff:7f00:0001(完整展开式)等形式。如果防护逻辑只匹配字符串层面的黑名单,而未对地址进行规范化解析,攻击者便可轻易绕过校验。Scoped 地址中的区域标识符(%eth0 部分)在某些解析库中会导致地址解析行为不一致,同样是被利用的已知手法。
为何这类修复值得重视
LangChain 应用常常需要加载远程资源、调用外部 API 或处理用户提供的 URL(例如网页抓取、文档加载器、工具调用等场景)。一旦底层对地址的校验存在疏漏,恶意用户就可能借助大模型应用这一入口触达内部服务。
IPv6 相关的 SSRF 绕过尤其隐蔽,因为许多开发者在编写防护逻辑时只覆盖了直观的 IPv4 情况,忽略了 IPv6 的多种等价表示。将这类检查下沉到 langchain-core 层面统一处理,意味着所有依赖该核心库的上层应用都能自动获得这份防护,无需各自重复实现。
将安全校验下沉至 langchain-core 这一基础层,体现的是「纵深防御」(Defense in Depth)的安全设计原则——即在系统的多个层次分别部署独立的防护机制,使得任何单一层面的疏漏不会直接导致全局失守。与之对应的反模式是「边界安全」思维,即只依赖最外层的防火墙或 WAF 拦截恶意请求,一旦攻击者绕过边界,内部便毫无防护。对于 LangChain 这样被广泛复用的基础库而言,在核心层统一实现 SSRF 防护,比要求每个上层应用开发者各自正确实现,在安全覆盖面和一致性上都更有保障。
升级建议
由于本次更新属于安全补丁,建议使用 LangChain 的开发者尽快升级到 1.6.8。升级方式简单直接:
pip install -U langchain-core==1.6.8
对于版本敏感的生产环境,升级前仍建议:
- 查阅官方完整的 changelog,确认没有其他潜在的行为变更
- 在测试环境验证现有功能,特别是涉及网络请求与 URL 处理的模块
- 若使用了锁定依赖版本的方案(如
requirements.txt或poetry.lock),同步更新对应约束
小结
langchain-core==1.6.8 虽是一次体量很小的更新,但其安全价值不容忽视。IPv6 的 SSRF 防护加固提醒我们,AI 应用的安全不仅在于模型层面的 Prompt 注入防御,底层基础库对网络请求的严格校验同样是不可或缺的一环。保持核心依赖的及时更新,是保障 LangChain 应用安全运行的基础实践。
相关推荐

iPhone Duo上手体验:2000美元的小屏折叠,值不值?
YouTube博主Allison分享iPhone Duo上手体验:双屏多任务效率翻倍,视频观看体验出色,磨砂质感好评,但机身偏厚、单屏操作偏小,2000美元定价进入MacBook区间,属于奢侈品定位。

Sentry广告笑疯开发者:On-call也能变有趣?
Sentry广告短片以开发者On-call焦虑为切入点,用幽默对话展示其将错误、日志、链路、指标、录屏和发布记录集中一处的可观测性能力,引发开发者社区共鸣。
LLM应用越改越糟?三步构建有效评估体系
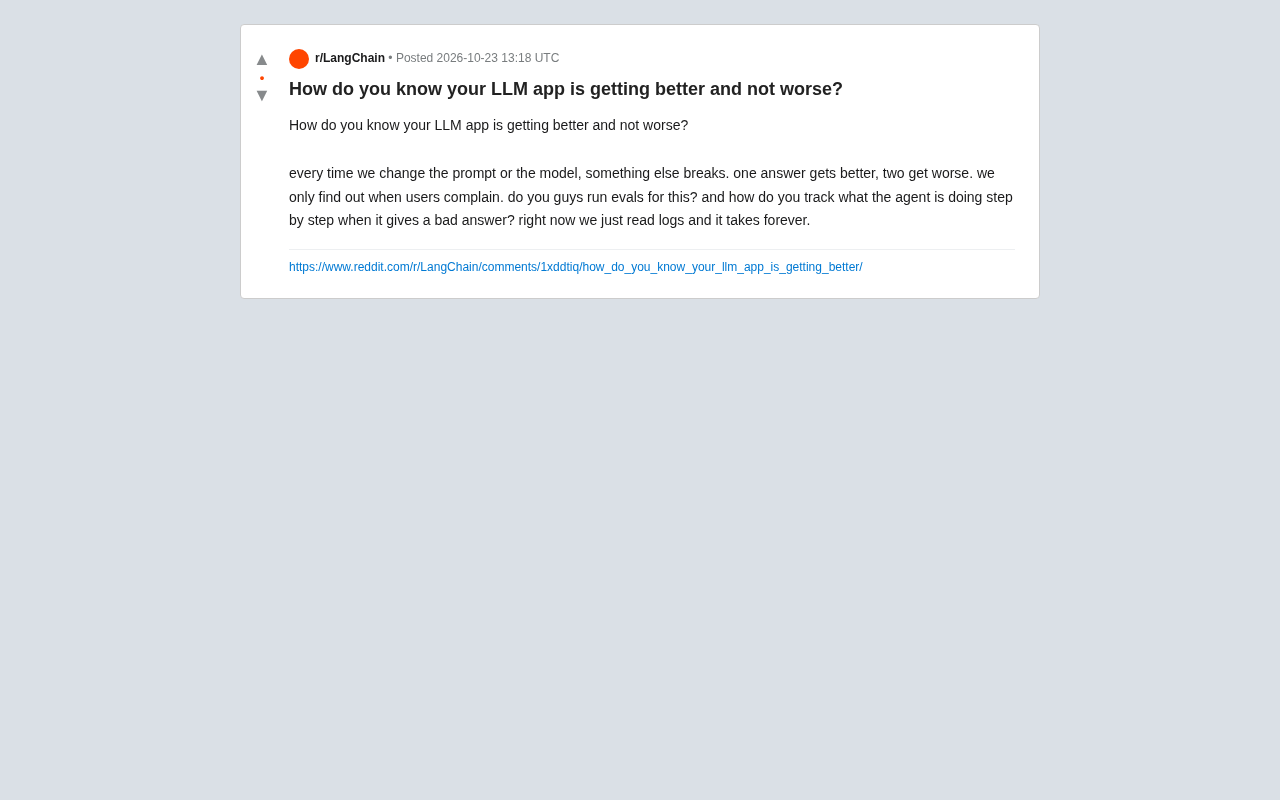
LLM应用迭代时如何判断变好还是变坏?本文基于Reddit开发者讨论,详解构建测试集、自动化回归评估、LLM-as-judge评分与结构化追踪智能体行为,建立从生产反馈到评估追踪的持续闭环。