LangChain-Fireworks 1.6.3 发布:工具调用与PDF支持更新解读

langchain-fireworks 1.6.3 发布,修复工具调用诊断与PDF输入声明问题,刷新模型配置元数据。
langchain-fireworks 1.6.3 是一次聚焦稳定性的维护性小版本,包含三项修复与一项数据刷新。核心变化包括:明确将原生 PDF 输入标注为不支持,使框架能在更早阶段给出清晰反馈,避免隐性运行时失败;当模型返回格式有误的工具调用参数时,新版本将保留原始异常数据为诊断 JSON,显著提升 Agent 场景下的可观测性与调试效率;此外还同步刷新了 Fireworks 平台的模型 profile 元数据,确保上下文长度、工具调用支持等能力声明与平台现状一致。得益于 LangChain 独立发包的集成策略,此类修复可快速推送给用户,升级成本极低,建议依赖工具调用或 Agent 功能的团队优先跟进。
LangChain 生态下的 Fireworks 集成包迎来 1.6.3 版本更新。作为连接 LangChain 框架与 Fireworks AI 推理平台的桥梁,这次发布虽然是一个小版本迭代,却对工具调用的健壮性和输入类型声明做了几处务实的修正。对于依赖该集成构建生产级 LLM 应用的开发者来说,这些变化值得关注。
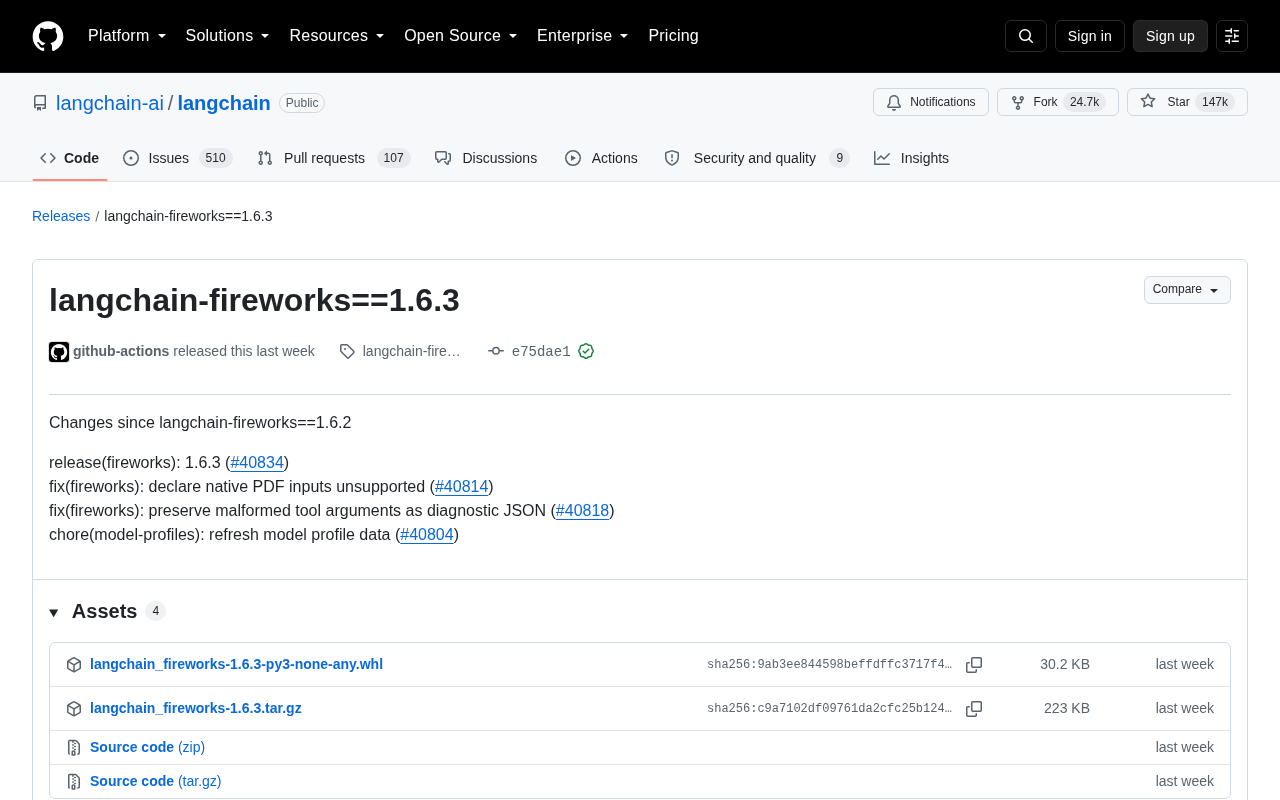
本次更新的核心变化
langchain-fireworks==1.6.3 相较于上一个版本 1.6.2,主要包含三项针对性修复和一项数据刷新。版本由 GitHub Actions 自动构建并通过 GitHub 验证签名发布,保证了分发链路的完整性。
从提交记录来看,这不是一次引入新特性的大更新,而是典型的「补洞」型版本。每一项改动都对应着实际使用中暴露出的边界问题,体现了 LangChain 团队在模型集成层持续打磨稳定性的思路。
明确声明不支持原生 PDF 输入
其中一项修复(#40814)将 Fireworks 的原生 PDF 输入标注为「不支持」。这看似是一个「减法」,但对开发者而言反而是好事——此前如果开发者误以为可以直接向 Fireworks 模型传入 PDF 文件,可能会遇到难以排查的隐性失败。
明确声明不支持,意味着框架会在更早的阶段给出清晰反馈,而不是让错误在运行时以模糊的形式出现。这种「把能力边界说清楚」的做法,在多模态输入日益复杂的当下尤为重要。需要处理 PDF 的用户应当在应用层先做好文本提取或分页转换,再将内容交给模型。
保留异常工具参数作为诊断信息
另一项修复(#40818)处理了工具调用中的一个细节:当模型返回的工具参数格式有误(malformed)时,新版本会将这些异常参数保留为诊断用的 JSON,而不是直接丢弃或抛出不可读的错误。
这对调试 Agent 和函数调用场景非常有价值。工具调用是现代 LLM 应用的核心能力之一,但模型并不总能生成完全合规的参数结构。保留原始的错误数据,让开发者能够看到模型到底输出了什么,从而定位是提示词问题、模型能力问题,还是解析逻辑问题。这体现了对可观测性的重视。
工具调用(Tool Calling / Function Calling)是指 LLM 在生成回复时,输出一段结构化的指令,告知宿主程序调用某个预定义函数并传入特定参数,而非直接给出自然语言答案。这一机制是构建 Agent、自动化工作流和检索增强应用的基础。然而,LLM 本质上是生成概率分布的模型,即便经过指令微调,也可能在高复杂度场景下输出不完全符合 JSON Schema 规范的参数——例如字段缺失、类型错误或结构嵌套有误。如果框架在遇到此类情况时直接静默丢弃或抛出难以溯源的异常,开发者无从判断问题根因。将异常参数序列化为原始 JSON 保留下来,实质上是在调用链路中引入了一个「快照」机制,使得事后分析和提示词迭代都有据可查。
模型配置数据的常态化刷新
本次还包含一项 chore(model-profiles) 的改动(#40804),刷新了模型 profile 数据。模型 profile 通常记录了各个模型支持的上下文长度、是否支持工具调用、是否支持视觉输入等元信息。
随着 Fireworks 平台不断上线新模型、调整现有模型的能力参数,这类元数据需要定期同步。虽然这类改动不会直接影响 API 调用方式,但它决定了 LangChain 在运行时如何判断某个模型能做什么、不能做什么,是保证上层抽象正确工作的基础。
模型 Profile(模型档案)是 LangChain 集成层维护的一份元数据清单,通常以结构化配置文件的形式存储,记录每个模型 ID 所对应的能力边界:最大上下文窗口(context window)、是否支持工具调用(tool use)、是否接受图像或音频输入、输出 token 的速率限制等。框架在实际路由请求、校验输入格式或自动选择降级策略时,都会查询这份元数据。若 profile 数据过时——例如某模型已扩展至 128K 上下文,但 profile 仍标注为 32K——上层代码可能会做出错误的分块或截断决策。因此,即便 profile 刷新不改变任何 API 接口,它对应用行为的影响依然是实质性的,属于不可忽视的基础设施维护。
对开发者的实际意义
LangChain 当前在 GitHub 上拥有超过 14.7 万 Star 和 2.47 万 Fork,是 LLM 应用开发领域影响力最大的框架之一。其模块化的集成策略——将每家模型厂商的适配拆分为独立的包(如 langchain-fireworks)——让各集成可以独立迭代、独立发版,不必等待主框架的大版本节奏。
1.6.3 这样的小版本正是这种策略的受益者:一个工具参数解析的 bug 修复可以在几天内发布到用户手中,而不必捆绑进庞大的发布周期。对于正在使用 Fireworks 作为推理后端的团队,建议:
- 涉及工具调用 / Agent 的项目优先升级,以获得更友好的错误诊断;
- 若此前尝试过 PDF 原生输入,需调整为应用层预处理方案;
- 关注 model-profiles 更新,确认所用模型的能力声明是否有变化。
整体而言,这是一次低风险、高性价比的维护性更新,升级成本极低,建议相关用户纳入日常依赖更新。
相关推荐

英伟达3万开发者用Cursor,代码提交量增3倍
Cursor现场工程师拆解企业AI编程从试点到规模化之间的五个缺口:战略清晰度、风险分级、治理审计、业务度量与运营战略。英伟达3万开发者每日使用Cursor,代码提交量增至3倍且缺陷率持平,关键在于重写SDLC而非叠加工具。

Ponytail:给AI编码代理装上资深工程师思维
Ponytail 是一个 GitHub 免费工具,为 AI 编码代理注入资深工程师思维,让 AI 先问代码是否必要。据 TamilDeck 介绍,它可将 AI 生成的 200 行代码压缩到 30 行,降低 token 成本,支持 Cursor rules 与 Claude Code skill 接入,但安全审查仍需人工把关。

Cursor AI 接入 GitHub MCP 服务器完整指南
手把手教你将 Cursor AI 接入 GitHub MCP 服务器:创建个人访问令牌、配置 mcp.json、用 ENV 块安全管理 token,并通过查询 PR 验证连接是否生效。