LangChain-Fireworks 1.7.0 发布:新增提示词缓存中间件

langchain-fireworks 1.7.0 新增提示词缓存中间件,并修复流式超时分类问题,兼顾降本与稳定性。
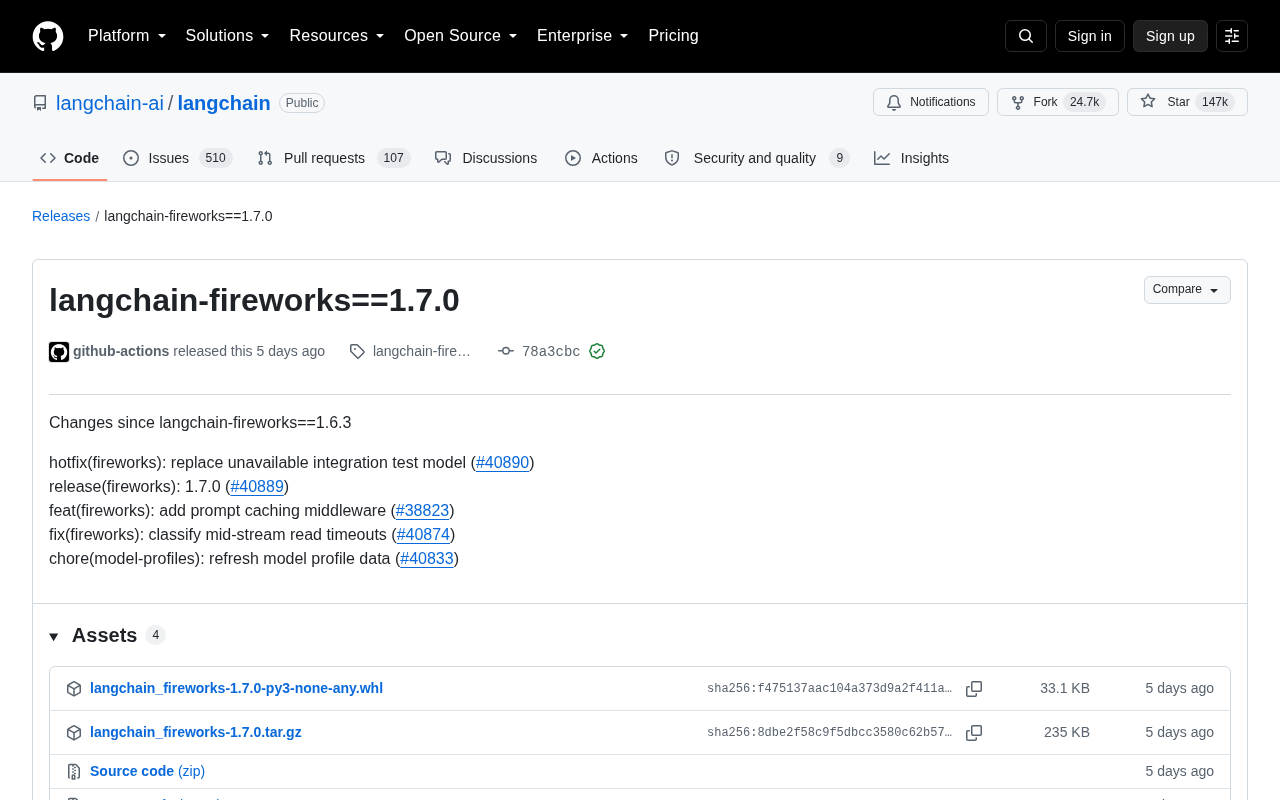
langchain-fireworks 1.7.0 是 LangChain 官方 Fireworks AI 集成模块的一次兼顾功能与稳定性的常规迭代。核心新增是提示词缓存中间件(PR #38823),通过复用相同前缀(系统提示、固定上下文等)的推理 KV Cache,显著降低高频调用场景下的延迟与 token 成本,且以中间件形式接入无需改造业务逻辑。稳定性层面,本版本修复了流式输出中途读取超时的分类逻辑,使错误处理与重试策略更为精准;同时通过热修复替换了集成测试中已失效的模型,并刷新了内置模型配置元数据。版本遵循语义化版本规范,属于向后兼容的小版本升级,建议依赖流式响应或高频调用固定上下文的团队优先升级。
LangChain 生态中的 Fireworks 集成包迎来 1.7.0 版本更新。这个由 GitHub Actions 自动发布的版本带来了提示词缓存(prompt caching)中间件、流式超时分类改进以及模型配置数据的刷新。对于依赖 Fireworks AI 推理服务的 LangChain 开发者来说,这次更新在性能优化和稳定性层面都有实际价值。
版本更新概览
langchain-fireworks 是 LangChain 官方维护的集成模块,用于连接 Fireworks AI 提供的大模型推理服务。作为 LangChain 这一拥有超过 14.7 万 Star、2.47 万 Fork 的头部开源项目的组成部分,它的每次迭代都会被大量生产环境所采用。
本次 1.7.0 相对于上一个稳定版 1.6.3,合并了多个关键提交,涵盖新功能、缺陷修复与维护性改动三类变更。版本由 github-actions 机器人自动构建并通过 GitHub 的 verified signature 签名发布,保证了分发链路的可信度。
核心亮点:提示词缓存中间件
本次更新中最值得关注的是新增的提示词缓存中间件(prompt caching middleware,PR #38823)。提示词缓存是近年来大模型应用降本增效的重要手段——当应用反复发送带有相同前缀(如系统提示、固定上下文、few-shot 示例)的请求时,缓存机制可以复用已处理过的部分,从而显著降低延迟并减少重复计算带来的 token 成本。
对于构建 RAG 系统、Agent 工作流或多轮对话应用的开发者而言,这类场景极为常见。将缓存能力以中间件形式集成进 Fireworks 调用链,意味着开发者可以较为无侵入地启用该优化,而不必手动改造请求逻辑。
提示词缓存的实现原理通常依赖 KV Cache(键值缓存)技术:Transformer 模型在处理输入时会为每个 token 计算注意力机制所需的 Key 和 Value 矩阵,如果相同前缀的 token 序列在多次请求间被缓存下来,推理引擎便可跳过对这部分的重复计算,直接从缓存中读取。Anthropic 的 Claude 和 Google 的 Gemini 均已在 API 层面提供类似能力,按缓存命中与未命中分别计费,命中时 token 费用可降低 50%–90%。Fireworks AI 作为专注推理加速的平台,将该能力以中间件形式暴露给 LangChain 调用链,开发者无需更改业务逻辑即可受益,尤其适合系统提示词较长(如包含大段工具描述或 RAG 检索结果)的场景。
稳定性与维护性改进
除了新功能,本次版本还包含两项针对可靠性的改动。其一是修复了流式输出中途读取超时的分类逻辑(PR #40874)——此前中途发生的 read timeout 可能无法被正确归类,影响错误处理与重试策略。此次将 mid-stream read timeout 明确分类,有助于上层应用更精准地捕获和响应网络异常。
其二是一个热修复(hotfix,PR #40890),替换了集成测试中已不可用的模型。这类改动虽然对最终用户不直接可见,但保障了持续集成流水线的健康运行,是开源项目长期维护质量的体现。
此外,版本还刷新了模型配置数据(model-profiles,PR #40833),使框架内置的模型元信息与 Fireworks 平台当前可用模型保持同步。
流式输出(streaming)场景下的超时分类之所以复杂,是因为 HTTP 连接在不同阶段可能发生不同类型的超时:连接建立阶段的 connect timeout、等待首个响应字节的 response timeout,以及已开始接收数据后数据包迟迟未到达的 read timeout。对于非流式请求,这三类超时语义较为清晰;但流式请求会长时间保持连接并持续接收分块数据(chunked transfer),mid-stream read timeout 在部分 HTTP 客户端库中可能被错误归类为通用网络错误,导致上层重试逻辑无法区分"服务器尚未响应"与"响应中途中断"这两种截然不同的失败模式,进而采取不合适的重试策略。此次修复明确了该分类,使开发者可以针对中途中断单独设置重试规则。
对开发者的实际意义
这次更新整体上是一次兼顾功能增强与稳定性的常规迭代。提示词缓存是面向成本敏感型生产场景的实用能力,建议高频调用固定上下文的团队重点关注;流式超时分类的修复则对依赖流式响应的实时应用更有意义。
升级方式与 LangChain 其他集成包一致,通过包管理器指定版本即可。由于版本号从 1.6.x 跨到 1.7.0,遵循语义化版本规范属于新增向后兼容功能的小版本升级,一般不涉及破坏性变更,但仍建议在升级前查阅完整变更日志并在测试环境验证。
相关推荐

uGAP:统一100+非洲地理数据集的AI平台
uGAP是开普敦大学团队开发的非洲地理空间AI平台,统一120余个非洲数据集并提供Python SDK,支持数据发现、处理与模型训练一站式工作流,已用于气旋洪水制图等实战场景。

Cursor能控制你的电脑了:AI代理可驱动桌面应用测试
Cursor 新增桌面控制能力,AI 代理可驱动 iOS 模拟器等桌面应用测试自己构建的功能。本文分析这一更新对开发工作流的影响、技术实现可能路径及可靠性考量。

Vibecoding自研推理引擎:理想丰满,现实骨感
Reddit开发者分享Vibecoding自研推理引擎的真实经历:用WebGL2和GLSL在浏览器跑GGUF Q4模型,却陷入tokenizer调试地狱。本文分析浏览器端LLM推理的工程难点,以及为何直接clone llama.cpp是更理性的选择。