LangChain4j实战:用AI Coding Agent写前端踩坑记

AI Coding Agent 自动生成前端的实测记录:能搭骨架,难调 bug,模型能力是关键。
文章记录了用 AI Coding Agent 为 LangChain4j 流式后端自动生成前端的真实尝试。作者先以 Markdown 文档形式准备需求、技术选型、接口定义与接口代码,要求 Agent 先规划后编码。Claude Code 配合 MiniMax 3.0 顺利搭出界面骨架并完成依赖安装,但随后接连出现 API 路径 404、session ID 类型与 Integer 不匹配、数值超出 Integer 范围等连环 bug;最棘手的是后端返回 200 且数据已发出、前端却不渲染,Agent 反复修改仍无进展。作者随后换用 Cursor 的 Plan Mode 重试,模型表现出主动查阅后端代码、就契约细节提问的差异。文章由此总结三点:契约须提前对齐、Agent 擅长生成不擅长调试、模型能力差距真实存在。
在完成LangChain4j后端流式输出开发后,如何快速为后端API配一个可用的前端界面?本文记录了一次用AI Coding Agent自动生成前端的真实尝试——从Claude Code对接MiniMax模型,到切换到Cursor重试,中间踩过的坑或许比最终结果更有参考价值。
为什么选择让AI写前端
据B站UP主的教程分享,在前几个视频中,LangChain4j的streaming输出特性已经基本跑通,后端API开发大体完成。此时面临的问题很实际:后端能力有了,但缺少一个能实际交互的前端界面。
UP主的思路是不再一行行手写前端,而是依赖AI Coding Agent来完成。这种做法的前提是后端接口已经稳定、需求边界清晰——正好符合教程系列的场景。使用的工具是Claude Code,后端接入MiniMax 3.0模型。UP主也提到,模型可以替换为Kimi 2.6或Kimi 3.0等,选择MiniMax 3.0只是因为手头恰好有。
这个选择本身透露了一个信号:Coding Agent的效果高度依赖底层模型能力,工具链是其次的。
Claude Code 是 Anthropic 推出的命令行式 AI 编程代理,它能够直接读写本地文件、运行终端命令,并以“代理循环”的方式完成多步开发任务,而非仅在编辑器内补全代码。Cursor 则是基于 VS Code 二次开发的 AI 编辑器,其 Plan Mode 允许模型先输出执行计划、经用户确认后再动代码,适合需求边界尚不清晰的场景。两者虽然形态不同,但共同点是都把“模型能力”放在工具链之上:同一份需求文档,换一个底层模型,规划质量、主动查阅上下文的行为、调试时的推理深度都会明显不同。这也是原文强调“Coding Agent 选型本质是选底层模型”的技术背景。
写好Prompt的五个要素
UP主总结了一个让AI写前端的Prompt结构,包含五个部分:需求描述、技术选型(technology stack)、后端接口定义、后端接口代码,以及可选的前端UI草图。实际使用时,草图被省略,其余四项以Markdown文档形式放在前端项目目录中。
这种把需求文档化的做法值得借鉴:AI Agent读取本地文件后能获得完整上下文,而不是依赖对话中的零散描述。文档放在项目文件夹里,也方便后续切换工具时直接复用。
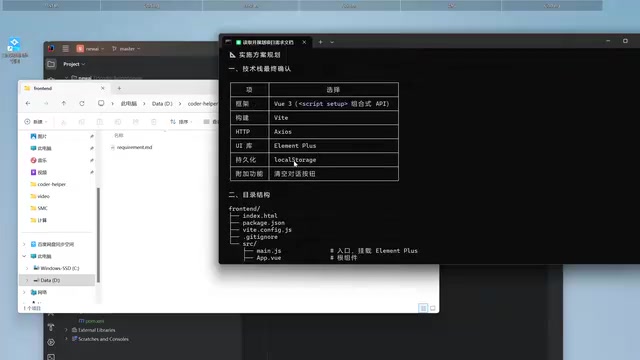
在前后端分离架构中,“接口契约”指双方对请求路径、HTTP 方法、参数类型、字段取值范围、响应结构等达成的明确约定。它通常以 OpenAPI/Swagger 文档或 TypeScript 类型定义的形式固化下来。原文中 session ID 被前端生成为长数字字符串、而后端 Controller 期望 Integer 类型的 memoryId,正是契约未对齐的典型表现。更隐蔽的是取值范围问题:即使双方都是整数,超出 Integer 的 ±21 亿区间仍会在反序列化时抛异常。把这类约束(类型、范围、是否可空、默认值)写进 requirements 文档,比在对话中口头说明更可靠,因为 Agent 读取文件时能获得稳定、完整的上下文。
Claude Code + MiniMax的第一轮尝试
启动Claude Code后,UP主首先要求它读取requirements文档理解需求,并明确指示“先不要写代码,先规划,有不确定的地方找我确认”。这个约束很关键——让Agent先出方案再动手,避免它自由发挥。
Agent随后提出了一系列需要人拍板的问题:是否使用Element UI、对话消息是否持久化(选择存到localStorage)、是否需要停止和清空对话功能(保留清空)、以及工具选型(Vite)。方案确认后,Agent开始规划并写代码,还附带了Login和Video的使用说明。
前端依赖安装(npm install)和启动(npm run dev)都顺利完成。但真正的麻烦从第一次功能测试才开始。
连环Bug:从404到类型不匹配
第一次发送消息就遇到404 not found,同时后端日志出现cookie相关的警告。把前后端错误信息一并丢给Agent后,它分析出API路径多了一段,去掉后重试。
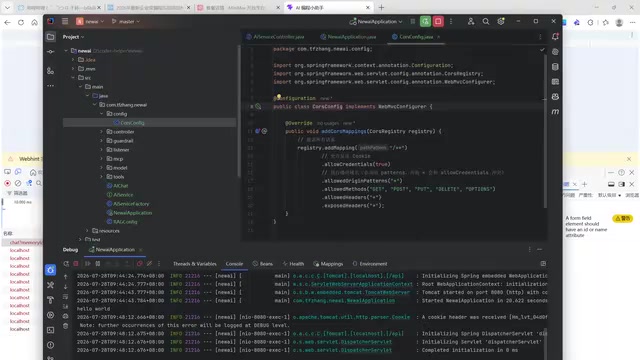
问题没有结束。再次测试时,后端抛出类型转换异常:前端生成的session ID是一长串数字(如3241开头),而后端Controller期望的是Integer类型的memoryId,字符串无法转为整形。Agent修改了前端两处生成逻辑。
紧接着又出现新问题——生成的数字超出了Integer范围。UP主在视频中坦言,这个错误其实自己应该能判断出来。Agent再次调整了数值范围,让数据落在Integer区间内。
数据到了前端却不显示
类型问题解决后,后端返回200 OK,响应数据也确实发出来了,但聊天窗口什么都不显示。UP主把“前端收到数据但无法展示”的信息反馈给Agent,多次修改后问题依旧存在。视频里UP主的评价很直接:“我们的AI好像能力也不是特别强,这个bug改了半天都改不出来。”
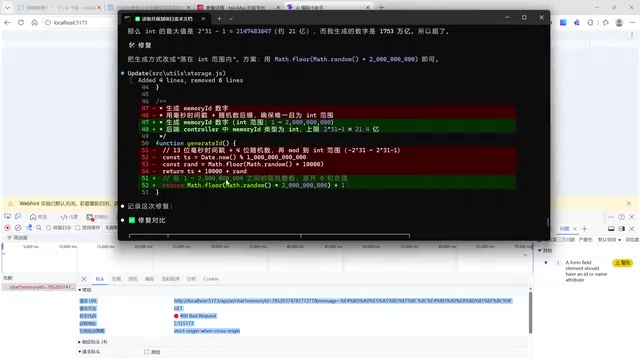
这里值得注意一个细节:UP主自己在排查时确认了后端无错误、跨域正常、数据已返回,问题被精确定位在前端的渲染或流式处理环节。这种人工缩小问题范围的能力,在AI反复失败时显得尤为重要。
流式输出(streaming)依赖 HTTP 分块传输或 SSE(Server-Sent Events),后端会持续推送增量数据块,而非一次性返回完整响应。前端若用普通 fetch 读取 response.json(),会等待整个流结束才解析,导致界面长时间空白;正确做法是读取 response.body 的 ReadableStream,逐块解码并追加到消息列表。此外,聊天场景还需要处理消息拼接、自动滚动、Markdown 增量渲染等细节。原文中“后端返回 200 且数据已发出、前端却不渲染”的现象,很可能就落在流式读取或状态更新这一层,这也是 Agent 难以仅凭错误日志定位的原因——它需要理解运行时的数据流动,而不仅是静态代码。
换用Cursor重试
由于Claude Code + MiniMax的组合在这个bug上卡住太久,UP主决定换模型——改用Cursor的免费普通版本,新建frontend2目录,复用同一份requirements文档,选择Plan Mode让Agent先规划再执行。
Cursor默认模型的表现有所不同:它会主动去父目录查找相关后端代码,同样提出了需要人工决策的问题——memory ID如何生成(选择随机整数)、流式响应使用原生fetch还是Axios(选择原生fetch以保留扩展性)、是否支持Markdown渲染、刷新后是否保留对话历史等。
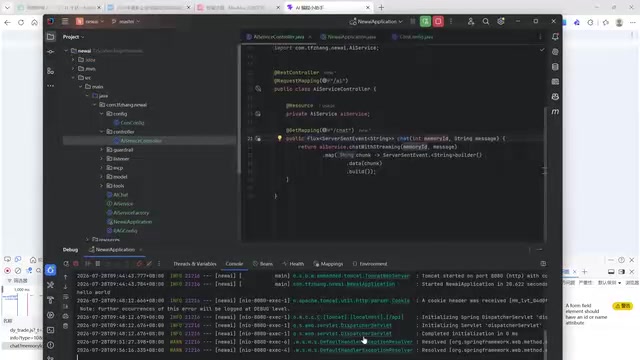
UP主提到,如果免费版能力不够,可能需要订阅更强模型。视频到此为止没有给出最终结论,Cursor能否一次跑通仍是未知数。
memoryId 是 LangChain4j 中用于区分不同会话记忆的标识符,ChatMemoryStore 依据它存取历史消息,从而让多轮对话保持上下文。它通常要求是稳定的整数或字符串,若每次请求随机生成,刷新页面后历史记忆就会丢失,因此“随机整数”只是一种简化选择。与之相关的是消息持久化策略:存 localStorage 可以让前端在刷新后恢复对话展示,但后端记忆仍由 memoryId 关联,两者需要保持一致,否则会出现“界面有记录、模型却不记得”的割裂。这些设计决策正是 Agent 在规划阶段主动向人确认的内容,也说明契约类问题越早拍板,后续返工越少。
这次踩坑暴露的三个现实问题
前后端契约必须提前对齐。 session ID的类型和取值范围这类基础约定,如果不在Prompt中明确写死,Agent生成的代码很容易与后端不匹配。教程中的两次类型错误,根源都在这里。
Agent擅长生成,不擅长调试。 从零写一个对话框界面,Claude Code完成得很快;但面对“数据到了但不渲染”这类需要理解运行时行为的问题,它的迭代效率明显下降。
模型能力的差距是真实的。 同一个需求、同一份文档,换一个模型和工具后,规划质量和主动性都有差异。UP主的经验说明,Coding Agent的选型本质上是在选底层模型。
对于准备用AI写前端的开发者,一个务实建议是:让Agent负责从0到1的骨架搭建,把契约细节写进需求文档,遇到它反复改不动的bug时,先用人工排查把问题范围压缩到最小,再决定是继续对话还是换工具。
相关推荐

推理模型14个核心概念:从思维链到GRPO全面拆解
系统拆解推理模型14个核心概念:思维链、测试时计算、验证器、RLVR与GRPO、蒸馏与reward hacking,并给出思考token的成本控制规则,帮你判断何时值得为推理付费。

OpenAI称推翻ETH引热议,Meta豪赌AI基建
OpenAI宣布AI辅助发现,预印本声称推翻指数时间假设ETH,同时推出中端模型GPT-6.1 Tera。Cloudflare披露跨客户数据泄露复盘,Meta拟融资950亿美元投入AI基建。
数据爬取、AI证明与开源契约:本周技术圈深度观察
从3D模型爬虫争议、OpenAI的Lean形式化证明,到AI智能体对Brooks定律的挑战,以及Debian对LLM审查的拒绝,本周技术圈围绕开放与可验证性展开深度讨论。