LangChain回调的盲区:Agent链外API调用如何审计
LangChain callback只能追踪链内调用,工具内直连SDK等链外操作构成审计盲区,可观测性≠可审计性。
本文揭示了在生产环境中部署 LangChain Agent 时被普遍忽视的审计盲区:callback 系统只能捕获流经链执行上下文的工具调用,而工具内部直接调用 SDK、复用缓存凭证发起的链外请求、以及与 Agent 共享 service account 的后台进程,这三类操作会留存于 Stripe、CloudTrail 等下游系统日志,却对 LangSmith trace 完全不可见。文章进而区分了两个常被混淆的概念:可观测性(observability)回答的是"链看到了什么",服务于调试与优化;而可审计性(auditability)回答的是"Agent 对真实世界做了什么",是合规层面的要求。两者之间存在结构性落差,任何把 trace 当作审计依据的做法都面临记录不完整的风险。文章最终给出了收敛调用路径、区分身份、以下游授权层日志为真相来源等实践建议。
问题的本质:回调覆盖不到的地方
LangChain 的 callback 系统在追踪流经链(chain)的工具调用方面表现稳健,LangSmith 的 trace 能清晰记录 Agent 在链执行过程中“看到”的每一步。但生产环境里跑过真实工具调用的团队会发现一个被普遍忽视的缺口:有些 API 调用根本不经过 callback 层。
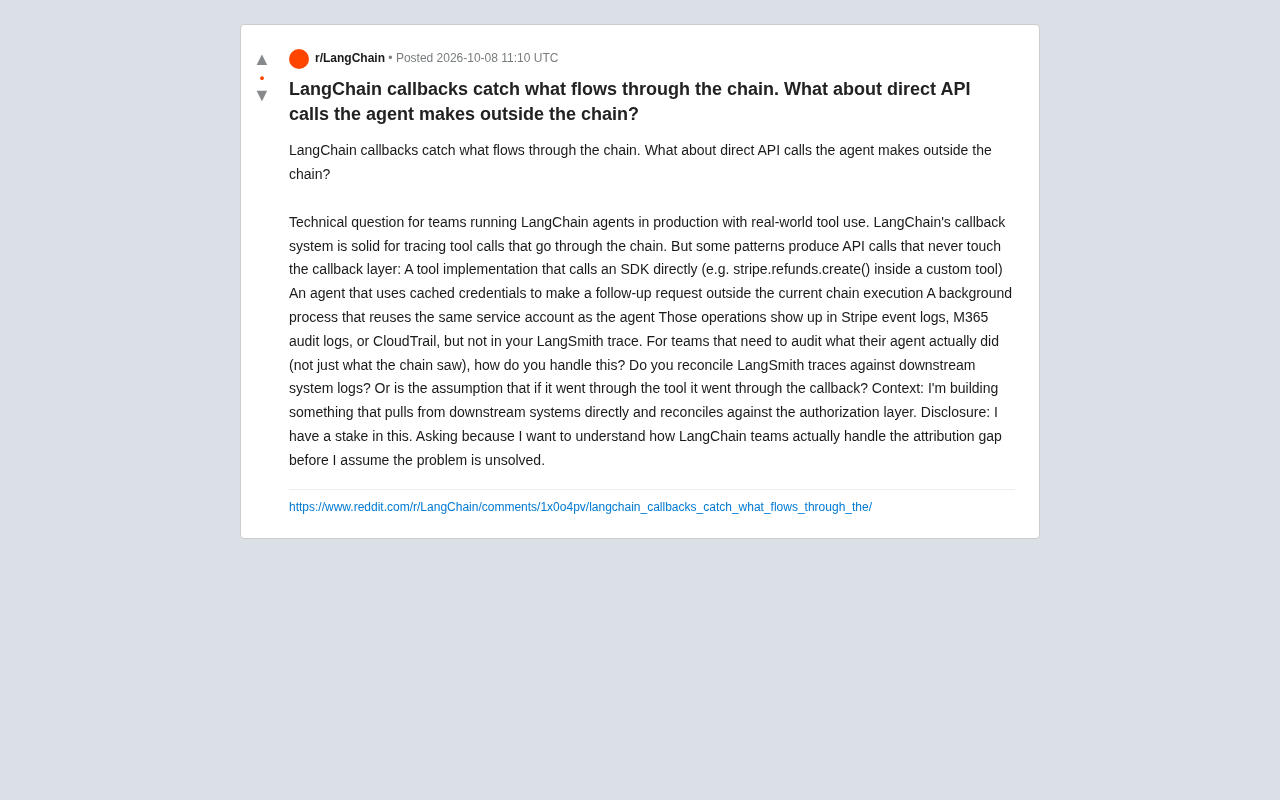
这不是理论问题。一位 Reddit 用户在社区抛出了这个相当尖锐的技术提问——当 Agent 的实际行为与可观测的 trace 之间出现落差时,你怎么知道它到底做了什么?

三种典型的“失踪”调用模式
原帖归纳了三类会绕开回调层的操作,每一类在实际部署中都很常见:
1. 工具内部直接调用 SDK
一个自定义工具的实现里,可能直接调用了类似 stripe.refunds.create() 这样的 SDK 方法。LangChain 的 callback 捕获的是“工具被调用”这个事件,但工具内部到底发起了几次下游 API 请求、调用了什么、改了什么数据,callback 并不感知。
2. 复用缓存凭证的链外请求
Agent 使用缓存的凭证,在当前链执行之外发起后续请求。这类调用脱离了链的生命周期,自然也脱离了 trace 的记录范围。
3. 共享服务账号的后台进程
一个后台进程复用了与 Agent 相同的 service account。从下游系统的视角看,这些操作与 Agent 的操作共享同一身份,难以区分责任归属。
这些操作会出现在 Stripe 的事件日志、Microsoft 365 的审计日志、或 AWS CloudTrail 里,但不会出现在你的 LangSmith trace 中。
可观测性与可审计性的分野
这个问题触及了一个被很多团队混淆的概念区别:可观测性(observability)不等于可审计性(auditability)。
LangSmith 这类工具解决的是“链看到了什么”——它服务于调试、性能分析、提示词优化。而审计要回答的是一个法务与合规层面的问题:“这个 Agent 到底对真实世界做了什么?”当 Agent 拥有调用支付、修改邮箱配置、操作云资源的权限时,这两个问题的答案可能并不一致。
一个只依赖 trace 做合规审计的团队,实际上是在用“应用层以为发生的事”来替代“系统层真实发生的事”。只要工具实现中存在任何未被 callback 包裹的调用路径,审计记录就是不完整的。
从技术架构角度看,这一分野对应两种截然不同的数据来源。LangSmith 等可观测性工具采集的是应用层遥测数据(application-level telemetry)——即链执行时主动上报的事件流,属于"推送式"记录,其完整性完全取决于 instrumentation 的覆盖范围。而真正的审计日志(audit log)要求的是系统层的被动记录:无论调用方是否愿意上报,下游系统都会在自己的边界上留下不可篡改的痕迹。合规框架(如 SOC 2、PCI DSS、ISO 27001)中对审计日志的定义通常明确要求"完整性"与"不可否认性",而依赖应用层主动上报的 trace 从定义上就无法满足这两点——任何一处未被 callback 覆盖的调用路径都构成审计漏洞。这也是为什么在金融、医疗等高监管行业,单纯依赖应用层 trace 做合规审计会被认为是不充分控制(insufficient control)的原因。
现实中的两种应对思路
原帖者(坦诚披露自己正在构建相关产品,存在利益相关)实际上是在向社区求证一个假设:这个归因缺口(attribution gap)到底是不是一个尚未被解决的真问题。从问题的提法可以归纳出两条现实路径:
路径一:相信工具即回调。 假设“只要走了工具就一定走了 callback”。这在工具实现严格受控、禁止任何链外副作用的前提下成立。但这是一个脆弱的假设——它依赖团队纪律而非技术强制,任何一个在工具里直接调 SDK 的开发者都会打破它。
路径二:对账下游系统日志。 把 LangSmith trace 与下游系统(Stripe、M365、CloudTrail)的日志做交叉比对,以授权层为基准反向核对 Agent 的实际行为。这种方式更接近真正的审计,但工程成本高:需要跨多个异构日志源做身份归因、时间对齐和事件关联。
路径二提到的跨日志对账在工程上的难点值得具体说明。核心挑战在于身份归因(identity attribution):下游系统(如 CloudTrail、Stripe)记录的是 API Key 或 IAM Role 维度的操作主体,而 LangSmith trace 记录的是 Agent 运行实例维度的调用链,两者之间没有天然的关联键。实现对账通常需要:① 为每次 Agent 运行生成唯一的 run ID 并将其注入下游调用的请求头(如 X-Correlation-ID);② 下游系统支持将该 ID 写入其审计日志;③ 建立一个能关联两侧日志的数据管道。其中第②点往往是最大的障碍——许多 SaaS 服务(包括部分 Stripe API 端点)并不支持在审计日志中透传自定义关联字段,这使得时间窗口 + 身份的模糊匹配成为不得不接受的退而求其次方案,准确性无法达到严格审计的标准。
对构建生产级 Agent 的启示
无论你是否需要正式审计,这个问题都值得每个部署 Agent 的团队认真对待:
- 收敛调用路径:尽量让所有外部副作用通过统一的、可被 callback 覆盖的工具抽象层发出,减少工具内部的“野生”SDK 直连。
- 区分身份:避免 Agent 与后台进程共享同一 service account,否则下游日志无法区分责任主体。
- 以授权层为真相来源:在高风险场景(支付、权限变更)下,把下游系统日志而非应用 trace 作为审计的权威依据。
随着 Agent 被赋予越来越多真实世界的操作权限,“Agent 实际做了什么”将从一个工程问题升级为一个治理与合规问题。LangChain 的 callback 是一个优秀的可观测性工具,但把它误当成审计边界,可能是许多团队尚未意识到的风险。
背景补充
从根本原因看,这三类模式都源于 LangChain callback 系统的设计边界:callback 是基于链(chain)的生命周期钩子,只能感知在链执行上下文中显式触发的事件。一旦调用逻辑绕过了链的执行图(execution graph)——无论是通过直接实例化 SDK 客户端、复用链外持久化的凭证,还是通过独立进程——这些调用就从 callback 的视角彻底"消失"。这与传统 APM(应用性能监控)工具面临的"非 instrumented 代码路径"问题本质相同,区别在于 Agent 场景中这些未被追踪的调用往往伴随着真实的写操作(写数据、扣款、变更权限),而非仅仅是读查询,后果的严重性因此被显著放大。
相关推荐

AI SDK 发布版本更新:sandbox-just-bash 组件信息速览
AI SDK 生态组件 @ai-sdk/sandbox-just-bash 发布 1.0.147 补丁更新,同步 @ai-sdk/harness 依赖。本文梳理该发布记录的版本信息与升级建议。

@ai-sdk/sandbox-vercel 1.0.147 发布说明
@ai-sdk/sandbox-vercel 1.0.147 版本发布,这是一次补丁级更新,主要同步升级内部依赖 @ai-sdk/harness 至相同版本,通过 GitHub 可信签名验证。

ChatGPT洗碗记:一支叉子引发的AI过度推理反思
一支洗碗机没洗净的叉子,引发AI启动"深度研究"、消耗海量算力甚至挑战纳维-斯托克斯千禧难题的荒诞实验。这则ChatGPT洗碗讽刺视频,折射出AI过度推理、算力成本与场景错配的真实困境。