LangChain入门:大模型应用开发的核心框架与三大组件详解

为什么需要LangChain?
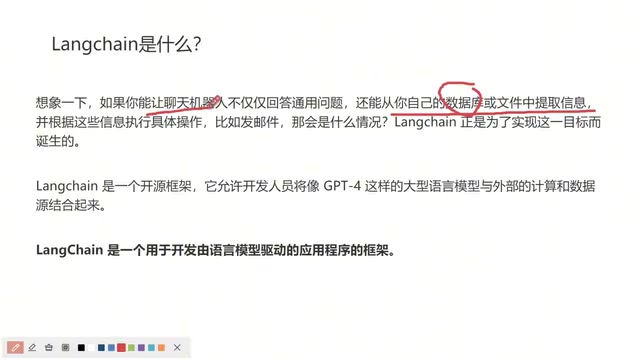
掌握大语言模型(LLM)API调用之后,开发者往往会遇到同一个瓶颈:如何让AI不只是回答通用问题,还能读取企业内部数据库、自动发送邮件、检索专业资料?
答案是:单靠大语言模型的API接口,无法做到这一点。
根本原因在于一个关键限制——大语言模型的训练数据主要来自互联网公开内容。无论是OpenAI的GPT系列,还是国内的GLM系列,它们的知识边界都止步于公开网络数据。大模型的知识边界本质上由其训练语料库决定:训练数据的截止时间(Knowledge Cutoff)意味着它对此后发生的事件一无所知;更重要的是,企业内网数据、医院病历、金融交易记录等私有信息从未出现在公开互联网上,模型对这类信息天然"失明"。这种局限并非技术缺陷,而是训练范式本身的约束——企业内部数据出于安全考虑不会对外暴露,大模型自然无从获取。这意味着,直接调用大模型API开发的聊天机器人,根本无法回答依赖企业私有数据的专业问题。
真正有价值的AI产品在哪里
一个值得关注的现象是:尽管美国在AI基础研究上持续领跑,但真正规模化落地的AI产品却并不多见。大部分头部机构的精力仍集中在大模型的调参、升级与性能优化上。而真正能为用户创造价值的,是那些结合企业自身数据、帮助用户自动完成具体操作的AI应用。
设想这样一个场景:你向AI提供100篇行业专业论文,针对论文内容反复追问,问完后只说一句「把我刚才的问答记录发到我的邮箱」,AI便真的完成了这个操作。这类能够感知上下文、联动外部系统的AI产品,才是真正实用、真正人性化的。
LangChain是什么
LangChain正是为解决上述问题而生。它是一个开源框架,核心能力是将GPT-4这样的大语言模型与外部计算资源和数据源有机结合。LangChain由Harrison Chase于2022年10月发布,最初作为轻量级Python库在GitHub上开源,随即因契合市场需求而迅速走红,数月内跻身GitHub星标增速最快的开源项目之列。随着生态扩张,项目逐步拆分为多个子库:langchain-core(核心抽象)、langchain-community(社区集成)以及面向企业级场景的LangSmith(可观测性平台)和LangServe(API部署工具)。
值得强调的是,LangChain支持的模型远不止GPT-4。谷歌、微软,以及国内的百度文心、智谱GLM等主流大模型,均在其兼容范围之内。自0.2版本起,项目引入了更稳定的LCEL(LangChain Expression Language),使链式组合的代码表达更为简洁,同时大幅扩展了对国内大模型厂商API的原生支持,国内外几乎所有主流大模型都可以直接接入使用。
一句话理解LangChain
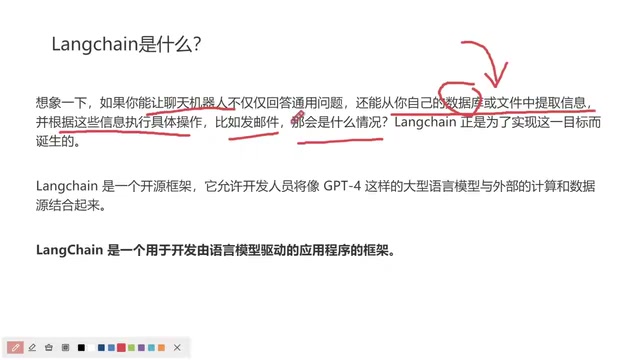
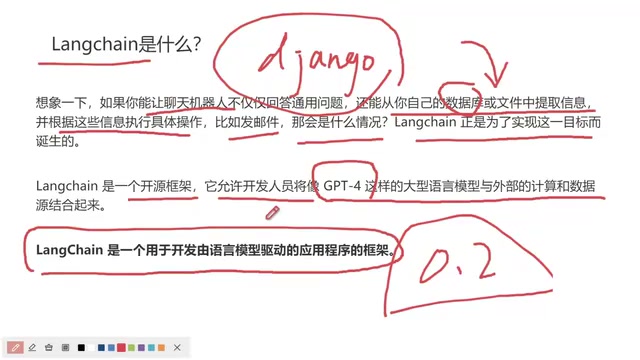
用一句话概括:LangChain是一个用于开发由语言模型驱动的应用程序的框架。
它以大模型为核心驱动力,在此之上提供了抽象封装、外部数据获取、数据存储、向量数据库访问等一整套开发能力,大幅降低了大模型应用的开发门槛。
有Java开发背景的读者可以这样类比:LangChain之于大模型应用开发,相当于Spring Boot或JDBC之于传统Java开发。Spring Boot解决了Java企业级开发中大量重复的基础设施配置问题(数据源、事务、依赖注入),让开发者专注业务逻辑;LangChain同样将大模型调用的通用流程——Prompt管理、会话记忆、工具调用、输出解析——抽象为可复用组件。更深层的类比在于:JDBC统一了不同数据库的访问接口,使代码与具体数据库解耦;LangChain的Model I/O模块同样统一了不同大模型的调用接口,实现了业务代码与具体模型供应商的解耦。它将大语言模型「包装」成可以直接与用户交互的产品级软件,让开发者聚焦业务逻辑而非底层对接。
LangChain的三大核心组件
LangChain通过三个核心概念构建其能力体系:组件(Components)、链(Chains)和代理(Agents)。理解这三者,就基本掌握了LangChain的整体设计思路。
组件(Components):统一的模型接口封装
组件层为各类大语言模型提供统一的接口封装。市面上的大模型众多,如果每更换一个模型都要重写一套调用代码,开发成本将极为高昂。
LangChain的组件层类似于JDBC的驱动程序机制:它提供一套抽象的、通用的调用接口。开发者只需基于这套接口编写业务代码,便可以在几乎不修改核心逻辑的前提下,自由切换OpenAI、谷歌、GLM等任意大模型。

这一设计的实际价值在于:无论未来哪个大模型的性价比更高——国内的好用就切国内,国外的好用就切国外——核心代码几乎无需改动。在大模型价格与性能频繁迭代的当下,这种与具体供应商解耦的能力具有显著的工程实用价值,是传统开发方式很难实现的灵活性,LangChain框架将其变为了常规操作。
链(Chains):组合组件解决特定任务
链的作用是将不同组件串联起来,协同解决特定任务。
一个完整的AI产品往往涉及多个环节:调用大模型、读写数据库、访问向量数据库、对文本进行向量化与嵌入(Embedding)……向量数据库(Vector Database)是LangChain生态的核心基础设施之一:系统将文本通过嵌入模型(Embedding Model)转换为高维浮点数向量,存储于Pinecone、Chroma、Milvus等专用数据库中;查询时,用户问题同样被向量化,通过计算余弦相似度快速找出语义最接近的文档片段,再注入大模型的Prompt。这一技术路径即RAG(Retrieval-Augmented Generation,检索增强生成),是目前企业级AI知识库的主流实现方案。链就是把这些分散能力整合为完整流程的机制,自0.2版本起,LCEL(LangChain Expression Language)使链的构建与表达更为简洁直观。
框架名称「LangChain」的含义也由此而来——Lang(语言模型)+ Chain(链式组合)。
代理(Agents):连接大模型与外部环境
代理(Agents)赋予大语言模型与外部世界交互的能力。
从技术原理来看,LangChain中的Agent实现了ReAct(Reasoning + Acting)范式:大模型在每一步不直接输出最终答案,而是先输出「思考过程」(Thought),再决定调用哪个工具(Action),等待工具返回结果(Observation)后继续下一轮推理,直至生成最终答案。这一"感知—决策—行动"的闭环赋予了大模型类似"自主决策"的能力。
举一个典型例子:若你希望AI分析Django官方文档,就需要先将文档内容抓取下来。这个「抓取」动作由代理工具负责执行——它先获取Django官网的内容,再将内容交给大模型处理。此后你的所有提问,都将基于这份官方文档进行。可供Agent调用的工具(Tools)范围极广:网页爬虫、SQL数据库查询、Python代码执行器、邮件发送接口、REST API调用等均可封装为标准Tool。
这里的「外部环境」范围相当广泛:既可以是Django这类公开站点,也可以是企业内部的私有数据库。例如,京东庞大的商品数据可以作为外部数据源接入,让大模型在此基础上构建智能客服、智能营销或销售代理系统。代理机制,正是打通大模型与外部世界的关键桥梁,也是当前大热的AI Agent赛道的核心技术基础。
总结
LangChain解决的核心问题是:帮助大语言模型突破「只能基于训练数据作答」的天然局限,使其能够接入私有数据、执行真实操作,从而支撑真正落地的AI产品开发。
通过组件、链、代理这三大核心概念,开发者可以用一套稳定的代码,灵活调用各类大模型、按需组合各种能力、自由对接外部数据系统。对于有志于进入大模型应用开发领域的工程师而言,LangChain是一个绕不开的基础起点。在掌握LangChain之后,进一步学习LangGraph、RAG、MCP和Agent开发,便能逐步构建出更复杂、更具实用价值的智能应用系统。
核心要点
相关推荐
Vibe Coding是什么?程序员必须掌握的AI编程能力
Vibe Coding(AI编程)到底是什么?本文解析AI编程如何重塑研发流程、为何传统程序员面临淘汰、Cursor与Claude Code两大工具,以及程序员、PM、运营等岗位为何都该掌握这项能力。
让石头思考:生成式AI与信息压缩的哲学思考
从Reddit热帖「让石头思考」出发,探讨生成式AI的信息论本质:为何压缩等价于理解,巴别图书馆式的可能性空间思辨,以及语义压缩、Hutter Prize与AI原理的深层联系。
让Claude"浪费"额度:一场AI创造力的意外实验
一位Reddit用户让Claude用剩余额度"做件荒唐的事",结果AI生成了监控一块石头的企业级平台RockOps。本文分析这一趣味案例背后的AI创造力与产品设计能力。