LangChain入门教程:从原理到实战讲透AI应用开发

LangChain是封装模型调用、私有数据接入与对话状态管理的AI应用开发框架
LangChain 是一个开发 AI 应用程序的框架,核心价值不在让模型更聪明,而在解决模型之外的工程问题。它通过统一接口封装 OpenAI、DeepSeek、Anthropic 等不同供应商的 API,使模型替换只需改动配置;同时提供私有数据对接能力和多轮对话的上下文与记忆管理,避免开发者把精力耗在重复代码上。其特点包括模块化架构、Prompt 模板、链与智能体、工具调用及记忆管理,并已推出基于 Harness 架构的 DeepAgent。文章还澄清了 Ollama 是私有化部署框架、Coze 是拖拽式平台,与作为代码框架的 LangChain 不在同一层级,LangChain 加 LangGraph 即可完成整套企业级 AI 项目。
大语言模型的能力越来越强,但真正把它落到企业业务里,光会调API远远不够。模型供应商换一次、接口改一遍,代码就得重写;企业私有数据接不进来,模型只能靠训练时的旧知识作答;多轮对话轮数一多,上下文状态管理就成了噩梦。LangChain这类框架要解决的,正是这些「模型之外」的工程问题。这篇文章结合B站UP主的保姆级讲解,把LangChain是什么、能做什么、和Ollama/Coze的区别讲清楚。
LangChain到底解决了什么问题
先把最核心的一层说清楚:LangChain是一个开发AI应用程序的框架。
现在几乎所有大模型供应商——OpenAI、DeepSeek广告、Anthropic等——都会提供各自的API供开发者调用。问题在于,每家的API调用方式都不一样,你如果写代码时今天用A、明天换B、后天换C,就得准备多套调用逻辑,维护成本很高。
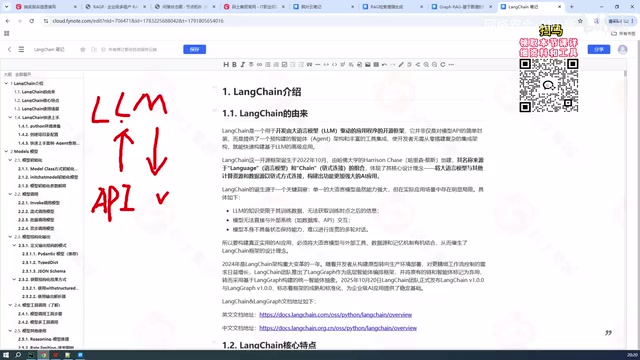
LangChain的做法是「封装一层」:你统一用它的接口来调大模型,底层代码不用动,上层只需要替换模型供应商就行。这就是所谓「统一的模型接口」,也是最直观的价值。
大语言模型 API 的碎片化是理解统一接口价值的背景。OpenAI、Anthropic、DeepSeek 等厂商虽然都提供 HTTP 接口,但在鉴权方式、请求体字段、流式返回格式、函数调用(Function Calling)协议、错误码语义上都存在差异。例如同样是流式输出,有的用 SSE 的 data: 事件,有的字段名是 delta,有的是 content。开发者若直接绑定某一家 SDK,一旦业务要求切换模型或做多模型路由,就需要改写整条调用链。LangChain 通过 ChatModel 抽象层把这些差异收敛成统一方法(如 invoke、stream、batch),使模型替换退化为配置项改动。
模型上下文窗口与知识边界是另一层背景。大模型的参数化知识只覆盖训练语料截止之前的内容,且不包含企业内部的文档、数据库和工单。上下文窗口(如 8K、128K token)决定了单次能塞入多少信息,超出就会被截断。因此企业要让模型回答私有问题,通常需要「检索—拼接—生成」的流程,把外部数据以提示词形式注入上下文,这正是 LangChain 各类 Retriever、Document Loader 和 VectorStore 集成所承载的职责。
不止是调模型:私有数据与上下文管理
模型单独回答问题时,只能依赖训练数据里有的东西——训练数据里没有的,它就不会知道。企业真正要用的,往往是内部的私有化数据,怎么让模型安全地对接这些数据,是落地时的第一个门槛。
LangChain把这类对接工具、开发工具都封装好了,不需要你从零手写一整套调用代码,直接配置就能对接企业内部数据。
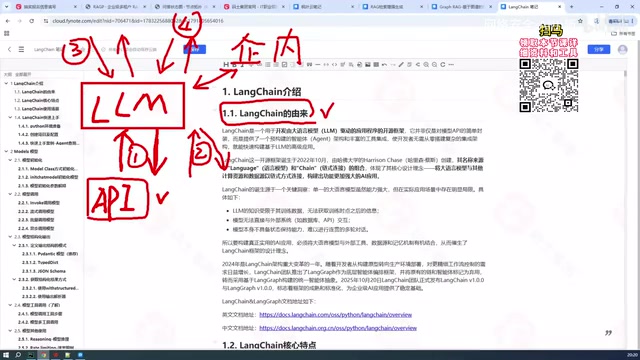
另一个容易被低估的点是上下文和状态管理。多轮对话中,轮数越多,后续提问越可能牵扯到之前聊过的内容,这属于记忆管理。如果全靠自己写代码维护,精力会全耗在对话处理上,反而没法聚焦业务。LangChain天生自带这类能力,用上层操作就能把对话状态自动维护起来。
LangChain的几个核心特点
统一模型接口:模型供应商可自由替换,这是框架最基础的能力。
模块化架构:包含Prompt模板、可插拔的模型配置、记忆管理、链(Chain)、智能体(Agent)、工具等模块。UP主特别提到,LangChain现在还有基于Harness架构的DeepAgent,「比较火,面试几乎你要有这样的项目,过的概率非常高」。
智能体与工具调用:支持构建复杂的智能体,包括子智能体、多智能体嵌套,以及与图结构中的智能体嵌套,同时提供工具的开发和封装能力。
记忆管理:对话轮数增多后如何管理上下文,里面有不少技巧,UP主表示这部分先不展开。
Chain 与 Agent 的区别值得单独说明。Chain 是一条预先编排好的固定流水线,例如「模板填充 → 调用模型 → 解析输出」,执行路径在代码写定时就确定。Agent 则把「下一步做什么」交给模型自己决定:模型根据当前目标和可用工具列表,输出一个工具调用请求,框架执行后再把结果回灌给模型,循环往复直到任务完成。前者可控、可预测,后者灵活但更难调试。
Harness 架构与 DeepAgent 可以这样理解:Harness 指的是包裹在模型外层的运行骨架,负责工具注册、循环控制、状态持久化和错误恢复。DeepAgent 是 LangChain 在这一思路下推出的更高层封装,内置了规划、子智能体委派和长期记忆等能力,让开发者不必从零搭建复杂的 Agent 循环。面试中常被问到的正是「你如何设计 Agent 的工具边界与失败回退」,这也是它被认为含金量高的原因。
应用场景:一个生态全搞定
按UP主的说法,凡是企业里要构建AI应用,LangChain「几乎全都能搞得定,不需要别的框架」。更严格地讲,用LangChain这一个生态——LangChain加LangGraph——就可以完成一整套项目。他即将讲解的项目案例,就是用这套生态实现的。
Ollama是什么?和Coze有什么区别
UP在直播答疑中回答了几个高频问题,这里单独拎出来。
Ollama是什么:它是一个部署框架。大模型分在线和私有化部署两条路——在线如DeepSeek、OpenAI、Claude;私有化则是把开源模型(比如开源的DeepSeek)部署到自己的服务器上,这就要用到Ollama、vLLM、LM Studio这类框架。
它是不是另一个Coze:不是。Coze可以理解成用拖拽方式搭建简单个人应用或工作流的工具,内部也能做工作流、多智能体或单智能体,但它是拖拽式的。而LangChain是代码框架——「我用LangChain可以构建出来一个Coze平台」,两者是层级和形态的差别。
安全性怎么样:安全性取决于你怎么控制大模型。模型层面现在已相对安全,但涉及企业内部数据的操作控制,仍需自己设置权限和兜底操作。
多Agent能搞定吗:能,这正是它擅长的方向。
私有化部署框架之间的差异可以再对比一下。Ollama 主打轻量和开箱即用,一条命令即可拉取并运行量化后的开源模型,适合本地开发和中小规模推理;vLLM 侧重高吞吐的批量推理,通过 PagedAttention 优化显存利用率,更适合生产环境的并发服务;LM Studio 则是带图形界面的桌面工具,偏向个人体验。三者都在解决「把开源权重跑起来」的问题,差别在性能、易用性和部署形态。
在线 API 与私有化部署的选择通常取决于数据合规、成本和可控性。在线 API 无需运维、模型能力往往更强,但数据要出企业边界,且按 token 计费;私有化部署数据不出内网、可离线运行,但需要自备 GPU、承担推理延迟,并且模型能力受限于所选开源权重。实际项目中常见混合方案:敏感数据走私有模型,通用问答走在线 API,由 LangChain 的统一接口在同一套代码中调度。
小结
LangChain的价值不在于「让模型更聪明」,而在于把模型接入业务时那些重复、琐碎、容易出错的工程环节封装起来:统一接口、接入私有数据、管理对话状态、编排智能体与工具。理解了这层定位,再去看LangGraph、MCP、Agent这些概念,会更容易找到它们各自的位置。
相关推荐

uGAP:统一100+非洲地理数据集的AI平台
uGAP是开普敦大学团队开发的非洲地理空间AI平台,统一120余个非洲数据集并提供Python SDK,支持数据发现、处理与模型训练一站式工作流,已用于气旋洪水制图等实战场景。

Cursor能控制你的电脑了:AI代理可驱动桌面应用测试
Cursor 新增桌面控制能力,AI 代理可驱动 iOS 模拟器等桌面应用测试自己构建的功能。本文分析这一更新对开发工作流的影响、技术实现可能路径及可靠性考量。

Vibecoding自研推理引擎:理想丰满,现实骨感
Reddit开发者分享Vibecoding自研推理引擎的真实经历:用WebGL2和GLSL在浏览器跑GGUF Q4模型,却陷入tokenizer调试地狱。本文分析浏览器端LLM推理的工程难点,以及为何直接clone llama.cpp是更理性的选择。