LangChain实战:从零搭建可上线Agent的完整路径

用 LangChain 从零搭建可上线 Agent 的六层工程路径与避坑指南。
本文基于 B 站 UP 主“姿意”的实战视频,系统梳理了用 LangChain 从零构建可上线 Agent 的完整路径。文章先区分 Model 与 Agent 的概念,并说明 LangChain 与 LangGraph 的选型依据;随后依次讲解系统提示词与流式输出、工具与联网搜索、短期与长期记忆、RAG 知识库接入,最后用 FastAPI 将 Agent 暴露为 Web API。核心结论是:Agent 产品化需要模型接入、提示词工程、工具系统、记忆系统、知识库、服务化六个层次协同;其中多 worker 部署下 InMemorySaver 会导致记忆断裂,是 Demo 转生产的关键坑,必须提前做持久化设计。
很多开发者对 Agent 的印象停留在"调个 API 让模型回答问题",但真正要把一个 Agent 从零做到可上线,中间隔着工具调用、记忆管理、知识库接入、服务化暴露这几道坎。B站UP主"姿意"的这期实战视频,用 LangChain 把整条路径完整走了一遍,从模型初始化一直到 FastAPI 对外提供接口,代码量不大,但每一步都踩在工程化的关键节点上。
本文基于该视频内容,结合 LangChain 官方框架的能力边界做一次系统梳理。
一、先分清 Model 和 Agent:大脑与完整的人
视频开篇给了一个很直白的类比:Model 是 Agent 的大脑,Agent 则是一个完整的人。模型本身只负责推理,而 Agent 在其之上叠加了工具、MCP、规范限制等"器官"和"行为准则"。这个区分很重要,因为它决定了后续每一步在补什么能力。
LangChain 在这个生态里的定位是"直接搭建 Agent 的框架",与之并列的还有 LangGraph——后者偏向用工作流编排的方式组织多步骤逻辑。选哪个取决于你的场景复杂度:单 Agent 加几个工具,LangChain 的 create_agent 足够;需要多节点状态机、条件分支、循环,LangGraph 更合适。
模型来源上,视频演示使用的是腾讯云广告 TokenHub 的免费额度,模型选了 DeepSeek广告 V4 Flash,通过 OpenAI 兼容协议接入。这意味着请求地址和密钥都走 .env 环境变量管理,Provider 设为 OpenAI 即可。这种接法的好处是换模型几乎零成本——换成其他提供 OpenAI 兼容接口的服务,只改环境变量就行。
项目初始化用 UV 管理虚拟环境,依赖包括 LangChain、OpenAI SDK、LangGraph、Tavily 等。UP主特别强调了一个原则:每一章节的代码都是独立可运行的最小示例,不是最终整合版,目的是让读者清楚"这一步在加什么能力"。
LangChain 与 LangGraph 的分工
LangChain 和 LangGraph 同属 LangChain 生态,但定位不同。LangChain 早期以链式调用(Chain)为核心,提供 create_agent 这类高阶封装,适合快速搭建“单 Agent + 若干工具”的场景,开发者只需声明模型、提示词和工具列表,框架自动处理调用循环。LangGraph 则把 Agent 建模为状态图(StateGraph):节点是计算步骤,边是条件跳转,支持循环、分支、并行和人工介入,适合需要精确控制多步流程、多 Agent 协作或长时间运行的任务。两者并不互斥——LangGraph 可以调用 LangChain 的组件,create_agent 的底层实现也常基于 LangGraph。选型时抓住一个判断标准:逻辑能否用“一次调用+工具循环”表达,能则 LangChain,否则 LangGraph。
二、系统提示词与流式输出:让模型有身份、有反馈
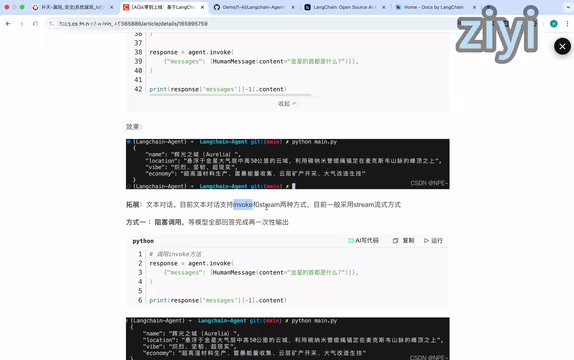
从裸模型到 Agent 的第一步是系统提示词。LangChain 里通过 system_prompt 配置传入身份、指令和输出示例,再用 create_agent 把模型和提示词绑定,最后用 invoke 触发。视频演示中问了模型一个问题,输出会按照预设示例的格式来组织——这就是 few-shot 在提示词层面的作用。
调用方式上有 invoke 和 stream 两种。前者是阻塞式,等模型全部生成完再返回;后者是流式,模型吐一个字前端就能收到一个字。视频里明确说主流场景应采用 stream,因为对话类产品的体验差异非常明显。这一点在后文 FastAPI 部分还会再出现——接口层同样要提供流式端点。
三、工具与联网:给 Agent 装上行动力
模型只有历史训练数据,要让它算数、查天气、操作平台,就得靠 Tool。工具可以是本地函数,也可以封装外部 API。定义好之后,通过 create_agent 的 tools 参数列表传入即可。
联网搜索是 Agent 最常被要求的能力之一。视频选择 Tavily 作为 Web Search 工具,注册开通拿到 API Key 后写入环境变量,再通过 LangChain 与 Tavily 的集成包导入 TavilySearch,配置最大返回条数,然后把它作为 Tool 交给 Agent。底层逻辑就是:模型判断需要联网时,调用这个工具,工具返回搜索结果,模型再基于结果生成回答。
这里有一个容易被忽略的工程细节:工具的描述(description)直接决定模型会不会在正确的时机调用它。描述写得含糊,模型就可能该调不调、不该调乱调。
四、短期记忆与长期记忆:让 Agent 记住人和事
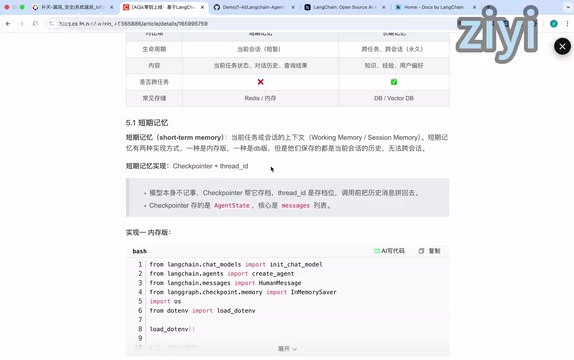
没有记忆的 Agent 每次对话都是陌生人。视频把记忆分成两类:短期记忆是当前任务或会话的上下文,长期记忆是跨任务、跨会话的经验和知识。
短期记忆在 LangChain 里靠两个东西实现:checkpointer 负责存档,thread_id 负责标识存档位。调用前把历史消息拼进上下文,模型就有了"记性"。内存版本用 InMemorySaver 即可,但视频做了个很实在的演示——重新运行程序后,之前的对话记忆就没了,因为内存随进程消失。要持久化就换 SQLite,固定 thread_id,运行时会从 short_memory.db 加载历史并拼接进上下文。
长期记忆则通过 store 实现,视频用 SQLite 建了一个 store 并接入连接。演示中换了不同的 thread_id(相当于不同会话),Agent 依然记得之前说过的内容——这就是跨会话记忆的价值。
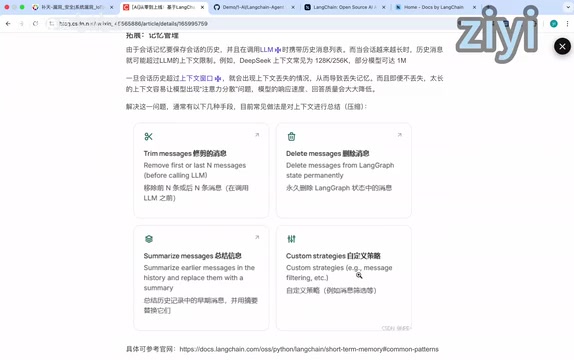
上下文窗口是记忆管理的硬约束。历史一旦超出窗口,记忆就会丢失。视频列了四种应对策略:修剪消息(移除前几条或后几条)、删除历史消息、总结压缩、自定义策略。实际项目里总结压缩最常用,视频也采用了这一种。
Checkpointer 与 Store 的区别
Checkpointer 和 Store 是 LangGraph 记忆体系的两个独立抽象。Checkpointer 面向“会话状态”:它以 thread_id 为键,在每个步骤后保存图的完整状态快照(包括消息历史、中间变量),支持中断恢复、时间旅行调试。它回答的是“这个会话进行到哪了”。Store 面向“跨会话的长期数据”:它是一个键值存储接口,按命名空间(namespace)和键组织数据,不绑定某个 thread,Agent 可以主动写入和检索用户偏好、事实知识等。两者可以组合使用:Checkpointer 保证单次对话的连续性,Store 让不同对话共享用户画像。生产环境中,Checkpointer 可换用 PostgresSaver、RedisSaver 等持久化实现,Store 也有对应的数据库后端。
五、RAG 与知识库:让 Agent 懂你的业务
工具和记忆解决了"能做事"和"记得住",但模型仍然只懂通用知识,不懂你的业务。比如公司年假政策、考勤规则,这些必须靠知识库。
技术路径是 RAG:模型生成回答前,先从外部知识库检索与问题最相关的内容,作为上下文交给模型。视频还提到了 Agentic RAG——不强制每次提问都检索,而是让模型自己判断当前问题需不需要查知识库。这更接近真实业务的形态。
在 Agent 里落地 RAG 的关键,是把检索能力包装成一个 Tool。具体步骤:安装 text splitter 等依赖,准备文档(视频用字符串直接传入,实际项目通常是加载 doc 或 PDF),对文档分块并配置切分参数,用本地 embedding 模型做向量化并存储,配置每次检索返回的文档块数量(视频设为 3),最后用 create_retriever_tool 把 retriever 封装成工具传给 Agent。
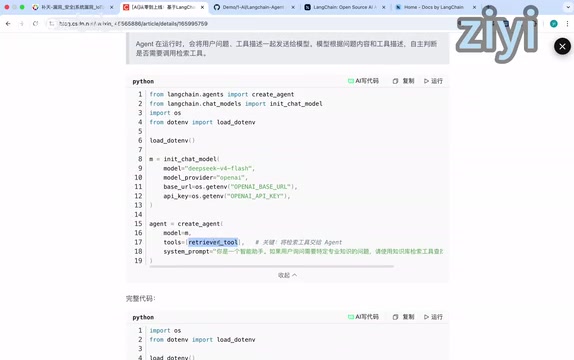
演示效果是直接问"我们公司的年假政策是怎样的",Agent 会调用 RAG 工具读取知识库内容再作答。
Embedding 与向量检索
RAG 的检索效果很大程度上取决于 embedding 模型和向量存储。Embedding 模型把文本映射为高维向量,语义相近的文本在向量空间中距离更近。本地 embedding 模型(如 BGE、Sentence-Transformers 系列)无需调用外部 API,适合数据敏感或离线场景,但需要自行管理模型加载和推理资源;OpenAI 等云端 embedding 服务则省去运维,按 token 计费。向量化后的文档块存入向量库(如 FAISS、Chroma、Milvus),检索时把用户问题同样向量化,按余弦相似度返回 top-k 个块。视频中设置的“每次返回 3 个块”就是 top-k 参数,取值过小可能遗漏信息,过大则引入噪声并挤占上下文窗口,需要按文档粒度和问题类型调优。
六、FastAPI 服务化:从终端走向用户
前面所有能力都跑在终端里,只有自己能用的 Agent 没有产品价值。最后一步是用 FastAPI 把 Agent 暴露为 Web API,浏览器、App、第三方系统都能通过 HTTP 请求访问。
视频的服务端代码很精简:添加中间件允许前端跨域,定义请求体规范,设置接口 URL,普通接口用 invoke 的 await 调用,流式接口则逐字返回(对应 SSE)。测试时可以用 Swagger 直接调,也可以写一个简单的 index.html,浏览器打开后在输入框输入内容、点击发送,灰色框显示模型输出。
整体架构就是:后端用 LangChain 包装 Agent 能力,前端面向 2C 用户,中间通过 HTTP 和 SSE 通信。
上线前必须解决的一个坑
UP主在结尾点出了一个真实业务的关键问题:多 worker 部署时 InMemorySaver 不可用。每个进程的记忆是独立的,用户第一次请求打到 worker1、第二次打到 worker2,记忆就断了。生产环境必须做持久化——回到第四节的 SQLite 或其他数据库方案。这个提醒看似轻描淡写,却是很多 Demo 到生产的翻车点。
七、这套路径的工程启示
回看整条链路,LangChain 提供的抽象其实对应了 Agent 产品化的六个层次:模型接入(换模型零成本)、提示词工程(身份与格式约束)、工具系统(行动力)、记忆系统(连续性与个性化)、知识库(业务纵深)、服务化(可达性)。每一层单独看都不复杂,但组合起来才是一个能上线的 Agent。
对准备动手的开发者,有几个建议值得参考:第一,按章节拆分最小可运行示例,别一上来就写整合代码;第二,记忆和持久化要提前想清楚部署形态,单机内存和多 worker 是两套设计;第三,工具描述和检索块数量这类参数,要按实际任务调,不要照搬默认值;第四,流式输出从第一天就接上,后期改造成本更高。
相关推荐

Workbuddy零基础入门:桌面AI智能体如何落地工作流
Workbuddy桌面AI智能体零基础教程解读:从安装、积分领取到文件管理与自动化工作流搭建,对比CodeX的适用场景与成本差异,帮助职场人完成从AI提问者到AI管理者的思维转变。

OpenAI智能体新栈:计算机操作、决策API与超速工作流
OpenAI Dev Day发布智能体新栈:Computer Use操作速度超越普通人,Decisions API基于Luna实现极低延迟分类,Agents API开放同源计算机操作能力,GPT-6.1 Sol成本仅为Astra七分之一。本文梳理核心更新、实测数据与开发者落地要点。

梁文峰开源推理框架DeepInfo,硬刚美国禁令
DeepSeek在开源模型后再开源推理框架DeepInfo,包含GPU/CPU交叉流水线、小模型预判大模型复核、华为昇腾与英伟达芯片全面适配等技术,直面美国联邦禁令。本文解析其对AI产业落地的意义与开源策略。