LangChain真让Agent开发更简单?开发者反思抽象代价
开发者吐槽LangChain/LangGraph:抽象降低入门门槛,却把复杂度转移到调试与成本。
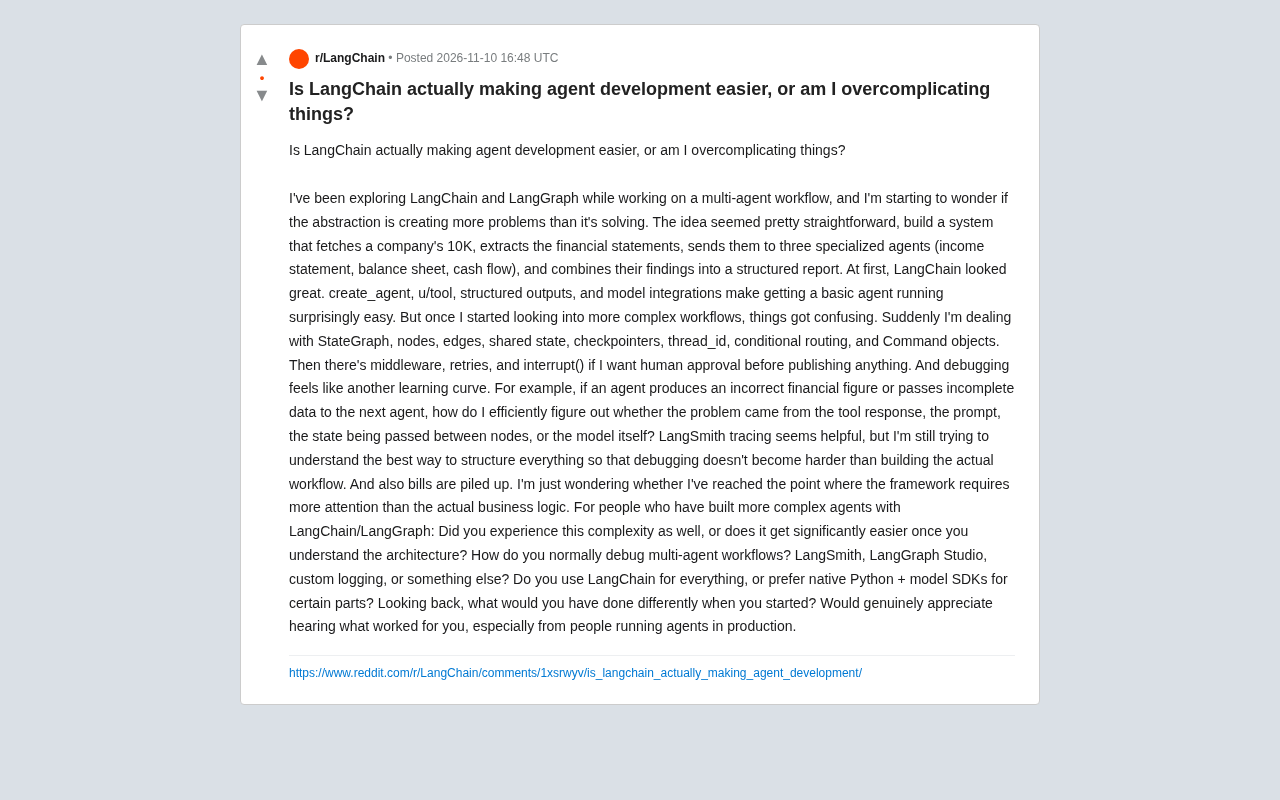
一位开发者在 Reddit 上分享用 LangChain 和 LangGraph 构建多智能体工作流的经历:以抓取 10-K 文件、由三个专门智能体分别处理三张财务报表并合并报告为例,入门阶段 create_agent、工具装饰器和结构化输出让基础智能体很快跑通,但工作流复杂后,StateGraph、checkpointer、thread_id、条件路由、Command、interrupt 等概念叠加,学习曲线陡峭。最尖锐的问题是调试:当智能体输出错误财务数字时,难以判断问题出在工具返回、提示词、节点间状态还是模型本身。LangSmith 追踪有帮助,但可观测性必须作为架构的一部分。token 消耗与重试带来的成本压力也促使他思考是否部分环节改用原生 Python 加模型 SDK。
一位开发者在Reddit上发帖,讲述了自己用LangChain和LangGraph构建多智能体工作流时的困惑:框架的抽象层到底是在简化开发,还是在制造新的复杂度?他设想了一个看似清晰的任务——抓取公司10-K文件、提取财务报表、交给三个专门智能体(利润表、资产负债表、现金流量表)分别处理,最后合并成结构化报告。起初LangChain让基础智能体跑起来出奇地容易,但越往复杂工作流走,越多概念涌现出来,调试也越来越像一门玄学。
从“几行代码”到“一整套架构”
这位开发者承认,LangChain的入门体验相当友好。create_agent、工具装饰器、结构化输出、模型集成这些能力,让一个能跑的基础智能体在很短时间内就能搭起来。问题出现在工作流变复杂之后:StateGraph、节点、边、共享状态、checkpointer、thread_id、条件路由、Command对象,再加上中间件、重试机制,以及想在发布前加入人工审核时要用到的interrupt()。每一个概念单独看都有其道理,堆在一起就形成了陡峭的学习曲线。
他的感受很具体:框架要求开发者理解的架构细节,已经快赶上业务逻辑本身的复杂度了。
StateGraph 是 LangGraph 的核心抽象,把工作流建模为有向图:节点是处理函数(如调用模型、执行工具),边定义执行顺序,共享状态(state)在节点间传递并被每个节点更新。checkpointer 负责在每个节点执行后持久化状态快照,配合 thread_id 实现会话恢复、断点续跑与多用户隔离。条件路由 根据当前状态动态选择下一个节点,相当于图内的 if/else;Command 对象则允许节点在返回状态更新的同时显式指定跳转目标,把“改状态”和“选路径”合并为一次操作。interrupt() 用于在指定节点暂停执行、等待人工输入后再恢复,是实现 human-in-the-loop 审核的机制,其恢复依赖 checkpointer 保存的状态。这些概念各自解决状态管理、持久化、动态控制流和人工介入问题,组合使用时要求开发者同时理解图的拓扑与状态的演化,因而学习曲线明显变陡。
调试多智能体工作流:问题到底出在哪一层?
帖子中最尖锐的疑问是关于调试。假设某个智能体给出了错误的财务数字,或者把不完整的数据传给了下一个节点,开发者如何快速定位问题源头?是工具返回的结果有问题,是提示词写得不对,是节点之间传递的状态出了偏差,还是模型本身的问题?
LangSmith的追踪功能被认为有帮助,但他仍在摸索如何组织整个系统,才能让调试不比构建工作流本身更难。这也是许多从Demo走向生产的团队都会撞上的墙:可观测性不是附加项,而是架构的一部分。
LangSmith 是 LangChain 生态中的可观测性与评估平台,它把一次智能体运行记录为树状 trace:每次模型调用、工具执行、检索和状态变更都是树上的一个 span,附带输入、输出、耗时和 token 用量。调试多智能体系统时,trace 的价值在于能沿着调用链逐层下钻,判断错误是产生于某个工具返回、某次提示词渲染、节点间的状态合并,还是模型自身的推理。不过 trace 只呈现“发生了什么”,不解释“为什么这样设计”,因此若工作流的状态结构和节点职责划分本身不清,追踪信息越全反而越难定位。实践中通常需要把 trace 与结构化日志、节点级断言结合起来:在关键节点校验状态字段的完整性与类型,让错误在传播到下游之前就暴露出来。
成本焦虑与“原生Python+模型SDK”的替代路径
除了复杂度,账单堆积也是他提到的现实压力。多智能体、多次调用、追踪与重试,都会放大token消耗。他提出了一个很多开发者都在权衡的问题:是否所有部分都值得用LangChain,还是某些环节直接用原生Python加模型厂商的SDK更划算、更透明?
他最后向有生产环境经验的人抛出几个问题:这种复杂度是必经阶段,还是理解架构后会显著变简单?多智能体工作流通常怎么调试——LangSmith、LangGraph Studio、自定义日志,还是别的组合?回头看,开始时会做出哪些不同的选择?
这篇帖子没有给出标准答案,但它准确地描摹了一个普遍存在的张力:抽象层在降低入门门槛的同时,也可能把复杂度转移到调试、状态管理和成本控制上。对准备采用LangChain/LangGraph的团队来说,先想清楚自己愿意为抽象支付多少“认知税”,可能比急着选框架更重要。
背景补充
10-K 文件 是美国上市公司按 SEC 要求提交的年度报告,包含经审计的财务报表(利润表、资产负债表、现金流量表)、管理层讨论与分析、风险因素等。其篇幅通常数百页,表格密集且格式不统一,因此“抓取—解析—抽取结构化财务数据”本身就是一条独立的工程链路,涉及 HTML/PDF 解析、表格识别和字段对齐。把这条链路拆给多个专门智能体并行处理后合并,是常见的多智能体设计,但也意味着每个智能体的输入质量直接决定最终报告的可信度;在架构上通常需要为抽取结果定义统一的 schema,并在合并前做一致性校验(如资产=负债+权益),否则单个智能体的错误会在汇总时被放大且难以追溯。
相关推荐
七年蜕变:初代折叠屏与现在差距有多大
从初代折叠屏到最新产品,七年时间带来了哪些改变?折痕变浅、亮度提升、机身更薄、软件迁移更顺畅,折叠屏是否已经跨越从发烧友到普通用户的鸿沟?本文基于视频对比分析展开讨论。
人类何时开始吃盐?一段跨越万年的盐史
人类何时开始吃盐?从11000年前农业兴起时的加盐实践,到古代海水蒸发、岩盐开采,再到盐贸易、盐税与甘地食盐长征,本文梳理盐在人类文明中的关键角色。
微软Paza研究:非洲语言语音识别如何突破架构与数据瓶颈
微软Paza研究系统评估53个语音模型在39种非洲语言上的表现,揭示架构选择比预训练覆盖更关键、200-300小时为实用数据门槛,以及语言类型学对识别性能的深层影响。