LangGraph 实战:开发者真实工作流与技术栈剖析

Reddit 提问帖折射 LangGraph 从教程走向生产的五类挑战与可观测性焦虑。
文章以 Reddit 上一则面向 LangGraph 开发者的提问帖为线索,梳理了该框架从演示走向生产时最常遇到的五类挑战:真实用例多为有状态的多步骤编排而非单轮聊天;技术栈没有标准答案,常见组合是 LangGraph 负责编排、直接使用提供商 SDK 调用模型、向量库做检索、Postgres 或 Redis 持久化检查点;图结构从单代理循环到多代理协作再到确定性工作流,可控性依次提升;调试最难的是意外循环、重复工具调用和状态问题,长时工作流尤其需要节点级追踪;生产落地的关键矛盾是灵活性与可控性的平衡,可观测性建设比框架选型更能决定项目成败。
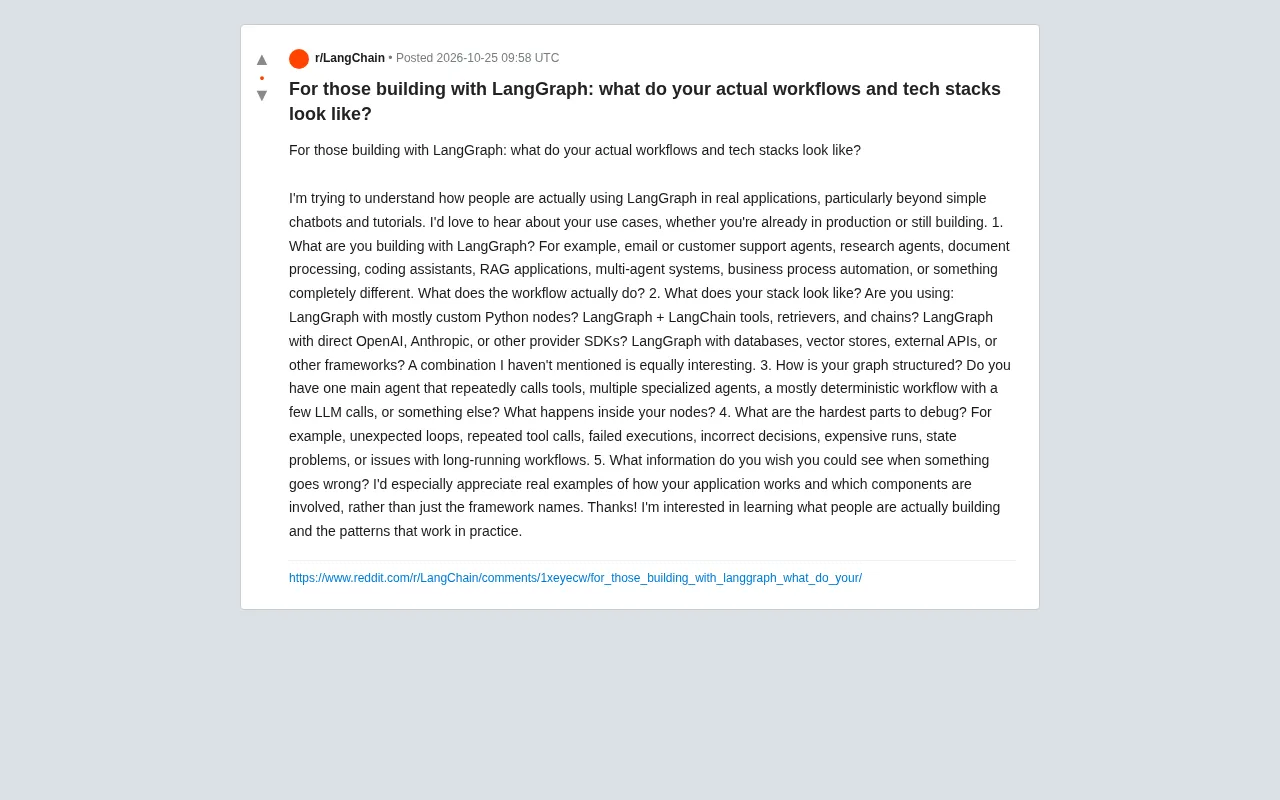
LangGraph 作为构建有状态、多参与者 LLM 应用的框架,其教程和示例往往聚焦于简单聊天机器人。但真实的生产系统长什么样?Reddit 上一个面向 LangGraph 开发者的提问帖,试图挖出实际用例、技术栈组合、图结构和调试痛点。虽然帖子本身是问题而非答案,但它精准勾勒了从教程迈向生产时最常遇到的五类挑战,也反映了社区对“可观测性”和“确定性”的普遍焦虑。以下结合该帖提出的问题框架,以及社区中常见的实践模式,梳理 LangGraph 落地时的关键考量。
真实用例:超越聊天机器人的复杂编排
帖子首先追问“你用 LangGraph 构建什么”,候选清单包括邮件/客服代理、研究代理、文档处理、编码助手、RAG 应用、多智能体系统和业务流程自动化。这本身说明 LangGraph 的吸引力在于编排复杂、有状态的工作流,而非单轮对话。例如,一个客服代理可能需要先检索知识库、再调用订单系统、最后生成回复并根据置信度决定是否转人工——这类流程涉及多个工具调用和条件分支,正是 LangGraph 的用武之地。研究代理则常表现为“规划-搜索-总结-反思”的循环,文档处理流水线则需要并行分支和错误重试。
有意思的是,帖子特意询问“工作流实际做什么”,暗示许多团队在框架选择上已经趋同,但业务逻辑的差异才是真正的价值所在。社区中常见的模式是:确定性骨架 + LLM 节点。即整体流程由代码控制(如顺序、并行、条件路由),只在需要语言理解或生成的环节调用 LLM。这种混合结构比“全自主智能体”更容易测试和调试,也更符合生产环境对稳定性的要求。
ReAct 模式(Reasoning and Acting)是 LangGraph 单代理循环的典型实现:模型先输出推理步骤,再决定调用哪个工具,观察工具返回后继续推理,直至给出最终答案。这种模式让 LLM 能动态组合外部能力,但终止条件完全由模型判断,容易陷入“调用-观察-再调用”的循环。LangGraph 通过图结构显式定义节点和边,允许开发者在模型输出之外加入硬性终止规则(如最大迭代次数、工具白名单),从而在保留 ReAct 灵活性的同时增加可控性。理解这一模式有助于判断何时该用单代理循环、何时需要拆分为多代理或确定性流程。
技术栈组合:没有标准答案,只有权衡
关于技术栈,帖子列出了几种典型组合:纯自定义 Python 节点、LangGraph + LangChain 工具/检索器/链、LangGraph + 直接使用 OpenAI/Anthropic SDK、以及结合数据库、向量库、外部 API 或其他框架。这反映出 LangGraph 的定位——它负责编排层,而不强制绑定模型调用方式。
实践中,一个常见且务实的组合是:LangGraph 管理状态和路由,直接使用提供商 SDK 进行模型调用,用向量数据库(如 pgvector、Pinecone)做检索,用 Postgres 或 Redis 持久化检查点。直接使用 SDK 的好处是避免 LangChain 抽象层带来的调试复杂度,同时能及时用上提供商的最新功能(如工具调用、结构化输出)。而 LangChain 的工具和检索器在快速原型阶段仍有价值,但不少团队在生产中会逐步替换为更薄、更可控的封装。帖子中“组合我没提到也同样有趣”的开放态度,恰恰说明这个领域尚未形成最佳实践,团队需要根据自身运维能力和合规要求做取舍。
检查点(Checkpoint) 是 LangGraph 实现持久化和可恢复执行的核心机制。每次图执行到某个节点后,框架可将当前状态序列化并存储(如写入 Postgres 或 Redis),形成一条检查点历史。这使得长时工作流可以在进程重启、人工审批等待或外部 API 超时后从最近检查点恢复,而不必从头重跑;同时支持时间旅行调试——回放某一检查点并观察后续分支。检查点的有效性高度依赖状态的可序列化性:如果状态中混入了不可序列化的对象(如数据库连接、文件句柄),持久化就会失败。因此设计状态结构时需保持纯数据化,这也是社区强调“状态可序列化”的原因。
图结构设计:从单代理循环到多代理协作
帖子询问图是“一个主代理反复调用工具”“多个专用代理”还是“大部分确定性的工作流加少量 LLM 调用”。这三种形态对应不同的复杂度和可控性。单代理循环(ReAct 模式)最容易上手,但容易出现无限循环和重复工具调用;多代理系统(如规划者、执行者、评审者分离)能提升任务分解能力,但通信开销和状态管理难度陡增;确定性工作流加 LLM 节点则在可预测性和灵活性之间取得平衡,适合业务流程明确的场景。
节点内部做什么同样关键。常见模式包括:节点负责一次 LLM 调用并解析输出、节点执行工具调用并更新状态、节点做条件判断决定下一跳。帖子追问“节点里发生什么”,实际上是在关注状态变更的粒度和副作用管理。一个被社区反复提及的经验是:让节点尽量小、职责单一,状态更新显式且可序列化,这样检查点和恢复才有意义。否则,一个巨大的节点会让调试变成黑盒。
调试之痛:循环、重复调用与状态问题
帖子列出的最难调试问题——意外循环、重复工具调用、执行失败、错误决策、昂贵运行、状态问题、长时工作流——几乎覆盖了 LangGraph 应用的主要故障模式。其中,意外循环和重复工具调用最为常见,往往源于模型对终止条件的误判或工具返回结果未被正确解析。状态问题则多出现在并行分支合并或检查点恢复时,状态字段被覆盖或遗漏。昂贵运行既可能是循环导致,也可能是上下文不断累积、每次调用都携带全部历史。
长时工作流的调试尤其棘手,因为一次运行可能跨越数分钟甚至数小时,中间涉及外部 API 超时、人工审批等待等。帖子最后问“出错时你希望看到什么信息”,这直指可观测性缺口。开发者普遍希望看到:每个节点的输入输出快照、状态变更 diff、每次 LLM 调用的 token 消耗和延迟、工具调用的原始请求与响应、以及完整的执行路径图。这些信息如果靠打日志拼凑,成本很高;理想情况下应由框架或配套工具自动采集。
LangSmith 是 LangChain 官方提供的可观测性平台,可与 LangGraph 集成,自动采集每次运行的完整调用树:包括每个节点的输入输出、每次 LLM 调用的 prompt 与 completion、token 消耗、延迟以及工具调用的原始请求与响应。开发者可以在界面上按执行路径逐层展开,快速定位是哪个节点产生了错误决策或意外循环。对于合规要求高或希望自托管的团队,也可以基于 OpenTelemetry 等标准自建追踪,将 LangGraph 的节点执行事件导出到现有监控体系。无论采用哪种方案,核心目标一致:把“打日志拼凑”变成结构化、可检索的执行记录,让长时工作流的故障定位从黑盒变成白盒。
生产落地的关键:可观测性与确定性
综合来看,这个帖子虽未给出答案,却精准命中了 LangGraph 从演示走向生产的关键矛盾:灵活性与可控性的平衡。LangGraph 提供了强大的编排能力,但生产系统需要可预测的行为、清晰的故障定位和成本控制。因此,团队在选型时不妨反向思考:先明确哪些环节必须确定性执行,哪些可以交给 LLM;再设计状态结构和检查点策略;最后补齐可观测性(如 LangSmith 或自建追踪)。技术栈的选择应服务于这些约束,而非追逐框架热度。
对于正在使用 LangGraph 的团队,帖子中的问题清单可以作为一次内部复盘的自查表:你的图结构是否足够简单?节点职责是否单一?状态是否可序列化?出错时能否快速定位到具体节点和调用?回答好这些问题,比选择哪个向量数据库更能决定项目的成败。
相关推荐
用Claude+MCP打造Jarvis:零硬件改造接入智能家居
一位创作者用Claude Code生成MCP Server,通过涂鸦Smart Life平台API直连智能灯泡,绕开Alexa和Google Home,实现语音控制灯的Jarvis式体验。本文拆解四步搭建流程、技术原理与方案局限。

REA:用AI Agent逆向工程任何软件
REA(Reverse Engineer Anything)是一款专为AI编程代理设计的MCP服务器和技能包,支持Cloud Code、Cursor等工具,可逆向分析JavaScript、Electron、二进制、Android应用和固件。本文详解其工作流程、支持平台、本地分析优势与能力边界,并提醒合法使用。
AI代理五个权限等级:从ChatGPT问答到全自动Agent
把AI代理权限拆成五个等级:从ChatGPT纯对话、项目文档、MCP连接器、Computer Use自动点击到无人值守代理,逐级分析能力边界、提示注入风险与审批疲劳,并给出默认只读、不可逆操作人工确认、按项目隔离三条实操规则。