LangGraph中断机制解析:节点重跑与审批载荷安全
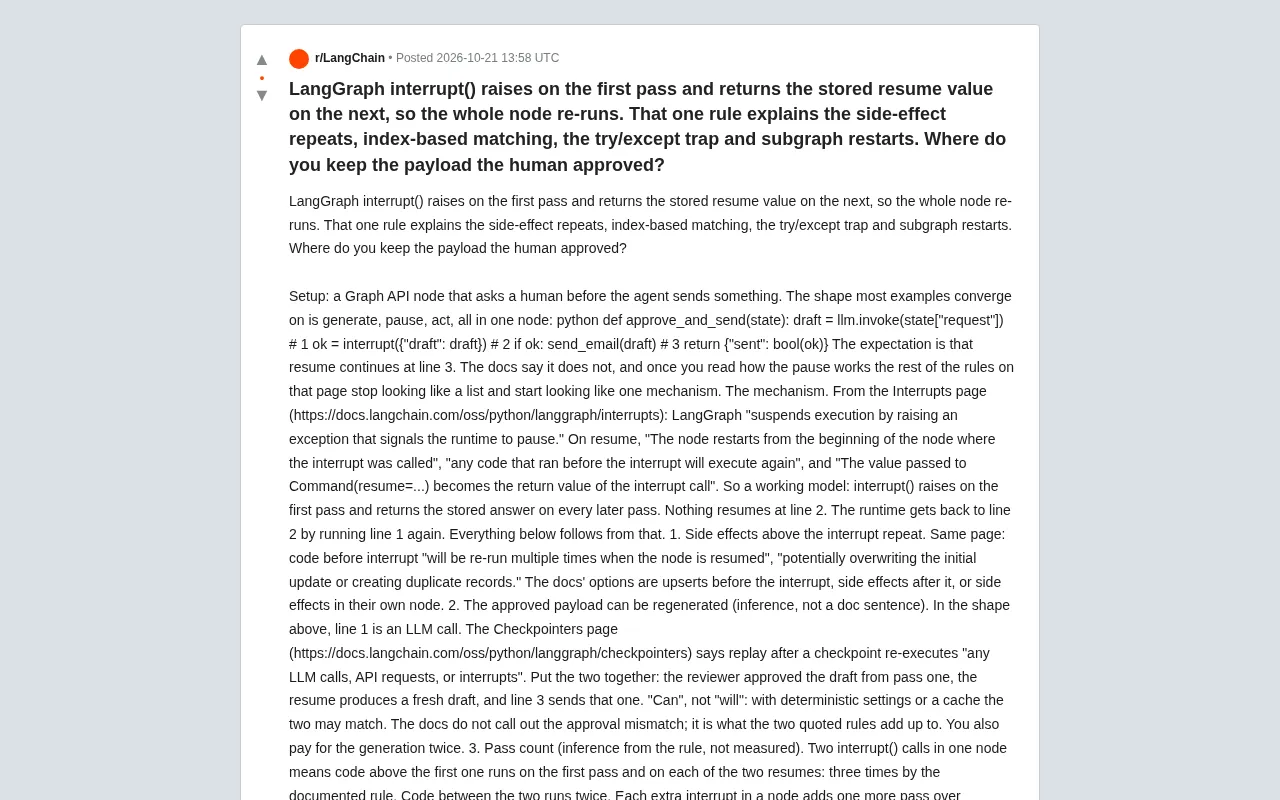
LangGraph 的 interrupt() 恢复时重跑整个节点,可能导致审批载荷被重新生成而与实际执行不一致。
文章澄清了 LangGraph `interrupt()` 常被误解的机制:首次调用通过抛出异常暂停,恢复时整个节点从头重跑,`interrupt()` 返回存储的恢复值,而非从下一行继续。这一规则衍生出四类陷阱:中断前的副作用会重复执行;恢复值按索引严格匹配,中断顺序必须稳定;宽泛的 try/except 会吞掉暂停异常导致图永不暂停;子图中断会使父节点从头重启。最危险的是审批场景:若 LLM 生成放在 `interrupt()` 之前,恢复时会重新生成草稿,审批者看到的与实际发送的可能不是同一份,且需为两次生成付费。文章对比了前驱节点生成、中断后基于恢复值执行、Functional API 的 `@task` 以及下游幂等键等方案,建议将生成前置、保持中断节点无副作用,并始终加幂等键,同时提供测试代码用于在本地版本上验证行为。
LangGraph 的 interrupt() 机制常被误解为“从暂停处继续执行”,但实际行为是:首次调用时抛出异常暂停,恢复时整个节点从头重跑,interrupt() 返回存储的恢复值。这一条规则解释了副作用重复、基于索引的匹配、try/except 陷阱以及子图重启等所有现象。对于需要人工审批的 Agent 流程,最危险的问题是:审批者看到的载荷,和最终执行的载荷,可能不是同一个。
核心机制:暂停即抛出异常,恢复即重跑节点
根据 LangGraph 官方文档(Interrupts 页面),当调用 interrupt() 时,运行时通过抛出异常来暂停执行。恢复时,节点会从开头重新运行,之前执行过的代码会再次执行,而 Command(resume=...) 传入的值成为 interrupt() 的返回值。这意味着没有任何代码会从 interrupt() 下一行“接着跑”——运行时是通过重新执行整个节点,再次到达 interrupt() 调用处,然后返回存储的恢复值。这一机制是理解后续所有行为的基石。
一个典型的审批节点模式如下:
def approve_and_send(state):
    draft = llm.invoke(state["request"])  # 1
    ok = interrupt({"draft": draft})      # 2
    if ok:
        send_email(draft)                 # 3
    return {"sent": bool(ok)}
许多示例期望恢复后从第 3 行继续,但文档明确指出并非如此。恢复时,第 1 行会再次执行,生成新的草稿,然后 interrupt() 返回审批结果,第 3 行发送的是这个新草稿。
LangGraph 的持久化依赖 Checkpointer(检查点保存器)。每个 thread_id 对应一条执行轨迹,图在每一步(super-step)结束后会把整个状态快照写入检查点。interrupt() 能够“暂停”正是因为运行时在抛出异常前把当前状态与待恢复的任务信息一并持久化;恢复时依据检查点重建执行上下文,并从节点入口重新调度。常见的 Checkpointer 实现包括 InMemorySaver(仅进程内有效,适合测试)和基于 SQLite/Postgres/Redis 的持久化实现(适合生产)。需要注意:检查点保存的是状态而非 Python 栈帧或局部变量,这正是“恢复即重跑”而非“断点续行”的根本原因——运行时没有保存执行位置的机制,只能靠重新执行到 interrupt() 调用处来复现上下文。
隐藏陷阱:审批载荷可能被重新生成
上述模式中,第 1 行是 LLM 调用。Checkpointers 文档指出,从检查点恢复会重新执行“任何 LLM 调用、API 请求或中断”。两个规则叠加,导致审批者批准的是第一轮生成的草稿,而恢复时生成的是新草稿,最终发送的是未经审批的新版本。文档没有明确警告这种审批不匹配,但这是两条规则的逻辑推论。此外,你还需要为两次生成付费。
如果生成过程是确定性的或使用了缓存,两次结果可能相同,但“可能”不等于“一定”。对于审批流程,这种不确定性是不可接受的。
其他衍生规则:副作用、索引匹配与异常处理
副作用重复:文档警告,interrupt() 之前的代码在节点恢复时会重复执行,可能覆盖初始更新或创建重复记录。官方建议将幂等操作放在中断前,或把副作用移到中断后,或放在独立节点中。
恢复值按位置匹配:LangGraph 为每个任务维护一个恢复值列表,严格按索引匹配。因此中断调用的顺序至关重要,不能有条件地跳过某个 interrupt(),也不能在非确定性逻辑上循环调用。否则,存储的答案可能落到错误的问题上。
宽泛的 except 会吞掉暂停:文档明确禁止用裸 try/except 包裹 interrupt(),因为异常会被捕获,中断信号无法传回图,图永远不会暂停。任何同时包含 interrupt( 和 except Exception 的节点都值得用 grep 检查。
子图重启父节点:当在节点内调用会中断的子图时,父图会从调用子图的节点开头重新执行,子图也从自己的节点开头恢复。父节点中位于子图调用之前的代码也会重跑。
Command(resume=...) 是 LangGraph 中用于恢复中断的特殊控制对象。普通 invoke 传入的是新的输入状态,而 Command 携带的是控制指令:resume 字段的值会被投递给对应的 interrupt() 调用作为返回值,goto 字段则可跳转到指定节点。多个 interrupt() 在同一任务中按出现顺序被分配索引,恢复值列表就按这个索引一一对应,这也是“按位置匹配”的来源。若一次恢复传入的是单个值而非列表,它只对应第一个待恢复的中断。理解 Command 与普通输入的区别很关键:混用二者会导致状态被意外覆盖,或在应当恢复时开启了新一轮执行。
解决方案对比:如何安全传递审批载荷
针对审批载荷的安全问题,有几种常见方案,各有适用场景:
- 将预生成工作放在节点内:仅适用于只读或幂等操作(如获取数据、基于稳定 ID 的 upsert)。对于任何创建、追加、发送或扣费的操作,以及需要人工审批的 LLM 输出,这种做法是错误的。
- 由前驱节点生成,中断节点只读取状态:草稿在暂停前被检查点保存,审批的就是存储的版本。代价是多一个节点和一个状态字段,且如果前驱节点中途失败,重试时会重跑。
- 在中断后基于恢复值执行:人类编辑后的载荷直接执行,如工具示例中处理编辑参数的方式。但同一节点中后续的中断再次暂停时,中断后的代码仍会重跑。
- 使用 Functional API 与 @task:入口点恢复时也从开头执行,但已完成的任务会从检查点加载结果,而不是重新计算。将副作用、API 调用和非确定性工作放入 task 中,可以消除已完成任务的重复执行问题。然而,未完成的任务在恢复时可能再次运行,因此下游写入仍需幂等。@task 是“从检查点重放”,不是“恰好一次”。
- 下游系统幂等键:对于资金、邮件和外部写入,始终需要幂等键。它能防止重复,但不能解决发送未经审批载荷的问题。
我的默认建议是:在 Graph API 审批流程中,不要发布那种“被审批的内容在 interrupt() 之上计算”的节点。将生成提前一个节点,保持中断节点无副作用,基于恢复值或存储状态执行,而不是重新计算的值。然后无论如何加上幂等键,因为审批和恰好一次是两个不同的问题。
Functional API 与 @task 是 LangGraph 提供的另一种编程范式:用普通 Python 函数配合 @entrypoint 和 @task 装饰器构建工作流,而非显式的 StateGraph。其关键差异在于 @task 的返回值会被检查点记录,入口点恢复时虽然也从函数开头执行,但已完成 task 的调用会直接返回检查点中的结果而跳过实际计算——这就是文中“从检查点重放”的含义。它与 Graph API 的节点重跑形成对比:节点重跑会真正重新执行内部代码,而 @task 会短路已完成部分。但两者共同的边界是:未完成的 task 或节点在恢复时仍会再跑一次,因此“恰好一次”语义必须由下游幂等机制兜底,@task 本身并不提供。
验证测试:在你的版本上确认行为
由于 Interrupts 文档没有标注日期,最好在实际运行的 LangGraph 版本上验证。以下是一个概念性测试代码(根据你的版本调整名称):
calls = {"gen": 0, "send": 0, "sent": None}

def node():
    calls["gen"] += 1
    draft = ...
    ok = interrupt({"draft": draft})
    if ok:
        calls["send"] += 1
        calls["sent"] = draft

graph = builder.compile(checkpointer=InMemorySaver())
cfg = {"configurable": {"thread_id": "t1"}}
first = graph.invoke({"request": "..."}, cfg)
shown = first["interrupt"]
graph.invoke(Command(resume=True), cfg)
assert calls["send"] == 1
assert calls["sent"] == payload_of(shown)
print(calls["gen"])  # 期望为 2(简单模式)
如果 gen 打印 2 且第二个断言在非确定性生成器下失败,说明第 2 点的问题在你的机器上存在。将生成移到前驱节点后,两个断言都应通过。
幂等键(idempotency key) 是分布式系统中保证“同一操作重复提交只生效一次”的通用手段:调用方为每次逻辑操作生成唯一标识(如 UUID 或内容哈希),下游服务记录已处理的键,重复请求直接返回首次结果。在 Agent 审批场景中,它解决的是重复执行问题——节点重跑导致 send_email 被调用两次时,下游凭同一键去重。但它不解决审批载荷被重新生成的问题:如果重跑生成了不同的草稿,幂等键只会让第二次发送被拒绝或返回旧结果,而掩盖了“审批内容与实际内容不一致”的事实。因此文中强调审批一致性与恰好一次是两个正交的问题,需要分别用“前驱节点存储载荷”和“幂等键”两套机制处理。
开放问题:审批载荷存哪里?
对于运行 Graph API 审批流程的开发者,一个实际问题是:你把人类批准的载荷存在哪里?是在前驱节点写入的状态中,还是在恢复值本身,或者其他地方?有没有人将批准载荷的哈希与执行载荷一起存储,以便审计证明两者一致?欢迎分享你的实践。
(本文基于 Reddit 讨论及 LangGraph 官方文档整理)
相关推荐
VCP V工程实测:Token缓存95%命中,AI控制AI螺旋编程
VCP V工程实测:单轮对话Token缓存命中率95%以上,用AI控制AI实现螺旋编程,主控Agent策划、施工Agent写码,已策划工程可完全脱手。附完整配置步骤与局限分析。
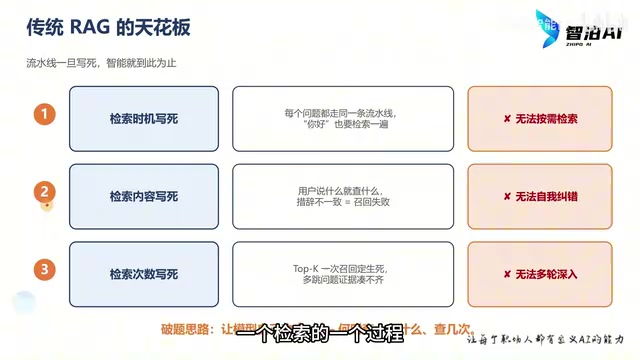
Agentic RAG实战:从原理到代码,手把手搭建智能检索系统
传统RAG检索时机、内容、次数全部写死,导致答非所问。本文基于B站教程拆解Agentic RAG原理:将检索封装为工具交给大模型自主决策,附四工具设计与完整代码实现,手把手搭建能自我纠错、多跳查询的智能检索系统。
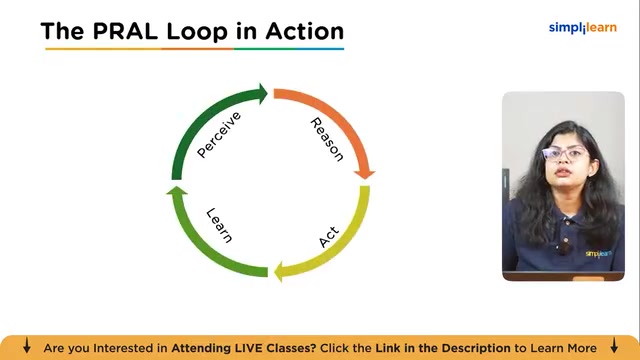
1小时搞懂Agentic AI:架构、设计模式与实战搭建
Simplilearn的Agentic AI速成课程解析:智能体三层架构(感知、认知、动作)、单智能体与多智能体对比、感知推理执行学习循环、三种设计模式,以及研究智能体、应用构建和反馈修复循环的实战演示。