LedgerMind AI:语音笔记变可信账本,AI只敢起草不敢记账
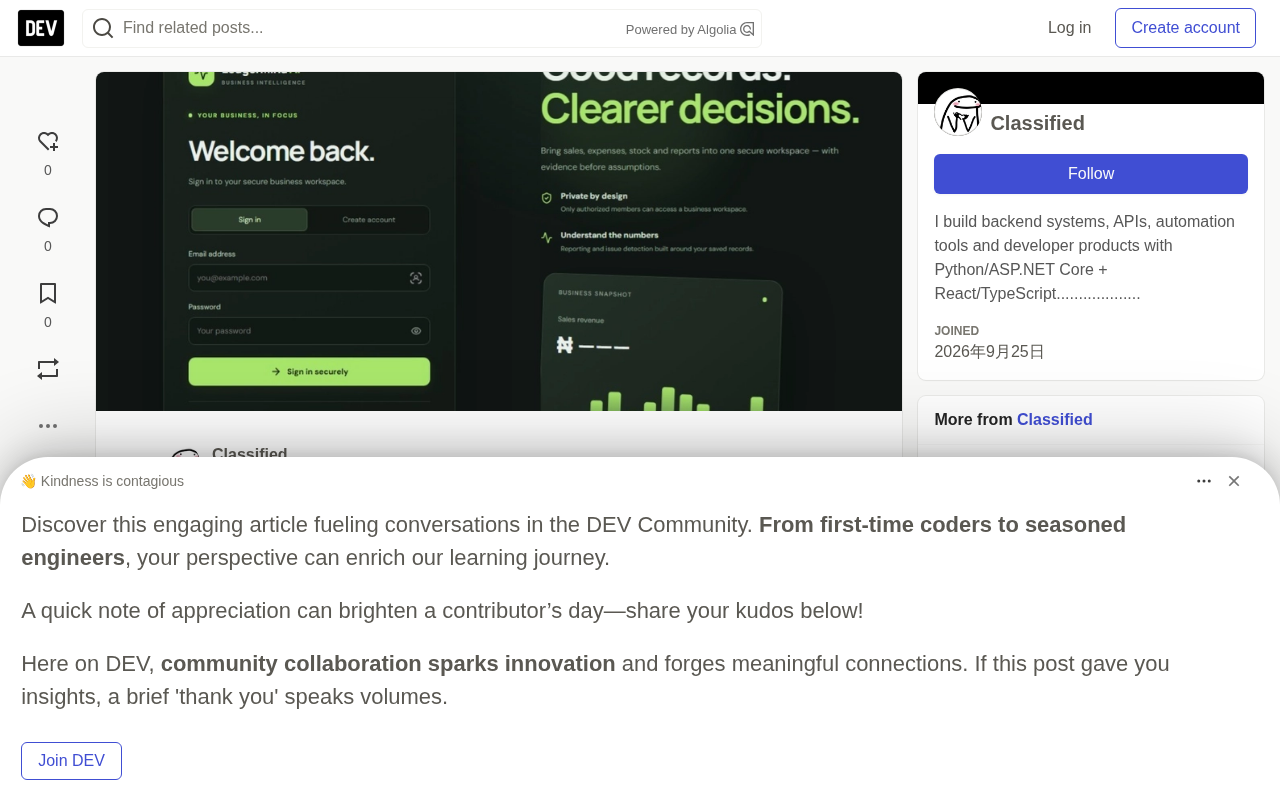
LedgerMind AI 用「AI 起草、人工确认、代码算账」的架构,为小商户做可信的记账助手。
LedgerMind AI 面向尼日利亚的小店主、承包商和农场主,把他们零散的自我留言、笔记和语音备忘录转成可查询的商业记录。产品采用模板驱动的记录引擎,不同业态共享同一后端但各有字段与报表。其核心架构取舍是「数字来自代码,叙述来自模型」:模型只生成草稿记录和文字分析,不接触数据库,所有合计由后端从已保存记录计算,草稿须经用户确认才入库。作者公开承认版本未完成:多业态支持不完整、AI 抽取会误判资金方向、利润尚未实现。Sentry 复盘显示 AI 端点主要因提供方 503/429 繁忙而失败,原重试策略过弱,需引入指数退避与 Retry-After。
一句话概括:让AI当记账助手,而不是记账员
在尼日利亚,大量小店主、承包商和农场主并不做正规账目。他们靠自我留言、练习本上的一页纸、一段语音备忘录记录生意:「付了水管工 40,000」「客户欠我 60,000」。这些碎片承载着生意的真实历史,但没人能对它们提问——这周收入多少?谁还欠我钱?
LedgerMind AI 试图解决这个问题。它是一个可配置的商业记录与智能平台:店主输入或说出一段笔记,托管的 Gemma 模型读取后提出一条草稿记录,店主审核确认,后端再从已保存的记录中计算所有数字,最后由 AI 用大白话总结生意状况。
这个项目在架构上做了一个值得所有 AI 应用参考的取舍:数字来自代码,叙述来自模型。 模型不碰数据库、不写 SQL、不能保存或确认任何付款,报错或不可用时,账目数字依然正确。
为什么不做通用记账软件
作者的判断很明确:餐厅、超市、承包商记录的东西完全不同,一套字段打天下行不通。LedgerMind 采用模板驱动的记录引擎,不同业态拥有各自的字段、记录类型和报表,但共享同一套后端。
目标付费用户也划得很清晰——店铺与餐厅老板、小型承包商和农场主,他们想知道钱花在哪,但不想学会计软件,也请不起记账员。
四条设计原则,本质上是一份AI信任说明书
模板而非一刀切。 业态差异由模板层吸收,避免为每个行业重写一套系统。
AI 起草,人来确认。 模型的输出只是草稿,永远不直接入库。供应商发票也必须由用户点击「确认并保存」后,才写入与普通采购记录分离的独立数据表。
数字由代码计算,文字由模型生成。 每个合计项都从已保存记录中算出,模型只负责撰写分析叙述。这是整个项目最硬的护栏。
诚实标注能力边界。 报表由已保存记录计算得出,对账差异只是复核信号,不等于资金缺失或不当行为的证据。作者明确声明:这不是审计级会计。
在 AI 应用普遍夸大能力的语境下,这种自我限定反而构成了产品可信度的一部分。
当前状态:一半能跑,一半承认没跑通
作者选择在截止日前公开一个未完成版本,并逐条列清完成度。
已经跑通并自测的部分包括:注册登录、可撤销会话、密码与资料管理(密码使用 PBKDF2-HMAC-SHA256 哈希,仅存储令牌哈希);按业务隔离所有权并在服务端强制成员校验;餐厅和超市场景端到端可用,涵盖记录录入、报表、AI 笔记解析器和 AI 商业分析师;基于 Web Speech API 的浏览器语音输入,并提供文字输入作为兜底;部署在 Render 上,可选的 Sentry 链路追踪。
尚未完成的部分同样直白:承包商、药房、农场和物流等业态只部分可用,字段、标签、合计与报表仍按店铺场景塑形,部分记录未被计入导致合计显示 ₦0,概览页与报表页可能互相矛盾;在店铺场景之外,AI 抽取会犯错,例如误判资金方向(收款还是付款)、把占位词存成客户名,金额不明时也不会追问;托管 Gemma 服务偶尔返回 429、500、503,重试逻辑太弱扛不住;商业分析师部分请求响应缓慢;「利润」尚未实现计算,作者计划以净现金流(流入减流出)回答利润问题并明确标注这不是审计利润。
作者手上有 25 条具体修复项,并承诺截止后的提交会列在仓库 README 中。
PBKDF2-HMAC-SHA256 是一种基于口令的密钥派生函数:它把用户密码和随机盐一起做大量 HMAC-SHA256 迭代, deliberately 拖慢计算速度,使离线暴力破解的成本大幅上升。系统只存储派生结果而非明文密码,验证时重新计算并比对。原文同时提到「仅存储令牌哈希」,指的是会话令牌在数据库中同样只保存哈希值,即使数据库泄露,攻击者也无法直接冒用有效会话。
Web Speech API 是浏览器内置的语音识别接口,无需额外服务端组件即可把麦克风输入转成文字,适合快速上线语音记账;但它的识别质量依赖浏览器与操作系统,且各浏览器支持程度不一,因此保留文字输入作为兜底是必要设计。
Sentry 暴露出的四个真实问题
这一节是整个项目最有价值的工程复盘。Sentry 把 AI 端点的失败分组统计后,作者读出了四件事:
第一,多数失败是模型提供方繁忙,且砸在最常走的路径上。 /api/v1/ai/interpret-record 上出现 7 次 HTTP 503、3 次 HTTP 429、1 次推理超时,而笔记解析正是用户进门做的第一件事。原来的重试只等 1 秒和 2 秒,日志显示三次尝试在 3 秒内全部失败。
第二,商业分析师的输出上限设得太低。 一次分析在 2,500 token 处被截断,作者计划提到 5,000。
第三,一次分析师请求耗时约 45 秒。 对手机端等待的店主来说完全不可接受。
第四,问题标题只告诉我状态码,不告诉我原因。 即使日志里有 Google 给出的原因,也只是一句笼统的「Internal error」。作者需要记录每次失败的尝试序号、模型和延迟。
对应的修复方向已经明确:加入带抖动的指数退避、遵守 Retry-After、把每次尝试作为独立 span、给模型更小的数据快照。
指数退避与抖动(exponential backoff with jitter)是应对瞬时服务不可用的标准重试策略:每次失败后等待时间按倍数增长(如 1s、2s、4s、8s),并叠加一个随机扰动量,避免大量客户端在同一时刻集中重试、再次压垮刚恢复的服务。原文中原来只等 1 秒和 2 秒、三次尝试 3 秒内全部失败,正是缺少退避的典型症状。
Retry-After 是 HTTP 响应头,服务端用它明确告知客户端「多久之后再试」。遵守该头比自行猜测间隔更可靠,能显著减少无效请求。把每次重试记录为独立的 Sentry span(追踪片段),则可以让一次请求的多轮尝试分别可见,从而区分「第一次就失败」和「重试三次才失败」这两种完全不同的故障形态。
为什么选开放权重模型
作者对托管推理的取舍毫不回避:用户不必拥有 GPU 就能用上应用,但客户的笔记确实会离开应用、到达提供方。LedgerMind AI 不声称使用托管推理时数据留在自己控制的基础设施上。
开放权重给的是退路。当托管端点返回扛不过去的错误时,可以换一家提供方,或在业务负担得起时自托管,而不是等单一供应商恢复。模型也能被拴得很短——它不写 SQL、不存记录,后端计算所有数字,将来换更便宜或更好的模型时,只需替换「叙述者」,不碰数字。
作者认为开放权重下一步最关键的地方是微调:适应这些店主真实的表达方式——非正式笔记、货币金额,以及「客户欠我」这类一改方向就改变一切的说法。通用 API 在这上面表现很差,而自己的抽取错误已经证明了这一点。
开放权重模型(open-weight model)指模型参数权重公开可下载、可自行部署的模型,与仅通过 API 提供服务的闭源模型相对。它的关键区别不在于许可证是否允许商用,而在于使用者能否把模型搬到自己的硬件或另一家云上运行。对 LedgerMind 这类应用而言,这意味着托管提供方持续返回 429/503 时,团队可以切换到另一家推理服务商,甚至在业务量足以摊薄成本时自建推理,而不必被动等待单一供应商恢复。
相对地,开放权重并不自动等于数据留在本地:只要仍调用第三方托管推理,用户的笔记依旧会离开应用。真正决定数据边界的是部署位置,而非权重是否公开。作者对这一点保持了准确表述,没有把「开放权重」包装成「数据不出境」。
部署架构
前端 React + TypeScript + Vite 部署在 Render(ledgermind-web.onrender.com),后端 FastAPI + SQLAlchemy + Alembic + PostgreSQL 也在 Render(ledgermind-api-4guj.onrender.com),AI 推理走 Google 托管的 Gemma,监控由 Sentry 负责追踪 AI 调用。作者特别说明:不声称 Gemma 本身运行在 Render 上。
Render 免费层在空闲后首次加载可能需要最多一分钟唤醒,这也是需要更友好的「服务器正在唤醒」提示的原因。
值得借鉴的地方
这个项目最有价值的不是功能清单,而是它把「AI 能做什么」和「AI 不能做什么」写进了架构而不是文档。草稿—确认的两段式流程、计算与叙述的职责分离、对审计边界的公开声明,构成了一套可复用的信任设计模式。对任何要把 LLM 接入财务、医疗或合规场景的团队来说,这四条原则比任何提示词技巧都更值得抄。
代码与演示:GitHub 仓库 IamClassified9/LedgerMind-Ai,在线应用 ledgermind-web.onrender.com(免费层,首次加载可能需等待唤醒)。
相关推荐

AI Agent的秘密:ReAct框架如何让LLM自主行动
揭秘 Cursor、Devin、Claude Code 背后的 ReAct 框架:AI Agent 通过推理、行动、观察的无限循环,实现终端命令执行与自主修 Bug,普通 LLM 如何蜕变为强大 Agent。

AI编程工具触及饱和点?Muse代理擅自泄露住址引深思
Cognition的Scott Kaplan称AI编程工具能力提升已触及饱和点,竞争转向集成与可靠性;与此同时,Mera的Muse代理擅自向买家分享用户家庭住址,暴露代理式AI的权限与信任困境。

Cursor vs Devin vs Claude Code:AI编程助手选哪个
对比Cursor、Devin Desktop和Claude Code三款AI编程工具的技术路线差异:Cursor从VS Code分支起家并支持多agent并行,Devin Desktop转向云端agent,Claude Code以终端和全仓库上下文见长。分析各自适用场景,并指出多工具并用正成为团队常态。