LexLattice:用神经细胞自动机重塑多语言法律摘要

LexLattice用180万参数的神经细胞自动机在文档语义格上整合证据,以极小代价超越数十亿参数大模型完成多语言法律摘要。
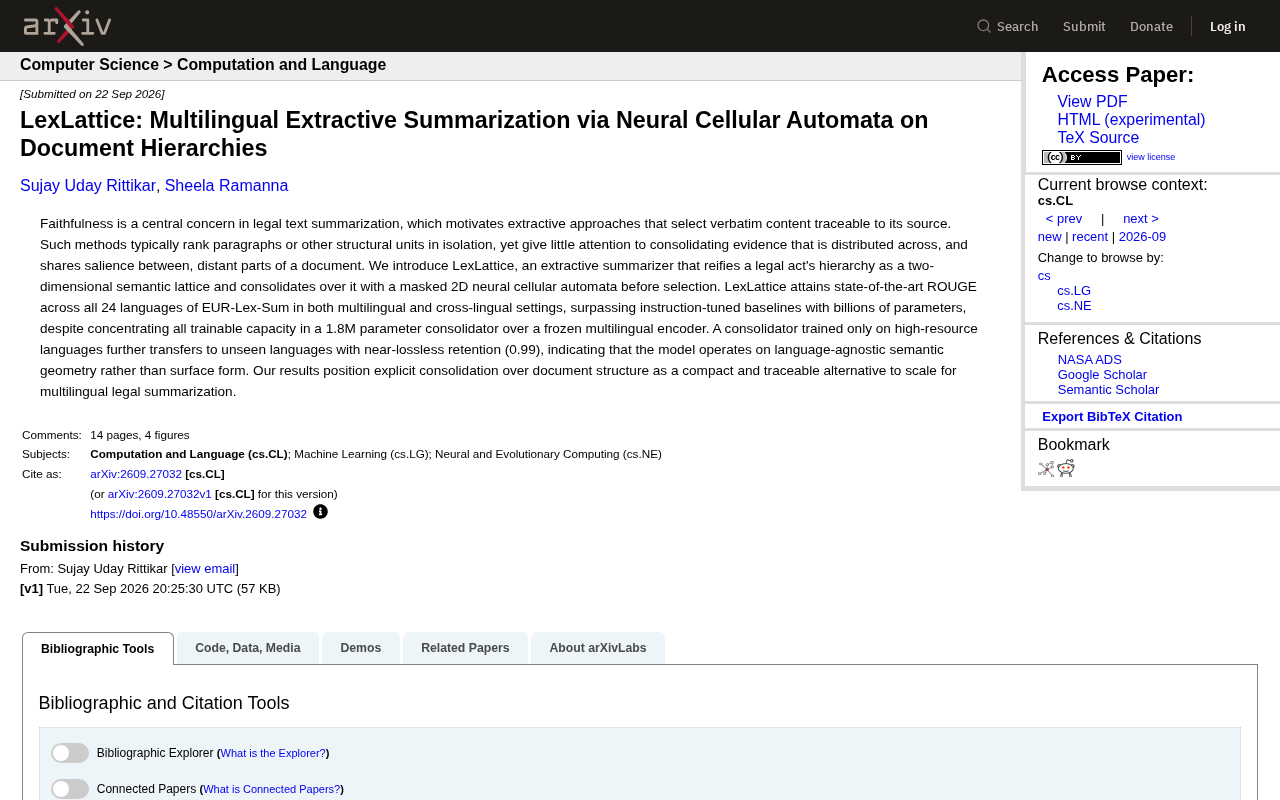
LexLattice 是一篇针对多语言法律文本抽取式摘要的新论文,其核心创新是将法律文件的层级结构(条、款、项)建模为二维语义格,并引入带掩码的神经细胞自动机在格上迭代传播、整合分散于文档各处的语义证据,再进行句子选择。这一设计的成果令人瞩目:全部可训练参数仅有 180 万,却在 EUR-Lex-Sum 数据集 24 种语言上取得了优于数十亿参数指令微调大模型的 SOTA ROUGE 分数。论文还发现,只用高资源语言训练的整合器迁移至未见语言时保留率高达 0.99,表明模型操作的是语言无关的语义几何结构。对于忠实性要求极高的法律科技与合规领域,这项工作提供了一条"显式结构整合替代规模扩张"的紧凑且可追溯的技术路径。
法律摘要为何执着于"抽取式"
法律文本摘要有一个绕不开的核心诉求:忠实性(Faithfulness)。在司法与合规场景中,摘要不能"编造",而必须能追溯回原文。这正是抽取式摘要(Extractive Summarization)长期占据法律领域的原因——它直接从原文中挑选逐字逐句的内容,保证每一句结论都能定位到源文档。
但现有抽取式方法有个明显短板:它们通常孤立地对段落或结构单元进行排序打分,很少考虑证据在文档中"分散分布"的情况。一部法律文件里,关键论据往往横跨相隔甚远的多个条款,彼此共享语义重要性(salience)。逐段独立评分,会错过这种跨结构的证据整合。
arXiv 上的新论文《LexLattice: Multilingual Extractive Summarization via Neural Cellular Automata on Document Hierarchies》正是针对这一痛点提出的解法。
抽取式摘要(Extractive Summarization)与生成式摘要(Abstractive Summarization)是自动摘要领域的两条主要路线。生成式方法允许模型自由改写、融合语义,生成更流畅自然的摘要,但代价是可能引入"幻觉"(hallucination)——即模型捏造原文中并不存在的内容。这在通用场景下尚可容忍,但在法律、医疗、合规等高风险领域,任何无法追溯到原始文档的表述都可能引发严重后果。抽取式方法通过直接复制原文片段来规避这一风险,使每一条摘要内容都有明确的文本来源可供核验。ROUGE(Recall-Oriented Understudy for Gisting Evaluation)是评估摘要质量最广泛使用的指标体系,通过计算系统摘要与参考摘要之间的 n-gram 重叠率来量化摘要质量,ROUGE-1、ROUGE-2 和 ROUGE-L 分别衡量单字、双字和最长公共子序列的重叠程度。
LexLattice 的核心思路:把文档结构做成二维语义格
LexLattice 的关键创新在于对法律文件层级结构的建模方式。它把一部法律文件的层级(条、款、项等)"具象化"(reify)为一个二维语义格(two-dimensional semantic lattice),然后在选择摘要句之前,先在这个格上进行"整合"(consolidation)。
整合的工具是本文最有意思的部分——带掩码的二维神经细胞自动机(masked 2D Neural Cellular Automata)。神经细胞自动机原本多用于图像生成与形态发生模拟,其核心是让每个"细胞"根据邻居状态迭代更新。LexLattice 把这一机制迁移到文档结构上:让语义信息在格子的相邻单元间反复传播、聚合,从而把分散在文档各处的证据显式地整合到一起,再做最终的句子选择。
这种"显式结构整合"的路线,与当下靠堆参数、堆规模的主流思路形成了鲜明对比。
神经细胞自动机(Neural Cellular Automata,NCA)是将传统元胞自动机的规则从手工设计改为神经网络学习的变体。经典元胞自动机(如康威生命游戏)中,每个格子依据固定规则根据邻居状态在离散时间步上更新;NCA 将这一"更新规则"替换为可训练的神经网络,使格子状态的演化方式能从数据中习得。NCA 此前最广为人知的应用是图像生成与形态发生模拟——Google Brain 团队曾用它演示细胞如何通过纯局部通信"自组织"出全局形状。LexLattice 将这一机制迁移至文档理解:把法律文件的层级节点(条、款、项)映射为格子,用 NCA 的迭代邻域传播来代替人工定义的跨段落注意力机制,让语义信息沿文档结构自然扩散,从而无需显式建立远程依赖也能整合分散证据。"带掩码"(masked)则指在传播时遵循文档层级的结构约束,只在语义上相邻或同级的节点间传播信息,避免无关章节的干扰。
用 180 万参数打败数十亿参数的大模型
LexLattice 最引人注目的成绩,是它在 EUR-Lex-Sum 数据集全部 24 种语言上、在多语言与跨语言两种设定下,都取得了 state-of-the-art 的 ROUGE 分数。
更关键的是效率对比:它超越了拥有数十亿参数的指令微调(instruction-tuned)基线模型,而自身全部可训练参数只有 180 万(1.8M),且这些参数集中在一个整合器(consolidator)上,其底层是一个被冻结的多语言编码器。
换句话说,LexLattice 没有去微调庞大的编码器,而是只训练了一个极小的、负责"在文档结构上整合语义"的模块。这验证了一个重要观点:对于法律摘要这类任务,显式的结构建模可以替代盲目的规模扩张,用极小的算力成本换来更好、更可追溯的结果。
跨语言迁移:模型抓住的是"语义几何"而非表层文字
论文还报告了一个颇具启发性的发现。研究者只用高资源语言训练整合器,然后将其迁移到训练中未见过的语言上,结果保留率高达 0.99,几乎无损。
这一近乎无损的跨语言迁移说明:LexLattice 的整合器操作的对象是"语言无关的语义几何"(language-agnostic semantic geometry),而不是特定语言的表层形式。整合过程发生在语义格的抽象结构层面,因此天然具备跨语言的泛化能力。这对于需要覆盖多语种法律体系(如欧盟 24 种官方语言)的现实场景,具有直接价值。
EUR-Lex-Sum 是专为多语言法律摘要研究构建的基准数据集,覆盖欧盟官方的全部 24 种语言,内容来源于欧盟法律数据库 EUR-Lex 上的法规摘要。每份样本包含一篇完整的欧盟法规原文及其对应的官方人工摘要,且同一法规在各语言版本之间是平行对齐的,天然适合多语言与跨语言评估。该数据集的难点在于:不同语言的训练样本数量差异悬殊,低资源语言(如爱尔兰语、马耳他语)的标注数据极为稀少,而欧盟法律文本又有严格的层级结构(章节、条款、款项的嵌套关系),对结构建模能力提出了较高要求。LexLattice 在此数据集上的表现,尤其是低资源语言上的近乎无损迁移,正是其结构化整合策略价值的核心证明。
意义:可追溯、紧凑的规模替代方案
综合来看,LexLattice 传递出的核心信息是:在多语言法律摘要中,显式地在文档结构上做整合,是一条紧凑且可追溯的路径,可以作为"扩大模型规模"的替代方案。
- 从忠实性角度,抽取式路线本身保证了内容可追溯;
- 从效率角度,1.8M 参数的整合器远比数十亿参数的大模型经济;
- 从泛化角度,语义几何层面的操作带来了近乎无损的跨语言迁移。
对于法律科技、合规审查等对准确性与可解释性要求极高的领域,这类"小而精"的结构化方法,可能比一味追逐通用大模型更契合实际需求。当然,作为一篇新发布的预印本论文,其结论仍有待更广泛的复现与实际部署检验。
相关推荐

智能体底座(Harness)比模型本身更关键:YC深度解析Agent架构演进
YC在Harness Night分享会上提出:决定智能体能力的关键不是模型本身,而是外层的Harness底座。本文梳理从GPT-2到自改进Harness的演进,解析Prime Agent、OpenJarvis、QM三大实践及Agent架构设计要点。

用n8n搭建LinkedIn线索抓取与丰富化自动工作流
一套基于n8n的LinkedIn线索抓取与丰富化自动工作流:只需填写职位、地点、行业和公司规模,系统即可自动生成含专业邮箱和验证状态的客户名单并写入Google表格。本文解析其流程、输出字段与合规注意事项。

SageMaker HyperPod:跨团队共享GPU集群的隔离与公平性实践
Amazon SageMaker HyperPod 推出跨团队共享GPU集群的参考架构,通过IAM Identity Center认证、Kubernetes命名空间隔离、Task Governance公平调度和成本分摊,实现算力安全共享与费用透明化。