LFM2.5-24B-A2B实测:在Pi Agent中扛住高强度任务

Reddit 用户实测 LiquidAI 新模型 LFM2.5-24B-A2B 在 Pi Agent 工作流中表现惊艳,机械任务稳定可靠。
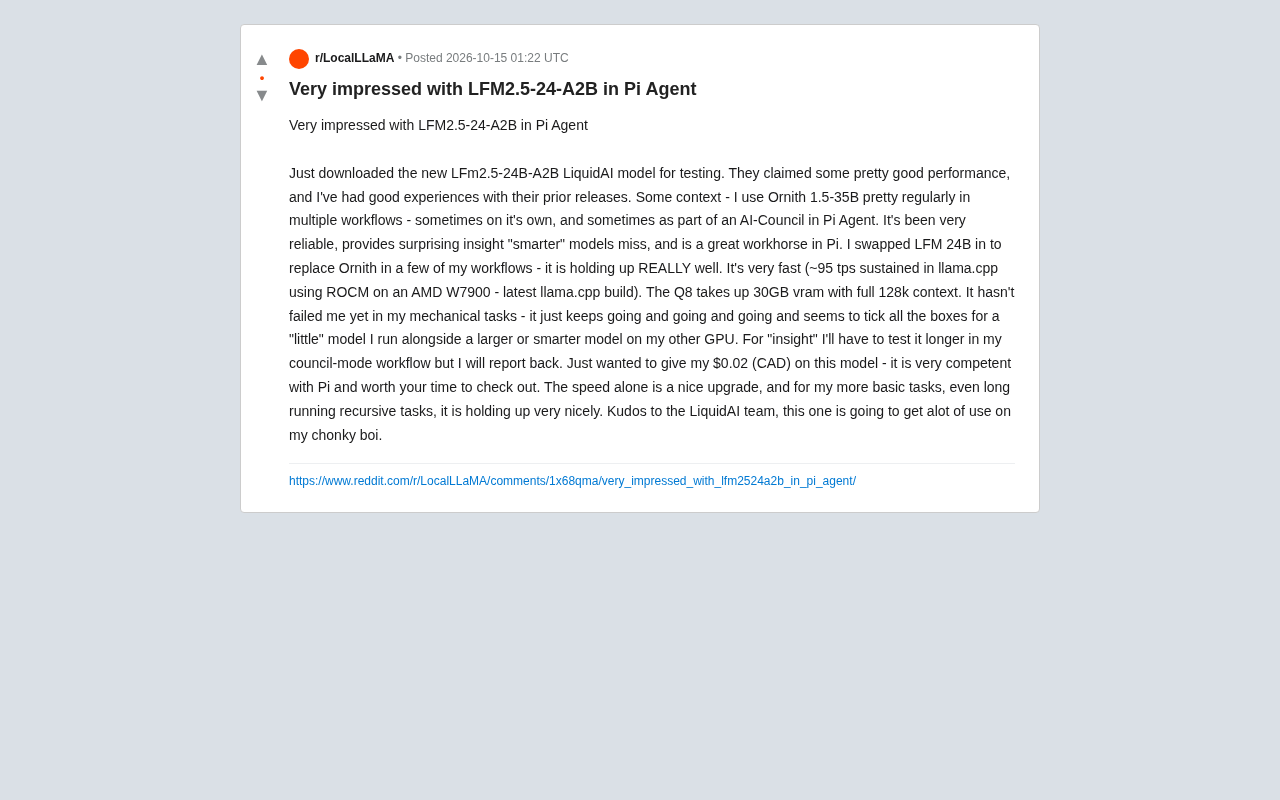
一位长期使用 Ornith 1.5-35B 的 Reddit 用户,将 LiquidAI 新发布的 LFM2.5-24B-A2B 替换进 Pi Agent 工作流进行实测。在 AMD W7900 上通过 llama.cpp+ROCm,模型实现约 95 tps 持续推理速度,Q8 量化占用 30GB 显存并支持完整 128k 上下文。在机械性任务和长时间递归任务中,该模型表现稳定可靠,被定位为与大模型并行的「小」模型,适合双卡分工协作。不过作者坦诚指出,在 AI-Council 议会模式下的洞察能力尚需更长周期验证,并承诺后续回报。整体而言,这次真实工作流对照实验为 LiquidAI 的官方性能宣称提供了初步佐证。
在本地大模型部署圈子里,一次靠谱的实测分享往往比官方基准跑分更有说服力。最近 Reddit 上一位用户的帖子引发了不小讨论:他刚刚下载了 LiquidAI 发布的新款 LFM2.5-24B-A2B 模型,并在 Pi Agent 工作流中进行了多场景替换测试,结论是「非常惊艳」。
一、为什么这次测试值得关注
这位用户并不是随手跑个 demo 就发帖的类型。从他的描述来看,他长期将 Ornith 1.5-35B 作为主力模型,用在多个工作流中——有时单独使用,有时作为 Pi Agent 中「AI 议会」(AI-Council)模式的一员。他给 Ornith 的评价是:非常可靠、能提供那些「更聪明」的大模型反而忽略的洞察,是 Pi 里的工作马。
正因为有一个稳定的对照基线,他才决定把 LFM2.5-24B-A2B 换进去,看看这个小一号的模型能不能顶住。结果用他自己的话说——「holding up REALLY well」。在机械性任务中,它从没让他失望过,「就是一直跑一直跑」,几乎满足了他对一个「小模型」的全部期待。
二、速度与显存:本地部署的关键指标
对于本地部署用户来说,模型能力之外,最关心的就是速度和显存占用。帖子中给出了相当具体的数据:
- 推理速度:在 AMD W7900 显卡上,使用 llama.cpp 配合 ROCm 后端,最新构建版本下持续约 95 tps(tokens per second)
- 显存占用:Q8 量化版本占用约 30GB VRAM,且支持完整的 128k 上下文
这两个数字放在一起看是有意义的。95 tps 的持续输出速度,对于 24B 级别的模型来说已经相当流畅,尤其是在消费级/工作站级 AMD 显卡上通过 ROCm 跑出这个成绩。而 Q8 量化下 30GB 显存换取 128k 完整上下文,意味着单卡大显存用户(如 W7900 的 48GB)可以轻松容纳,还能留出余量给其他任务。
关于 llama.cpp 与 ROCm
llama.cpp 是一个用 C/C++ 编写的开源大模型推理引擎,核心优势在于高度优化的量化支持和跨平台兼容性,支持 GGUF 格式模型,能在 CPU、CUDA、Metal、ROCm 等多种后端上运行。ROCm(Radeon Open Compute)则是 AMD 推出的开源 GPU 计算平台,对标 NVIDIA 的 CUDA。长期以来,ROCm 在消费级和工作站级 AMD 显卡上的生态成熟度不及 CUDA,但近两年迭代速度明显加快。此次评测中能在 W7900 上跑出 95 tps,说明 llama.cpp + ROCm 的组合已经具备实用级别的稳定性,这对不愿绑定 NVIDIA 生态的用户是一个积极信号。
关于 Q8 量化
量化是将模型权重从高精度浮点(如 FP16)压缩为低比特整数的技术,目的是降低显存占用和提升推理速度。Q8 表示每个权重用 8 位整数存储,属于「接近无损」的量化等级——相比 Q4 等更激进的压缩方案,Q8 的精度损失极小,但显存占用也更高。24B 模型在 Q8 下占用约 30GB VRAM,意味着至少需要 32GB 以上显存的显卡才能完整加载,W7900 的 48GB 恰好留有充裕余量。理解量化等级与显存占用、精度之间的权衡,是本地部署选型的核心功课。
三、小模型 + 大模型的双卡协作思路
这位用户的部署架构值得单独拿出来聊。他明确提到,自己把 LFM2.5-24B-A2B 定位为「跑在另一块 GPU 上、与大模型或更聪明模型并行的『小』模型」。
这是一种越来越常见的本地部署策略:用一张卡跑大模型负责复杂推理和规划,另一张卡跑小而快的模型负责机械性、重复性、长链路的执行任务。这种分工的核心逻辑是——不是所有任务都需要动用最大的模型。很多机械任务、递归式的长流程任务,用一个小而快的模型反而性价比更高,因为它不会拖慢整条流水线。
帖子作者特别强调,即使是「long running recursive tasks」(长时间运行的递归任务),LFM2.5 也表现得很稳。这一点对于 Agent 类工作流尤其重要,因为 Agent 往往需要模型反复调用工具、处理中间结果、维持长上下文,模型一旦在长链路中出错或降速,整个流程就会卡住。
关于 AI Agent 与工具调用
Agent(智能体)工作流指的是让大模型自主规划步骤、调用外部工具(如搜索引擎、代码执行器、API)、处理中间结果并循环推进直到完成目标的模式。与单轮问答不同,Agent 场景对模型的要求更偏向「长链路稳定性」:它需要在几十甚至上百次迭代中持续遵循指令格式、正确解析工具返回、维持上下文一致性。一旦某一步输出格式出错或产生幻觉,整条链路就可能中断。因此,用一个小而快的模型专门承担执行类子任务,用大模型负责顶层规划,成为降低成本和延迟的常见架构选择。Pi Agent 的「AI-Council」模式则更进一步,让多个模型并行给出判断再综合,本质上是用模型多样性换取决策质量。
四、尚待验证的部分:洞察能力
作者也很坦诚地划出了边界。他提到,在「洞察」(insight)层面——也就是 AI-Council 议会模式中,让多个模型各自给出判断再综合的那种用法——他还需要更长时间的测试才能下结论。
这个区分很关键。机械任务考验的是稳定性、速度和指令遵循;而议会模式考验的是模型的判断质量、视角独特性和「能不能说出别的模型没说到的点」。前者 LFM2.5 已经通过了初步考验,后者还需要时间。作者表示会后续回报,这种审慎的态度反而让前面的好评更可信。
这也给打算跟进的用户一个提示:如果你主要用模型做流程执行、工具调用、批量处理,LFM2.5-24B-A2B 可能立刻就能用起来;但如果你指望它在多模型协作中提供高质量洞察,最好自己再实测一轮。
什么是模型「洞察力」
在社区语境中,「洞察」(insight)通常指模型能否给出非显而易见、有独特视角的判断,而不是复述训练数据中的常见结论。它与模型规模、训练数据多样性和后训练策略都有关。小模型在机械任务上可以通过指令微调达到接近大模型的表现,但在需要跨领域联想、识别问题本质、提出反直觉方案的任务上,往往因为参数容量和知识密度的限制而逊色。这正是作者将「机械任务」与「议会模式洞察」分开评估的原因——前者考验执行力,后者考验判断力,二者对模型能力的要求维度不同。
五、对 LiquidAI 与本地模型生态的意义
帖子最后,作者用「Kudos to the LiquidAI team」收尾,并预言这个模型会在他的「chonky boi」(大块头机器)上得到大量使用。
从社区反馈的角度看,这次分享的价值在于它提供了一个真实工作流中的对照实验,而不是孤立的基准测试。LiquidAI 在发布时给出的性能宣称,在这个用户的机械任务场景中得到了初步印证,尤其是速度表现被直接称为「a nice upgrade」。对于正在寻找 24B 级别、支持长上下文、能在 AMD 平台上高效运行的开源模型的用户来说,LFM2.5-24B-A2B 值得列入候选清单。
当然,单一用户的体验不能替代系统评测。模型在议会模式下的洞察能力、在更广泛任务类型上的泛化表现,还需要更多社区实测来补充。但至少从目前这份「$0.02(加元)」的反馈来看,这是一个开了个好头的发布。
相关推荐

Workbuddy零基础入门:桌面AI智能体如何落地工作流
Workbuddy桌面AI智能体零基础教程解读:从安装、积分领取到文件管理与自动化工作流搭建,对比CodeX的适用场景与成本差异,帮助职场人完成从AI提问者到AI管理者的思维转变。

OpenAI智能体新栈:计算机操作、决策API与超速工作流
OpenAI Dev Day发布智能体新栈:Computer Use操作速度超越普通人,Decisions API基于Luna实现极低延迟分类,Agents API开放同源计算机操作能力,GPT-6.1 Sol成本仅为Astra七分之一。本文梳理核心更新、实测数据与开发者落地要点。

梁文峰开源推理框架DeepInfo,硬刚美国禁令
DeepSeek在开源模型后再开源推理框架DeepInfo,包含GPU/CPU交叉流水线、小模型预判大模型复核、华为昇腾与英伟达芯片全面适配等技术,直面美国联邦禁令。本文解析其对AI产业落地的意义与开源策略。