LFM3发布:为专用智能打通全模态能力
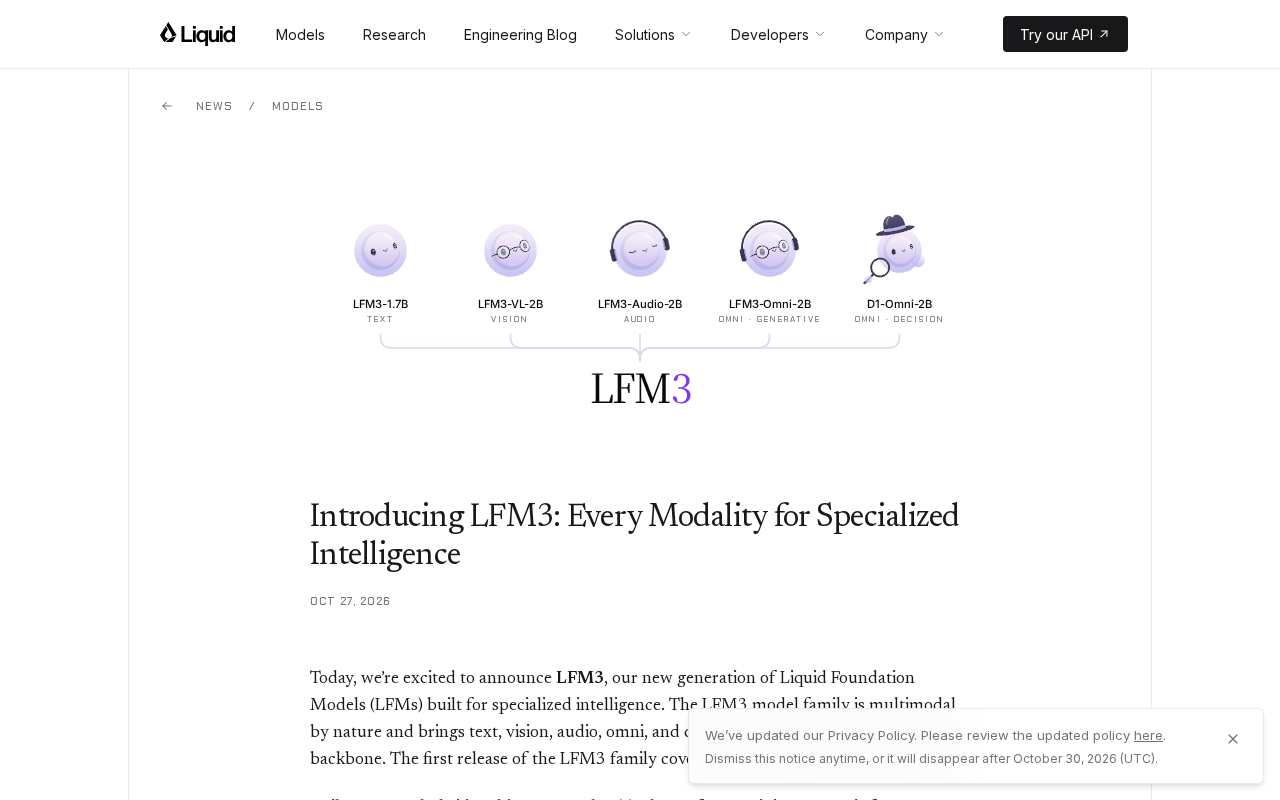
LFM3 以“全模态+专用智能”定位,试图在垂直场景中实现多模态统一处理,但技术细节和第三方评测仍待补充。
LFM3 是一款强调“专用智能”与“Every Modality”的多模态模型,主张在单一模型体系内统一处理文本、图像等多种数据类型,而非为每个模态单独建模。其定位瞄准垂直场景中多源异构数据的处理需求,试图兼顾通用多模态模型的覆盖面和文本专用模型的深度。Hacker News 早期讨论规模较小,开发者更关注开源程度、接口可用性和真实任务表现。文章指出,各模态性能是否均衡、专用化是否牺牲通用能力,是评估 LFM3 实际价值的关键待验证问题。在缺乏独立评测和可复现实验的情况下,宜将其视为值得跟踪的方向性产品。
从通用大模型到专用智能:LFM3 的定位
在多模态大模型竞争日益激烈的当下,新模型发布往往陷入“参数更大、榜单更高”的同质化叙事。LFM3 的出现提供了一个不同的切入点:它强调的不是通用能力的全面碾压,而是“专用智能”(Specialized Intelligence)——让模型在特定领域、特定任务上真正可用。
据 Hacker News 上的讨论,LFM3 以“Every Modality”为核心主张,意味着它在文本之外还覆盖了其他模态的输入与输出能力。对于需要处理多源异构数据的行业场景而言,这种“全模态 + 专用化”的组合比单纯的通用对话能力更具落地价值。
“每种模态”意味着什么
标题中的“Every Modality”是理解 LFM3 的关键。多模态能力在过去两年从“能看图”逐步演进到“能听、能看、能理解视频”,但多数模型的模态覆盖仍不完整,或在某些模态上仅是浅层支持。
LFM3 把模态覆盖作为核心卖点,暗示其设计目标是在单一模型体系内统一处理多种数据类型,而不是为每个模态单独维护一套模型。这种架构取向对于降低部署复杂度、减少多模型协同带来的延迟和误差累积有实际意义。不过,由于官方披露的技术细节有限,具体覆盖哪些模态、各模态的性能水平如何,仍有待更多实测验证。
多模态模型的基本范式
多模态模型通常指能够同时处理两种或以上数据模态(文本、图像、音频、视频等)的神经网络。主流实现方式包括:早期融合(在输入层拼接不同模态特征)、晚期融合(各模态独立编码后合并决策),以及基于注意力机制的跨模态对齐(如 CLIP 式的对比学习)。许多现有模型采用“编码器-投影器-大语言模型”三段式架构,即用独立编码器处理非文本模态,再投影到语言模型的表示空间。LFM3 宣称在单一模型体系内统一处理多模态,意味着它可能减少了对外部模态专用组件的依赖,从而降低部署复杂度和跨模态误差累积。不过,统一架构也面临模态间表示对齐和训练数据平衡的挑战,实际效果需看官方技术报告和第三方评测。
专用智能为什么值得关注
通用模型在开放域对话上表现出色,但一到垂直场景就容易暴露短板:术语理解不准、领域推理链条断裂、输出格式不符合行业规范。专用智能的思路是把模型能力收敛到明确的任务边界内,用更聚焦的训练数据和评测体系换取可靠性。
LFM3 将“专用”与“全模态”并列,实际上是在回答一个问题:垂直场景的数据往往不是纯文本的——医疗影像、工业传感器读数、金融报表图表都要求模型具备跨模态理解能力。只做文本专用模型,覆盖面不够;只做通用多模态模型,深度不够。LFM3 试图同时占住这两端。
垂直领域模型的常见做法与挑战
专用智能(Specialized Intelligence)在工程上通常通过领域微调、检索增强生成(RAG)或构建领域知识图谱来实现。领域微调使用高质量、任务聚焦的数据对基座模型进行继续预训练或指令微调,使模型输出更符合行业术语和格式规范。RAG 则通过外挂知识库减少幻觉,并保持知识更新。这些方法能提升垂直场景的可靠性,但也可能带来灾难性遗忘——模型在专用数据上过拟合后,通用能力下降。LFM3 将“专用”与“全模态”并列,需要解决多模态领域数据稀缺和标注成本高的问题。评估专用模型时,除了领域准确率,还应关注其泛化边界和拒绝回答不合理请求的能力,这些指标比通用榜单更能反映落地价值。
Hacker News 讨论透露的信号
该帖在 Hacker News 上获得 17 个点和 6 条评论,讨论规模不大,属于典型的新模型发布初期关注度。从社区反应来看,开发者更关心的不是宣传口径,而是实际可用的接口、开源程度以及在真实任务上的表现。
这类早期讨论的价值在于,它反映了技术社区对“又一个多模态模型”的审慎态度:在缺乏独立评测和可复现实验的情况下,发布方的自我描述只能作为参考。对 LFM3 而言,能否在后续获得第三方基准测试和真实场景案例的支撑,将决定它的口碑走向。
落地场景与待解问题
从“专用智能 + 全模态”的定位推断,LFM3 的潜在应用方向包括需要同时处理文档、图像和结构化数据的行业工作流,例如内容审核、工业质检报告生成、多模态检索等。但这些都是基于定位的合理推测,原始信息并未给出具体案例。
真正需要观察的问题有几个:各模态的性能是否均衡,还是某一模态明显偏弱;专用化是否以牺牲通用能力为代价;以及模型对开发者是否友好,包括调用成本、部署方式和生态工具链。这些问题的答案,比发布时的宣传语更能决定 LFM3 的实际价值。
在官方补充更多技术细节和第三方评测出现之前,把 LFM3 视为一个值得跟踪的方向性产品,比急于下结论更为稳妥。
相关推荐
Ollama本地部署指南:零基础跑通开源大模型
Ollama本地部署教程:介绍Ollama是什么、为什么选择它,以及如何下载安装、运行开源大模型,并利用API进行个性化开发,适合零基础用户。
n8n:GitHub 187K星的开源自动化神器,把重复工作变工作流
n8n 是一款 GitHub 187K 星的开源可视化工作流自动化引擎,支持 400+ 节点、Webhook/定时/轮询触发,可自托管保障数据安全,还能接入 AI Agent 打造 AI 工作流。本文介绍其核心概念、典型场景与避坑指南。
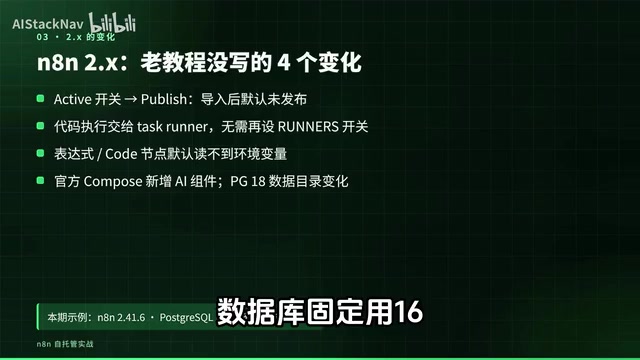
n8n自托管实战:Docker+PostgreSQL+Caddy部署指南
手把手教你用 Docker Compose 部署 n8n 自托管实例,搭配 PostgreSQL 和 Caddy 自动 HTTPS,含环境变量避坑、网站巡检飞书告警流程、备份升级回滚要点。