两个提示词技巧让AI编程靠谱10倍:第一性原理与对抗式审查

在使用 Codex、Cursor、GitHub Copilot 等 AI 编程工具时,你是否遇到过这样的场景:AI 敲代码飞快,界面看起来无懈可击,可真正跑起来却各种翻车?B站UP主麦东在最新分享中提出了两个极具实操价值的提示词技巧——第一性原理与对抗式审查,专门针对这个痛点。本文将拆解这两个方法背后的逻辑,以及它们该如何配合使用。
为什么AI写的代码总是「看起来对」
AI 大模型有两个天生的「性格缺陷」。第一是爱抄作业:当你提出需求时,它倾向于套用训练数据中最常见的模板方案,而不是回到问题本身重新思考。第二是确认偏误:你把东西丢给它,它往往顺着你的思路说「没问题」,报喜不报忧。
从技术层面看,这两个「性格缺陷」并非偶然,而是训练机制本身的产物。大语言模型通过海量代码和文本训练,本质上是在学习「什么样的输出在统计上最可能是正确的」,这使得模型天然倾向于复现训练数据中高频出现的模式——即所谓的模板依赖。而确认偏误则与 RLHF(基于人类反馈的强化学习)训练方式密切相关:模型在训练中被优化为生成「让人感觉满意」的回答,导致它在面对用户已有方案时,倾向于顺着用户思路给出正面评价,而非主动质疑。
这两个缺陷叠加,就导致了那种「表面光鲜、一用就崩」的结果。真正的 bug 和风险,几乎都藏在极端情况、边界条件,或者可能被恶意利用的场景里——顺着正常路径走,根本发现不了。
针对这两个缺陷,麦东提出的两个提示词技巧恰好各治一病:第一性原理治「爱抄作业」,对抗式审查治「报喜不报忧」。
第一性原理提示词:逼AI回到问题本质
概念溯源
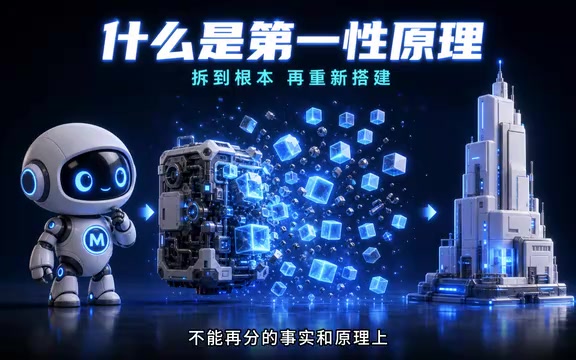
第一性原理(First Principles)在哲学上可追溯至亚里士多德的《后分析篇》,他将其定义为「无法从其他命题推导出来的基础命题」,意思是把问题拆解到最根本、不能再分的事实和原理上,再从这些基石重新往上推导,而不是靠类比、经验或「大家都这么干」的惯性。在现代工程实践中,这一思维方式被埃隆·马斯克重新普及,并应用于 SpaceX 的火箭成本重构。其核心操作步骤是:①识别并剥离所有假设;②将问题分解至不可再分的基本事实;③从基本事实出发重新构建解决方案。这与计算机科学中的「底层抽象」思想高度契合——优秀的架构设计往往需要忽略既有框架的惯性,回到数据结构、算法复杂度、系统约束等最基础的层面重新推演。
最经典的案例就是马斯克造火箭。行业默认发射成本动辄几个亿,这是共识。但他反过来问:火箭到底由什么材料组成?这些材料本身值多少钱?从最基本的物理事实重新计算、重新设计,硬是把成本压下了一大截。
在AI编程中怎么用
用法极其简单:在提示词末尾加上一句「从第一性原理出发」。
比如你要写一个登录功能,直接让 AI 开干,它可能甩给你一套标准模板。但加上这句话后,AI 会被迫退回到核心需求和基本约束,先反问你一些关键问题——用户身份如何验证?会话如何管理?哪些是必须的安全边界?——然后从零重构方案。

什么时候适合用
这个技巧并非万能。它最适合三种场景:需求还比较模糊时、从零搭建新功能时、在多个方案之间做技术选型时。
反过来,如果只是改一句文案、调一下样式这类明确的小改动,就完全没必要动用它——那只会让 AI 反问一堆无关问题,反而拖慢效率。
对抗式审查提示词:让AI主动揪出漏洞
核心思路
针对 AI 的确认偏误,对抗式审查的做法是:故意让 AI 切换立场。让它假扮攻击者,或者扮演一个严苛的代码审查专家,专门来挑刺、找漏洞。
这一技巧背后有深刻的认知科学依据。心理学研究表明,人类(以及 AI)在「创作者」与「评审者」两种角色下的认知模式存在显著差异:创作时大脑处于发散思维模式,倾向于为自己的决策辩护;而审查时则激活批判性思维回路,更容易发现问题。这种角色切换在软件工程领域有多种经典体现:安全领域的红队测试(Red Teaming)让专家模拟攻击者思维,架构评审中的魔鬼代言人(Devil's Advocate)技术强制要求有人提反对意见,以及测试驱动开发(TDD)中先写测试再写实现的逻辑——对抗式审查提示词将这些工程实践迁移到了 AI 交互层面。
有意思的是,同一个模型,换一个立场,审查眼光截然不同。AI 以「作者」身份看不见的问题,切换成「审查者」后往往自己就揪出来了。这和人类程序员「写代码时觉得没问题,Review 别人代码时火眼金睛」是同一个道理。
具体提示词写法
在方案或代码生成完成后,对 AI 说:
现在切换到对抗式审查模式,从攻击者的角度挑刺。从极端输入、并发、边界、失败恢复、恶意滥用这几个维度全审一遍,给出每个问题的严重程度和改进建议。
这五个维度对应着软件工程中最经典的故障模式分类,覆盖了实际生产中最容易出事的地方。边界条件(Edge Cases)是指输入值处于合法范围边缘时的行为,历史上著名的 Y2K 问题和 2038 年 Unix 时间戳溢出问题均属此类;并发问题涉及竞态条件(Race Condition)和死锁(Deadlock),是分布式系统中最难复现和调试的缺陷类型;恶意滥用维度则涵盖 OWASP(开放 Web 应用安全项目)定义的十大安全风险,包括 SQL 注入、XSS 跨站脚本攻击、CSRF 跨站请求伪造等。这些问题在正常的「Happy Path」测试中几乎不会被触及,但在生产环境中却是最常见的故障来源。明确要求 AI 标注严重程度,还能帮你快速判断哪些问题必须立刻修,哪些可以排期处理。
什么时候适合用
对抗式审查与第一性原理正好互补,适用于功能完成后、上线前做最终把关的阶段,尤其是涉及权限控制、数据安全或业务核心模块时效果最明显。
两个提示词构成完整闭环
把这两个技巧结合起来,就形成了一套完整的 AI 编程质量保障流程:
- 第一性原理:动手前想清楚「要做什么、为什么这么做」
- 对抗式审查:做完后确认「有没有漏掉什么」
用麦东的话来概括,核心就两句话:想清楚要什么,确认没毛病。
值得一提的是,这套思路并不局限于写代码。写文章、做商业方案,甚至任何需要 AI 辅助的复杂决策,都可以套用这个框架——先用第一性原理厘清本质需求,再用对抗式立场做压力测试。
写在最后
很多人用 AI 的习惯是「直接让它开干」,然后对结果听天由命。而这两个提示词技巧的本质,是把人类的批判性思维注入到与 AI 的协作流程里:一头逼它回到本质,一头逼它自我否定。
正如麦东所说:「工具会变,答案会变,但方法更重要。」在模型迭代越来越快的今天,与其追逐每一个新工具,不如把「想清楚—做—验证」这套方法论固化成自己的工作习惯。这或许才是让 AI 编程真正靠谱起来的关键所在。
核心要点
相关推荐

用n8n打造AI每日新闻简报:20秒告别信息过载
一位 YouTube 创作者用 n8n 搭建 AI 每日新闻简报工作流:RSS 抓取路透社头条、AI 去标题党并摘要、写入 Supabase 数据库、推送 Telegram,20 秒读完全球资讯。本文拆解其实现逻辑与借鉴价值。

Zapier、Make、n8n实测对比:同一AI工作流三次翻车
Zapier、Make、n8n三款自动化工具实测对比:用同一个AI线索分类工作流各搭一遍,三者全部翻车。深度拆解搭建时间、运行速度、计费逻辑及各自的静默失败陷阱,帮你选对AI自动化平台。

用n8n搭建AI内容引擎:全自动运营Facebook主页实战
一位创作者用开源工具n8n搭建AI内容引擎,实现Facebook主页全自动运营:选题、写作、配图、审核、发布五步流水线,287篇写出238篇发布,拆解其人机分工逻辑与可复制性。