两天移植,预填充提速8倍:Strata引擎实测

单开发者两周做出的Strata引擎,靠专属内存调度将MoE预填充提速至llama.cpp的8倍。
文章介绍了一个仅有两周历史、由一位开发者主导的开源推理引擎Strata。它在单张消费级显卡上运行125B参数的Qwen 3.8 Flash模型,预填充速度约900 tokens/秒,是llama.cpp的8倍。核心原因在于Strata只支持单一模型架构,从而能极致优化数据搬运:加大预填充批次、预流式加载专家、为稀疏注意力写专用kernel。文章指出Agent场景下预填充而非解码才是主要等待来源,并记录了作者两天移植思路使llama.cpp分支预填充从120提升到620 tokens/秒的实验。同时提醒Strata不支持并发、锁定大量内存、输出非逐字节可复现等限制。
一个开发者、两周时间,做出比llama.cpp快8倍的推理引擎
据B站UP主搬运的海外实测视频,一个名为Strata的推理引擎在单张消费级显卡上,将125B参数的Qwen 3.8 Flash模型运行到预填充约900 tokens/秒、解码约40 tokens/秒的水平。同一张卡上用llama.cpp,预填充只有约120 tokens/秒。差距接近8倍。
视频作者直言,这个引擎只有两周历史,MIT协议,大部分代码由一位开发者完成,仓库已积累约9000 stars。它的核心赌注与llama.cpp完全相反:llama.cpp支持约150种模型架构,Strata只支持一个。
这种“只服务一个模型”的极端取舍,换来了什么?答案藏在多数人忽略的指标里。
为什么预填充比解码更重要
大多数人评判推理引擎时看解码速度——模型写答案有多快。但视频里一个真实的Instamart下单案例揭示了另一面:Agent执行一次完整下单,往返模型26次,累计输入约34000个prompt token,输出仅约1700个token。每写1个token,要读20个token。模型62%的忙碌时间花在预填充上。
这意味着,如果你的场景是Agent、RAG或长上下文工具调用,预填充才是真正的等待来源。视频作者的实测很直观:同样34000个token,llama.cpp以120 tokens/秒预填充需要将近5分钟,Strata完成同样的工作在73秒内。一边还在读,另一边已经下完单了。
这个判断不依赖具体引擎,适用于任何本地部署选型:挑模型或引擎跑Agent,先看预填充,再看解码。
预填充(prefill)与解码(decode)是LLM推理的两个阶段。 预填充阶段处理完整输入prompt,所有token并行计算,GPU利用率高,属于计算密集型;解码阶段逐token自回归生成,每步只处理一个新token,反复读取模型权重和KV cache,属于内存带宽密集型。由于解码无法并行化,通常以每秒生成token数衡量,而预填充以每秒处理token数衡量。Agent、RAG等场景输入远长于输出,因此预填充总耗时往往超过解码。
KV cache是解码阶段的核心内存开销。 模型为每个已处理token的每层保存Key和Value向量,避免重复计算。长上下文下KV cache可占数GB显存,稀疏注意力通过只保留或只读取部分KV行来降低带宽压力——这正是文中Qwen模型索引器筛选约2000个位置的意义。
Strata快在哪:不是魔法,是物流
有趣的是,Strata在专家矩阵乘法——整个模型最重的计算——上直接沿用了llama.cpp的MMQ kernel。真正的差距来自数据搬运的组织方式。
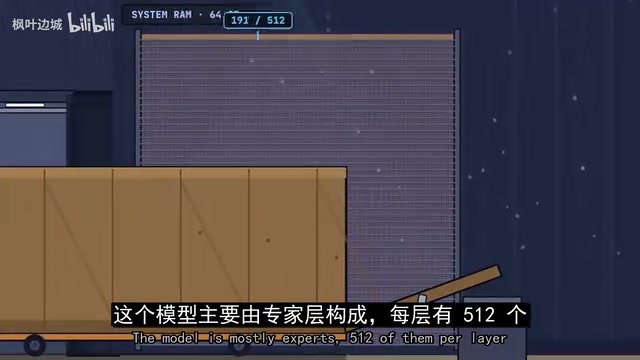
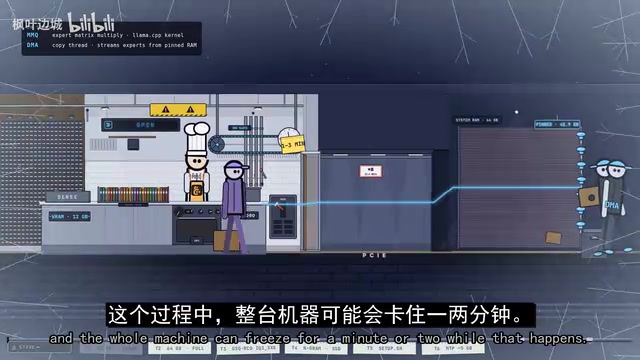
视频用厨房做比喻:12GB显存是操作台,系统内存是储藏室,PCIe是走廊。125B MoE模型装不进12GB显卡,大部分专家必须待在内存里。瓶颈不在厨师手艺,在于食材穿越走廊的次数。
Strata的做法是加大每次搬运的批量。llama.cpp默认按512 token的批次处理prompt,每批都要把非驻留专家从内存搬一次;Strata在预填充时借用几乎全部显存缓存,按6144 token切块,专家穿越PCIe的频率从每500 token一次降到每6000 token一次。它还用一个独立线程提前把下一层的专家DMA到GPU环形缓冲区,让第N+1层在加载时第N层仍在计算,GPU不再空等拷贝。
注意力部分是另一处差异。该模型使用稀疏注意力,索引器为每个query挑选约2000个位置。原版llama.cpp仍构建完整掩码并跑稠密flash attention,Strata则用自己的kernel只读取选中的KV cache行。
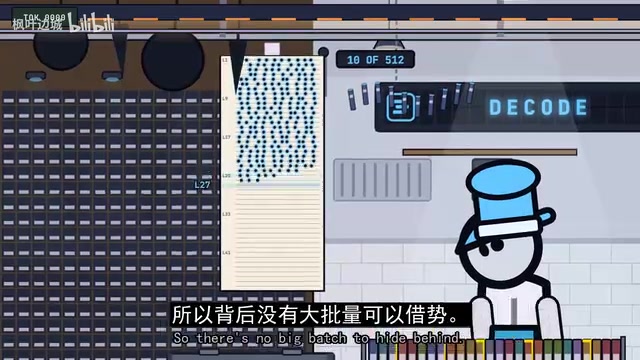
解码阶段的问题不同:没有大batch可藏,每个token都是全新旅程。Strata把每层拆成三路并行——GPU处理缓存命中、约四分之一的未命中经PCIe拉取、其余由CPU直接从锁定内存计算,三者同步进行。再加上模型自带的MTP多token预测头,每步草拟最多三个token,整模型一次验证,输出结果与不使用推测时一致。作者调优过的llama.cpp构建在此卡上解码约26 tokens/秒,Strata约40。
MMQ(Mixed-precision Matrix Multiplication)kernel是llama.cpp的量化矩阵乘核心。 它支持在推理时对权重进行低精度(如4-bit、5-bit)分块量化,并在矩阵乘过程中动态反量化,从而在消费级GPU上运行超出显存容量的大模型。Strata直接复用这一kernel处理专家矩阵乘,说明其性能优势并非来自计算指令优化,而是来自数据调度。
MoE(混合专家)架构是125B参数模型能跑在单卡上的关键。 每层包含多个专家网络(如图中512个),每个token只激活其中少数几个(如10个),因此实际计算量远小于总参数量。但全部专家权重仍须存储,放不进显存的部分留在系统内存,按需经PCIe搬运。预填充批次越大,每个专家被复用的token越多,分摊到每token的搬运成本越低——这正是Strata加大批次的逻辑基础。
移植实验:两天,预填充从120到620
视频作者做了一件更有意思的事:读完Strata代码后,花两天把预填充思路移植进自己的llama.cpp分支——借用专家缓存做大块处理、在第二个CUDA流上预流式加载专家、为稀疏注意力加专用kernel。在一个17000 token的prompt上,他的分支从约120 tokens/秒提升到约620,而Strata同测试约900。
他没跑赢Strata,但得出了一个更重要的结论:为一个模型写极致kernel,远比造一个通用工具容易。而且Strata约三分之二的commit有AI编程Agent联合署名。这意味着为新模型写专属kernel的速度正在变得极快。
他的判断是未来会并存两类引擎:一种是单架构跑得极致快,另一种是通用引擎牺牲部分速度覆盖多数模型。随着时间推移,专用kernel会被逐步吸收进通用引擎,然后新模型出现,循环再来一次。
CUDA流(stream)是GPU上的异步执行队列。 默认情况下所有操作在同一个流中顺序执行;创建第二个流可以让数据拷贝与计算重叠。文中“在第二个CUDA流上预流式加载专家”即利用这一机制:当主流正在计算第N层时,第二流通过DMA把第N+1层所需专家从主机内存传入GPU缓冲区,从而隐藏PCIe延迟。这一技术与Strata的环形缓冲区思路一致,是移植实验取得5倍提升的关键手段之一。
AI编程Agent联合署名commit指由Claude Code、Cursor等工具生成或辅助生成的代码提交。Strata约三分之二的commit带有此类署名,说明为单一模型编写专用kernel的边际成本正在快速下降——这改变了通用引擎与专用引擎之间的竞争节奏。
部署方式与三个必须知道的坑
Strata提供OpenAI兼容服务器,但只服务这一个模型。其他模型继续留在llama.cpp的router里作为preset。作者用LamaSwap作为前置代理,按模型名启动对应后端。请求35B时拉起router,请求Qwen Flash时停掉router启动Strata,单卡切换约34秒,返回约15秒。闲置10分钟后Strata自动关闭并释放锁定的内存。
第一个坑很明显:Strata一次只服务一个请求,没有批处理。要多人并发或并行跑多个Agent,它不是合适选择。
第二个坑是内存锁定。作者的IQ3量化版本锁定约40GB固定内存,Strata运行期间机器上其他程序无法使用这部分内存。Windows下多GPU锁定有上限,WSL下能锁的量更少,Linux才是它真正适合的地方。
第三个坑关于输出一致性。同一专家由GPU还是CPU计算会产生微小数值差异,而缓存不断在两者之间搬移专家,所以即便贪心解码,默认也不是逐字节可复现的。可以用几个开关强制一致,但会损失速度。作者对此的评价是噪音级别——Strata论文测得它与llama.cpp的输出分布差异,比llama.cpp自身在CPU和GPU之间的差异还小。
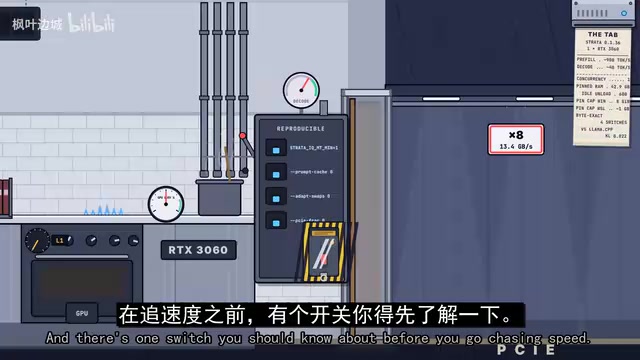
还有一个设置项值得单独提醒:experimental speed projection,默认关闭,名字听起来像加速功能,实际上是一个拒绝移除控制向量。打开后约每10个位置有1个top token发生变化,代码困惑度上升15%。保持关闭。
MTP(Multi-Token Prediction)多token预测头是模型训练时附加的轻量模块,让模型一次草拟多个候选token,再由完整模型并行验证,接受与贪心解码一致的结果。这属于推测解码(speculative decoding)的一种,能在不改变输出分布的前提下提升解码吞吐。Strata利用模型自带的MTP头每步草拟最多三个token,是其解码速度从约26提升到约40 tokens/秒的原因之一。
拒绝移除控制向量是某些模型在训练中植入的方向向量,用于在推理时抑制特定输出。experimental speed projection开关名为加速,实为关闭该控制向量的移除,导致输出分布偏移、困惑度上升。困惑度(perplexity)衡量模型对文本的预测不确定性,上升15%意味着生成质量实质下降。
它能不能替代你的日常主力模型
视频作者的个人答案是:已经替代了。他原本用35B MoE做日常主力,原因是快而非聪明。Qwen 3.8 Flash在他眼中是另一个量级,接近前沿水平。而Strata让Agent真正等待的预填充环节变快了,那笔Instamart订单在两分钟内跑完,只用一张卡。
他的建议按内存分档:有64GB内存,全量模型放得下,可以直接换;只有32GB,可以试专家裁剪后的Coder版本,适合以写代码为主的Agent;而LamaSwap在前,你不需要二选一,35B可以继续留着。
需要泼的冷水也很清楚:项目只有两周,大部分已公布数据来自一台机器,文档自己也承认这点并标注了估算口径。版本之间出现问题是预期之内的事。
相关推荐

Hermes Agent零基础实战:自进化AI助手
Hermes Agent 零基础教程:GitHub 41.7K 星的自进化 AI Agent 怎么装怎么用。本文拆解其学习循环、三层记忆与 Skill 自改进机制,对比 Claude Code 和 OpenClaw 的差异,并附 WSL 安装实操步骤。

RAG面试核心:离线建库与在线检索全流程拆解
拆解RAG检索增强生成的完整工作流程:离线阶段文档加载、切割、向量化、入库,在线阶段问题改写、向量检索、重排、生成,并解析RAG面试核心考点与系统优化方向。

AI大模型零基础入门:原理与API调用实战指南
从AI发展脉络到大模型训练原理,再到Token、Temperature、Top-P等核心概念,本文结合实战课程讲解系统提示词、Function Call、RAG与记忆能力的实现逻辑,并给出四类API调用场景的落地路径,适合零基础开发者入门。