两条提示词规则,让轻量模型在Oracle文本转SQL任务上从35%飙到64%

两条 Oracle 方言规则让轻量模型首次准确率从 35% 升至 64.5%,超越最佳公开成绩。
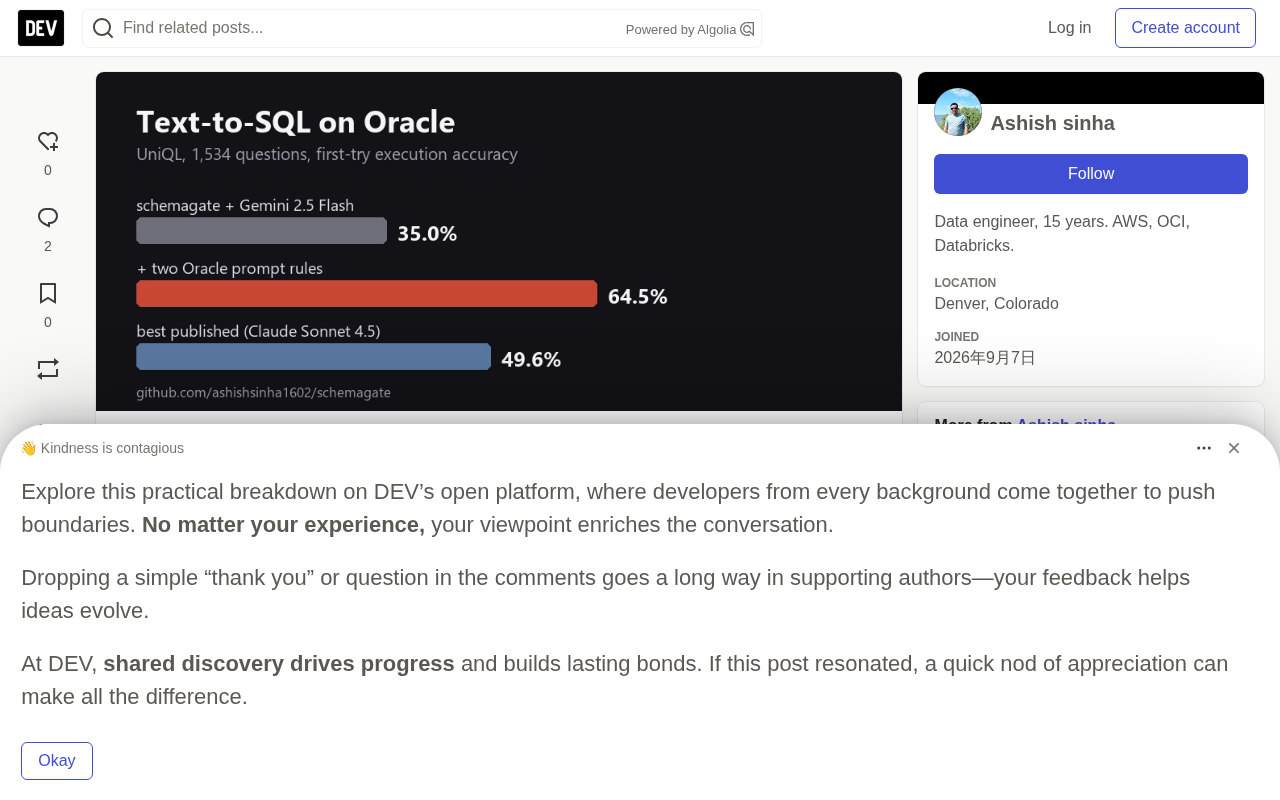
文章讲述了一个 Text-to-SQL 在 Oracle 方言上的优化案例。开发者使用轻量模型 Gemini 2.5 Flash 搭配 schemagate 工具,在 UniQL 基准的 Oracle 测试中首次尝试准确率仅 35.0%。通过分析 694 个失败查询,发现 551 个因表别名前误用 AS、100 个因未引用 DATE/NUMBER 等保留字列名,两条 Oracle 专属规则解决了 94% 的失败。在提示词中加入这两条规则后,首次准确率跃升至 64.5%,超过已发表的最佳成绩 49.61%。文章强调评测口径需对齐、失败分析比盲目调参更有价值,并指出轻量模型加领域规则是可行路径。
引言:一场被低估的基准测试
文本转SQL(Text-to-SQL)一直是大模型落地企业场景的热门方向,但不同数据库方言之间的差异往往被忽视。最近,一个名为UniQL的新基准测试把BIRD数据集中的1,534个问题翻译成了16种SQL方言,其中Oracle列的成绩格外惨淡:已发表的最佳结果仅为49.61%(Claude Sonnet 4.5),而Gemini 2.5 Pro只有26.14%。
一位开发者用轻量模型Gemini 2.5 Flash搭配开源工具schemagate进行了尝试,结果却出人意料——仅仅在提示词中加入两条Oracle专属规则,首次尝试的准确率就从35.0%跃升至64.5%,比最佳公开成绩高出近15个百分点。这背后的故事值得每一个做AI应用落地的团队细读。
Text-to-SQL 与 BIRD 数据集:Text-to-SQL 任务要求模型将自然语言问题转化为可执行的 SQL 查询。BIRD(BIg Bench for LaRge-scale Database Grounded Text-to-SQL Evaluation)是目前最具挑战性的跨域 Text-to-SQL 基准之一,包含大量真实数据库与专业领域问题,强调模型对数据库值、外部知识和 SQL 方言的理解。UniQL 选择 BIRD 作为源数据集,是因为其问题多样且贴近企业场景,翻译成多种方言后能公平比较模型在不同数据库上的泛化能力。
SQL 方言差异:虽然 SQL 有 ANSI 标准,但 Oracle、MySQL、PostgreSQL 等主流数据库在标识符引用、保留字、分页语法、日期函数等方面存在显著差异。例如 Oracle 禁止在表别名前使用 AS 关键字,且对 DATE、NUMBER 等词作为列名有严格限制。这些细节对模型来说是“长尾知识”,却直接决定生成的 SQL 能否执行,因此方言适配成为 Text-to-SQL 落地的关键瓶颈。
第一次跑分:69.9%的假象
开发者最初在Oracle Free 23ai上使用UniQL自带的评估器进行测试。schemagate + Gemini 2.5 Flash的组合在首次尝试时仅得到35.0%的准确率,但加上“错误修复”循环后,分数飙升至69.9%。这个数字看起来很美,却隐藏着一个统计陷阱。
所谓错误修复,就是让模型先运行生成的SQL,如果Oracle报错,就把错误信息反馈给模型让它重试。这个循环确实能提升最终可用性,但它与UniQL排行榜上其他模型“单次尝试”的评分标准并不一致。开发者坦承:“69.9%主要归功于修复循环,而非模型本身的能力。”单看首次尝试,Flash的35%甚至低于裸模型的基线水平。
这种“不公平比较”在AI评测中并不少见。很多团队喜欢展示经过多次重试后的最佳结果,却忽略了与同行对齐口径的重要性。正如原文所说:“衡量之后再调优,并且报告与他人可比的那个数字。”
错误修复循环(Error Repair Loop):这是一种常见的工程技巧:模型生成 SQL 后先在目标数据库上执行,若报错则将错误信息作为反馈重新提示模型生成修正版本,可迭代多次。它能显著提升最终可用率,但改变了评测条件——排行榜通常以“单次尝试”(pass@1)为标准,而修复循环相当于多次采样或自我修正。若将修复后的结果与单次尝试混报,会高估模型能力并误导技术选型。因此,严谨的做法是明确区分“首次尝试准确率”和“修复后准确率”,并在与公开榜单比较时只使用前者。
两条规则解决九成失败
真正的突破来自对失败案例的归因分析。在694个首次尝试失败的查询中,有两个错误模式几乎覆盖了全部:
- 551个查询写成了
FROM account AS a——Oracle不允许在表别名前使用AS关键字。 - 100个查询使用了名为
DATE或NUMBER的列但未加引号——这两个词在Oracle中是保留字。
这两个问题与模型推理能力无关,纯粹是方言语法细节。schemagate的解决方案很直接:当目标数据库是Oracle时,在提示词中明确告知模型这两条规则。其他数据库的提示词保持不变,避免了不必要的干扰。
效果立竿见影:首次尝试准确率从35.0%提升到64.5%,失败查询从694个骤降到85个。一个轻量级模型就这样超过了重量级对手的公开成绩。这提醒我们,在垂直领域的AI应用中,领域知识的显式注入往往比模型规模更重要。
保留字与标识符引用:在 Oracle 中,DATE、NUMBER、LEVEL、SIZE 等词是保留字或关键字,若直接用作列名或表名而不加双引号,解析器会将其视为语法元素并报错。标准 SQL 允许用双引号包裹标识符以区分关键字,但模型往往忽略这一点。类似地,表别名前加 AS 在多数数据库(如 PostgreSQL、MySQL)中合法,Oracle 却明确禁止。这些规则属于数据库方言的“硬约束”,与语义推理无关,却能在失败案例中占据极高比例。显式在提示词中注入此类规则,相当于为模型提供一份轻量级的方言约束清单,成本低且见效快。
对AI应用开发的启示
这个故事给Text-to-SQL乃至更广泛的AI应用落地带来几点实用经验。
评测口径必须对齐
错误修复循环是工程上的合理设计,但不能混入单次尝试的评测列。开发者主动将修复后的67.6%与首次尝试的64.5%分开报告,并提交到UniQL排行榜(issue #2),这种严谨态度值得学习。
失败分析比盲目调参更有价值
与其反复调整温度、top-p等参数,不如先看看模型到底错在哪里。694个失败案例中,651个(94%)源于两条语法规则,这种集中度说明:针对性的提示词工程可以带来数量级的改进。
轻量模型+领域规则是可行路径
Gemini 2.5 Flash在成本上远低于Sonnet 4.5,但通过注入Oracle方言规则,它在特定任务上实现了反超。对于预算有限的企业应用,这提供了一条务实的技术路线。
局限与展望
提一嘴,这项测试仅针对Oracle方言,两条规则也是人工分析失败案例后提炼的。对于MySQL、PostgreSQL等其他方言,是否也存在类似的“高频错误模式”,需要各自做归因分析。此外,64.5%的首次准确率距离生产可用仍有距离,错误修复循环在实际部署中依然不可或缺。
完整的预测结果、评估器输出和可复现的工作流已在schemagate仓库公开,感兴趣的读者可以自行验证。
相关推荐

M&M's斥资数百万换掉人工蓝色素,为什么这么难?
玛氏公司投入数百万美元,试图用螺旋藻天然色素替代M&M豆中的人工蓝色素,却因物料浓稠堵塞管道、残留物引发霉菌风险而被迫改造整条产线。本文解析这场配方迁移背后的工程难题、消费者与监管推力,以及"无人工色素不等于健康"的清醒判断。

Meta全球AI开发者黑客松组队需求:计算机视觉与医疗AI方向
Reddit开发者发帖为Meta Global AI Developer Hackathon招募队友,方向聚焦计算机视觉与医疗AI。本文分析这一组队信号背后的赛道逻辑、技能互补需求与黑客松选题策略。

Claude 多个模型报错:Fable 5.1、Sonnet 5.5、Haiku 5.5 故障复盘
Claude Fable 5.1、Sonnet 5.5、Haiku 5.5 及 Opus 5.5 fast mode 出现错误率升高,官方 17 分钟内完成定位与恢复。本文梳理故障时间线、多模型连带故障的技术原因,以及对开发者重试与降级策略的实际启示。