聊天机器人、工作流与AI Agent:三层能力一次讲清
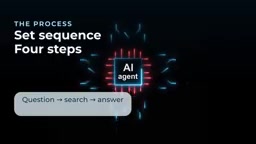
AI 能力分三层:聊天机器人、工作流与 Agent,分水岭在于决策由谁做出。
文章将 AI 能力拆解为三个递进层次:聊天机器人由大语言模型驱动,被动应答,既不自动拥有个人数据也无法真正执行任务;AI 工作流由人预先设计步骤并串联多个工具,实现自动化,但每次执行的都是同一套固定指令,遇到流程外的问题就会卡住;AI Agent 只接收目标,自行决定搜索来源、调用工具、评估产出并反复修正,核心是推理、行动、观察、调整的循环。三者并非互斥而是包含关系,真正的区别在于决策权归属。自动化减少人力投入,agentic AI 则增加了对“工作该如何完成”的判断能力,重要操作仍需人工审批。
很多人每天都在用 ChatGPT 写邮件、用 Claude 整理内容,但绝大多数人只用了 AI 能力的冰山一角。真正值得关注的,是 AI 从"等你下指令"到"自己想办法完成任务"的跃迁——这正是 AI Agent(智能体)的核心。YouTube 频道 Web Oracle 用生活化案例把 AI 能力拆成三层,本文在此基础上做进一步解读。
第一层:AI 聊天机器人——你问,它答
ChatGPT、Claude、Gemini 这类工具由大语言模型(LLM)驱动,本质工作是理解指令并生成回应。你让它写一封请求会议的商务邮件,它就能生成;但如果你问"我下一个会议是什么时候",它很可能答不上来。
原因有两个:模型并不自动拥有你的个人数据或实时信息;普通聊天机器人默认处于"被动等待"状态。它能给建议、写内容、帮你想方案,但"知道该怎么做"和"真的去做"之间隔着一道鸿沟。这也解释了为什么单纯堆提示词无法解决所有问题——缺的不是表达能力,而是执行通道。
所谓大语言模型(LLM),是指在海量文本上训练、通过预测下一个词来生成连贯文字的神经网络,GPT、Claude、Gemini 都属于这一类。它本身是一个无状态的推理引擎:每次对话只根据当前上下文(包括提示词和历史消息)生成回应,并不会记住你的日历、邮箱或实时数据——除非这些信息被显式放进上下文。正因如此,聊天机器人的能力上限很大程度上取决于你喂给它的信息,以及它能否调用外部工具。
第二层:AI 工作流——按预设流程自动执行
要回答"下个会议是什么时候",可以搭一个流程:接收问题 → 查询日历 → 提取事件 → 由 AI 组织语言回复。这就是 AI 工作流:由人预先设计好步骤,再把多个工具串起来。
工作流的局限同样明显。如果你接着问"我到的时候天气怎么样",只设计了日历查询的系统就会卡住——因为流程里没有天气这一步。你可以继续加步骤、接天气服务、生成语音、推送到手机,甚至让它每天早晨自动运行。但自动不等于智能:工作流每次执行的都是同一套预设指令,像流水线一样,每个环节各司其职、顺序固定。
这里常被提及的概念是 RAG(检索增强生成)。据 Web Oracle 的解释,它的本质是在模型生成答案前,先给它喂入相关材料——可能是文档、公司记录或其他接入的服务。RAG 可以成为工作流的一环,但它本身不等于 Agent。
RAG(Retrieval-Augmented Generation,检索增强生成)由“检索”和“生成”两步构成:系统先把用户问题转成向量,在向量数据库或文档库中检索最相关的片段,再把这些片段连同原问题一起送入模型生成答案。它的价值在于让模型基于外部、可更新的知识作答,从而缓解模型知识过时和“幻觉”问题。但 RAG 只是一种信息注入手段,检索什么、何时检索仍由人设计的流程决定,因此它本身不具备自主决策能力。
第三层:AI Agent——给目标,自己找路径
假设你想每天早上发布科技热点内容。传统工作流会按固定顺序收集文章、总结、生成帖子、存入表格;结果不理想时,你得手动改指令、重跑、反复调整。
Agent 的不同在于:你只给目标——"找相关科技新闻,写成有吸引力的社交媒体帖子"。它自己决定搜哪些来源、调用哪些工具收集信息、如何总结、怎么起草,然后评估产出:内容相关吗?准确吗?格式对吗?开头够不够抓人?不合格就修改再检查。
关键差异在于决策权。Agent 不只是执行固定序列,而是在推理、行动、观察结果、调整策略的循环中逼近目标。这种"自己做决定"的能力,正是 agentic 系统强大的根源。
当然,Agent 也会犯错:用错工具、产出不可靠结果。涉及重要操作时,人工审批仍然必要。Web Oracle 举了一个典型场景:让 Agent 在海量视频素材中找出所有包含滑雪者的片段。人只给出目标,Agent 负责分析、识别、返回结果——原本需要人工逐帧观看并打标签的工作被大幅压缩。
放到业务场景里同样成立:调研竞品、准备报告、整理线索、管理内容生产,都可以从"一次交代一个任务"升级为"给一个更大的目标,让它在权限和边界内自己推进"。这是一种完全不同的 AI 使用方式。
“推理—行动—观察—调整”的循环在业界常被称为 ReAct(Reasoning and Acting)模式:模型先输出一段思考,决定调用哪个工具或执行哪个动作,观察工具返回的结果,再据此修正下一步计划,如此往复直到任务完成或达到停止条件。这一循环让 Agent 能处理步骤事先无法完全枚举的开放任务,但也放大了出错风险——一次错误的工具调用会被后续推理继承。因此,权限边界、工具白名单和人工审批点,是让 Agent 从演示走向生产的关键工程约束。
三者的本质区别
- 聊天机器人:接收提示词,生成回应。
- AI 工作流:按人预先设计的步骤执行,通常串联多个工具实现自动化。
- AI Agent:接收目标,推理该做什么,调用工具,评估结果,必要时调整路径。
这三类能力并非互斥:Agent 可以运行在工作流内部,工作流也可以包含 AI 模型。真正的分水岭是"决策由谁做出"。自动化解决的是少花人力完成工作;agentic AI 增加的,是对"工作该如何完成"做判断的能力。随着系统成熟,懂得如何驾驭 Agent,可能和今天会用聊天机器人一样重要。
常见问题
AI Agent 和自动化脚本有什么区别? 自动化脚本按预设规则执行;Agent 面对目标会自行选择路径,并根据结果反馈修正做法。
不懂编程能用 Agent 吗? 可以。文中三层划分本身就不依赖编程知识,理解"目标—行动—评估—调整"的循环即可上手。
Agent 会取代工作流吗? 不会。两者是包含关系,稳定的重复流程用工作流更可控,需要灵活判断的任务更适合交给 Agent。
相关推荐

RAG调试知识如何沉淀?AI团队的知识管理之痛
AI团队在RAG调试和审计中积累的知识如何有效沉淀与复用?本文剖析当前知识管理的三种模式及其痛点,并探讨证据支撑的案例记忆系统这一产品构想的技术可行性与商业挑战。

OneMemory 1.4.2 发布:为AI代理打造的自托管共享记忆工具
OneMemory 1.4.2 发布,一个支持 MCP 和 REST 接口的自托管共享记忆服务器,新增写入者追踪、不信任列表、离线命令排队和安全升级备份,适合个人开发者与 AI 代理场景。

丹麦政府悄然放弃弃用微软Office计划
丹麦政府悄然放弃用开源办公软件替代微软Office的大规模试点,引发Hacker News热议。本文梳理事件经过,分析开源迁移在兼容性、成本与数字主权之间的现实挑战。