灵巧手新突破:实现手内物体姿态到达与安全过滤

研究提出手内物体姿态到达任务,用仿真训练配方实现零样本迁移,并引入可调安全过滤器平衡性能与安全。
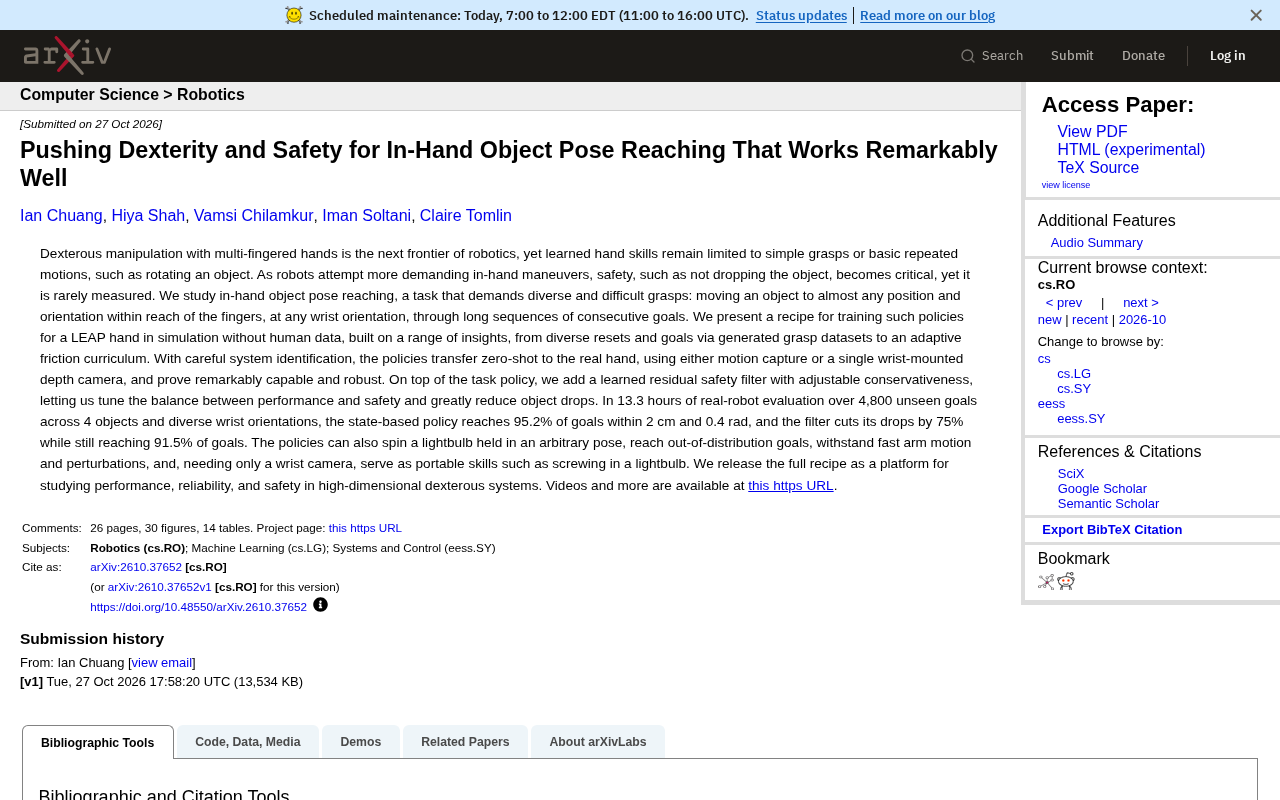
该研究聚焦多指灵巧手的手内物体姿态到达任务,要求机器人将物体移动到手指可达范围内的几乎任意位置和方向,并能在任意手腕朝向下连续完成长序列目标。研究团队为 LEAP 手开发了一套无需人类数据的仿真训练配方,包括多样化抓取数据集、自适应摩擦课程和精细系统辨识,实现了零样本迁移到真实手部。基于状态的策略在超过 13.3 小时的真实评估中达到 95.2% 的目标成功率。此外,学习到的残差安全过滤器可调节保守性,将物体掉落减少 75%,同时保持 91.5% 的目标完成率。策略还展现出泛化能力,可旋转任意姿态的灯泡、承受扰动,并仅用腕部相机作为便携技能。
多指灵巧手的操作能力是机器人领域的下一个前沿,但目前学习到的手部技能仍局限于简单抓取或基础重复动作(比如旋转物体)。当机器人尝试更高难度的手内操作时,安全性(例如避免物体掉落)变得至关重要,却很少被量化评估。最近一项研究聚焦于“手内物体姿态到达”任务——要求机器人将物体移动到手指可达范围内的几乎任意位置和方向,且能在任意手腕朝向下,连续完成长序列目标。该工作为 LEAP 手在仿真中训练此类策略提供了一套完整方案,无需人类数据,并成功实现了零样本迁移到真实手部,同时引入可学习的安全过滤器来平衡性能与安全。
任务定义与挑战
手内物体姿态到达要求机器人通过多指协调,将物体调整到指定的位置和姿态(位置误差在 2 厘米内,姿态误差在 0.4 弧度内),并且要能够处理连续多个目标,而不是单次动作。这比简单的抓取或旋转复杂得多:它需要多样且困难的抓握方式,并且在整个过程中保持物体稳定。研究团队指出,随着操作难度提升,物体掉落的风险显著增加,但此前的研究很少对安全性进行系统测量。
训练配方:从仿真到现实的零样本迁移
该研究提出了一套无需人类演示数据的训练流程,核心思路包括:
- 多样化的重置与目标生成:通过生成抓取数据集,让策略在训练中接触到丰富的初始状态和目标姿态,避免过拟合到少数抓取模式。
- 自适应摩擦课程:在训练过程中动态调整摩擦系数,使策略逐渐适应不同的接触条件,增强鲁棒性。
- 精细的系统辨识:通过校准仿真与真实系统的差异,策略能够零样本迁移到真实 LEAP 手,仅需动作捕捉或单个腕部深度相机作为输入。
这套配方使得基于状态的策略在真实机器人上表现出色:在超过 13.3 小时的真实评估中,覆盖 4 种物体、4800 个未见过的目标以及多样化的手腕朝向,策略达到了 95.2% 的目标(位置误差 2 厘米、姿态误差 0.4 弧度内)。
零样本迁移(Zero-shot Transfer) 指在仿真环境中训练好的策略,不经任何真实世界的微调或额外数据采集,直接部署到真实机器人上执行任务。这一概念在机器人学习中至关重要,因为真实数据采集成本高、速度慢且存在硬件损耗风险。实现零样本迁移的关键在于缩小“仿真到现实”(Sim-to-Real)的差距,通常依赖域随机化(在训练中随机化物理参数如质量、摩擦、视觉纹理等)和系统辨识(校准仿真器使其更接近真实系统)。本文中,研究团队通过精细的系统辨识与自适应摩擦课程,使策略在真实 LEAP 手上直接达到 95.2% 的成功率,无需任何真实世界样本。
自适应摩擦课程(Adaptive Friction Curriculum) 是一种课程学习策略,在训练过程中动态调整仿真环境中的摩擦系数,使策略从易到难逐步适应不同的接触条件。其核心思想是:若一开始就使用极端摩擦值,策略可能难以学习稳定抓取;而通过课程式地扩大摩擦范围,策略能逐渐学会在低摩擦(易滑落)和高摩擦(易卡死)条件下都保持鲁棒。这种方法尤其适用于多指手内操作,因为手指与物体间的接触力分布复杂,摩擦不确定性是导致物体掉落的主要原因之一。本文利用该课程显著提升了策略在真实环境中的泛化能力。
安全过滤器:可调节的保守性
为了降低物体掉落的风险,研究团队在任务策略之上增加了一个学习到的残差安全过滤器,其保守程度可以调节。该过滤器在动作输出上叠加一个修正量,当预测到潜在危险时,会倾向于更保守的行为。实验显示,该过滤器将掉落次数减少了 75%,同时仍能完成 91.5% 的目标——性能下降幅度很小。这种可调节的设计允许根据实际应用场景在性能与安全之间进行权衡。
残差安全过滤器(Residual Safety Filter) 是一种在基础策略输出之上叠加修正量的安全机制。具体而言,基础策略(任务策略)负责生成动作以完成目标,而安全过滤器学习一个残差修正量,当预测到潜在危险(如物体即将滑落)时,将动作推向更保守的方向。该过滤器通常以安全为优化目标进行训练,其保守程度可通过调节参数控制——保守性越高,掉落风险越低,但可能牺牲部分任务成功率。本文中,该过滤器将掉落次数减少 75%,同时保持 91.5% 的目标完成率,展示了性能与安全之间的可调权衡。
泛化能力与便携技能
除了基本的姿态到达,这些策略还展现出多种令人印象深刻的能力:
- 可以旋转一个以任意姿态握持的灯泡;
- 能够到达分布外的目标;
- 可以承受快速的机械臂运动和外部扰动;
- 仅需腕部相机即可作为便携技能使用,例如拧灯泡。
这些结果表明,该策略不仅适应性强,而且具备在真实环境中部署的潜力。研究团队将完整配方作为平台公开,以促进高维灵巧系统中性能、可靠性和安全性的研究。
分布外目标(Out-of-Distribution Targets) 指在测试阶段遇到的目标姿态或物体状态未在训练数据中出现过,或其分布与训练分布存在显著差异。在机器人学习中,策略容易过拟合训练中见过的目标,导致在分布外场景下性能骤降。本文中,策略能够到达分布外目标,说明其学到的表征具有一定的泛化能力,而非简单记忆训练样本。这得益于训练中多样化的重置与目标生成机制,使策略接触到丰富的初始状态和目标姿态,从而增强了对外部变化的适应能力。
意义与展望
这项工作的核心贡献在于将安全性纳入灵巧操作的评价体系,并提供了一套可复现的训练方案。通过仿真训练和零样本迁移,它降低了数据收集的成本;通过安全过滤器,它让性能与安全之间的权衡变得可控。对于希望研究高维灵巧系统的团队来说,这提供了一个有价值的起点。未来,如何将这种方法扩展到更多物体类型和更复杂的任务,仍然是值得探索的方向。
相关推荐
Claude Code实战:零代码搭建切片工厂,长视频自动变竖屏短视频
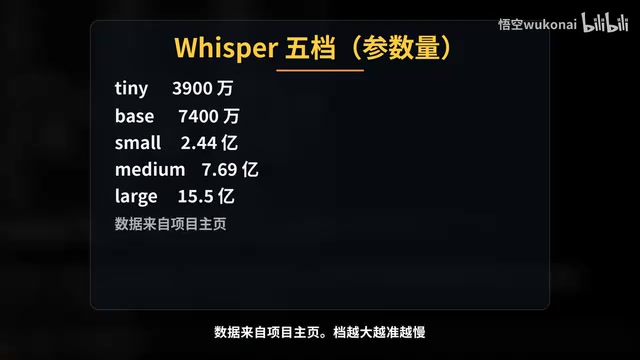
B站UP主悟空用Claude Code零代码搭建切片工厂,将35分钟长视频自动切成10条竖屏短视频。从Plan Mode、Whisper转写、claude.md规则、Hook质检到Subagent审核和Plugin分发,完整实战流程与实测数据。
WorkBuddy保姆级教程:AI Agent如何帮你自动转文件
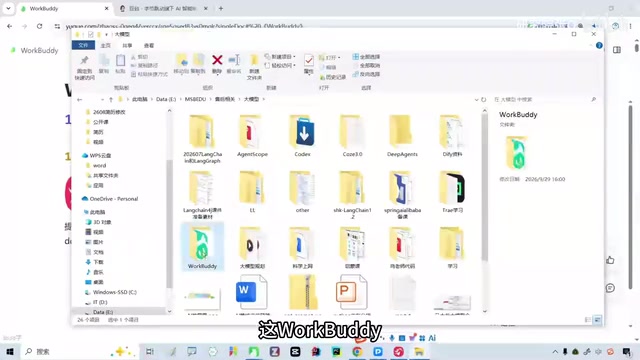
WorkBuddy保姆级教程实战:从豆包只能给方案到AI Agent直接动手,三分钟批量转换PDF并归档。含安装、积分机制、与Codex对比及上手建议。
零基础入门Java+DeepSeek实战:程序员转型AI大模型开发指南
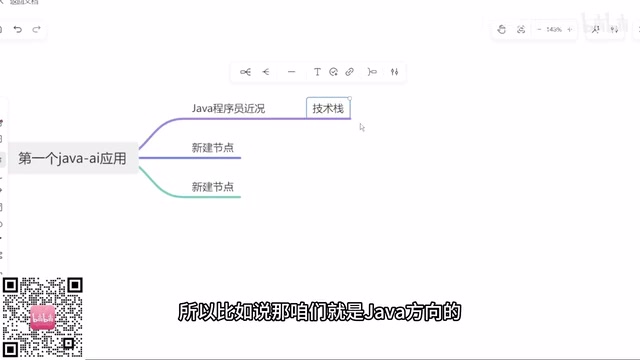
本文基于B站直播教学,详解Java程序员如何零基础转型AI大模型开发,涵盖技能路径、实战构建第一个Java AI应用、简历包装与求职策略,助你抓住大模型时代机遇。