Liquid AI LFM2.5-24B在Mac mini M6实测:70 TPS与128K上下文

LFM2.5-24B在Mac mini M6上以4-bit量化实现约70 tokens/秒本地推理,结合快捷指令优化智能体体验。
本文基于B站UP主的实测视频,梳理Liquid AI的LFM2.5-24B模型在Mac mini M6(32GB内存)上的本地部署表现。该24B MoE模型在智能体与工具使用任务上优于对比的Qwen模型,使用LM Studio加载4-bit量化版本后推理速度约68.8至71.21 tokens/秒,内存占用约28GB,并能在128K上下文窗口下稳定处理5万以上token的会话。UP主通过Apple快捷指令与“技能”封装提升OpenClaw响应速度、减少token消耗。与2.6B小模型对比显示,小模型省内存但智能不足导致任务延迟,24B模型体验更流畅。
Liquid AI 推出的 LFM2.5-24B 模型在本地推理领域引起了广泛关注。一位 B 站 UP 主在 Mac mini M6(32GB 内存)上进行了详细测试,使用 OpenClaw 框架和 4-bit 量化版本,实现了约 70 tokens/秒的推理速度,并成功在 128K 上下文窗口下运行。本文基于该视频内容,梳理关键性能数据、优化技巧以及与小型模型的对比,为关注本地 AI 部署的开发者提供参考。
模型性能与基准表现
据 UP 主介绍,LFM2.5-24B 是一个 24B 参数的 MoE 模型,在智能体(agentic)和工具使用任务上表现突出。视频中引用基准测试数据:在 LiveClaw 评测中得分为 48.09,而对比的 Qwen 模型得分为 38.19,显示出约 50% 的总参数和激活参数优势。UP 主提到,该模型在多数基准上优于 Qwen,仅在 Web Arena 和 Pinch Bench 上稍弱。
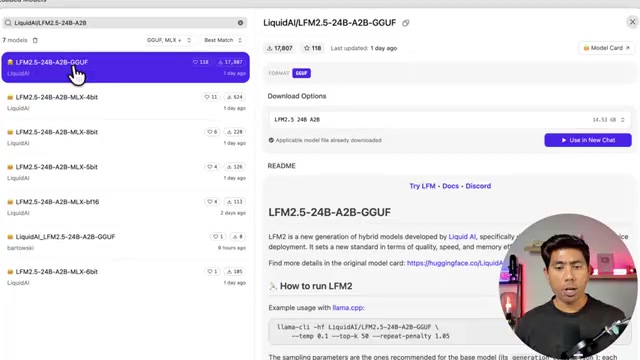
实际推理测试中,UP 主使用 LM Studio 加载 4-bit 量化模型,在简单提示下获得 68.8 tokens/秒;当问题涉及 OpenClaw广告 时,速度达到 71.21 tokens/秒。内存占用约 28GB,模型完全加载并运行 OpenClaw 后台任务。
MoE(Mixture of Experts,混合专家)架构的核心在于将模型拆分为多个“专家”子网络,每次推理只激活其中少数几个专家,因此总参数量虽大,但实际参与计算的激活参数显著更少。这正是文中“24B 参数”与“约 50% 总参数和激活参数优势”说法的背景:LFM2.5-24B 的总参数为 24B,但单次 token 生成仅调用其中一部分,从而在保持较大知识容量的同时降低算力与显存需求,这也是它能在 32GB 内存的 Mac mini 上以 4-bit 量化运行的前提。
Mac mini M6 上的 OpenClaw 集成与优化
UP 主强调,在 Mac mini M6 上高效运行该模型需要优化推理引擎和量化选择。他选择了 4-bit 量化而非 5-bit 或 6-bit,以避免触及 32GB 内存上限。同时,利用 Apple 快捷指令(Shortcuts)和系统内置的 AI 基础模型创建了一系列自动化操作,显著提升了 OpenClaw 的响应速度。
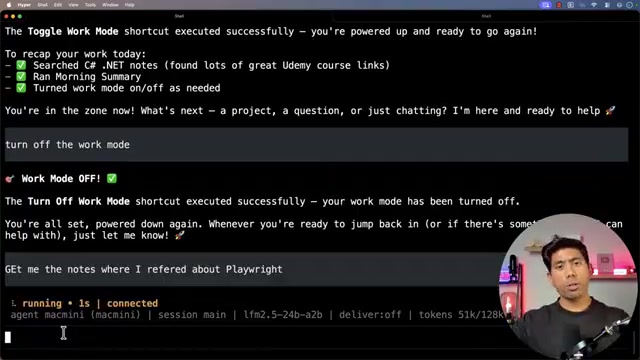
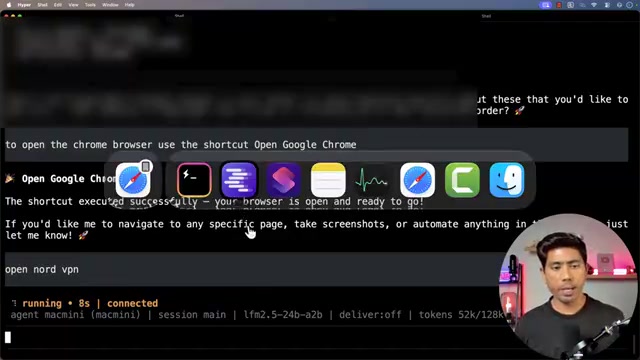
例如,通过快捷指令实现“工作模式”开关(自动打开 VS Code 和 Notes)、查询 Apple Notes 内容、打开 Chrome 浏览器、连接 NordVPN 等。UP 主演示了让 OpenClaw 根据自然语言指令调用这些快捷指令,操作几乎瞬间完成。他还指出,OpenClaw 能记住已使用的快捷指令,并在后续请求中自动复用。
4-bit 量化是指将模型权重从 16 位浮点压缩到 4 位整数表示,使模型体积和内存占用降至约四分之一,代价是少量精度损失。对本地部署而言,量化位宽是内存与质量之间的关键权衡:位宽越低越省内存,但过低会损害推理质量。文中选择 4-bit 而非 5-bit 或 6-bit,正是因为 24B 模型在 5-bit/6-bit 下的权重体积会逼近甚至超过 32GB 统一内存的上限,留给系统与 OpenClaw 后台任务的空间不足,4-bit 成为该硬件上可稳定运行的上限选择。
上下文管理与技能复用
在 128K 上下文窗口下,UP 主展示了处理 50,000+ token 会话的能力。终端显示已使用约 51,000 token,模型仍能稳定生成响应。LM Studio 的服务器日志显示提示处理速度和生成速度保持良好。
UP 主还介绍了“技能”(skills)的概念:将常用快捷指令封装为技能,供 OpenClaw 调用。这样可以减少发送给大模型的 token 数量,降低推理开销。例如,为 Apple Notes 和 Reminders 创建专用技能,模型只需调用技能名称而非详细步骤。
上下文窗口指模型单次对话中能够“记住”的 token 总量,128K 即约 12.8 万个 token。由于 Transformer 的注意力机制计算量随上下文长度增长,长上下文会显著增加提示处理时间与内存占用(KV Cache 随之膨胀)。文中约 51,000 token 的会话已接近窗口一半,仍能稳定生成,说明该模型的长上下文效率较好;而“技能”封装之所以能降低开销,是因为它把冗长的操作步骤替换为简短调用名,直接减少了每次请求注入的 token 数量,从而缩短提示处理时间。
与小型模型的对比:速度与智能的权衡
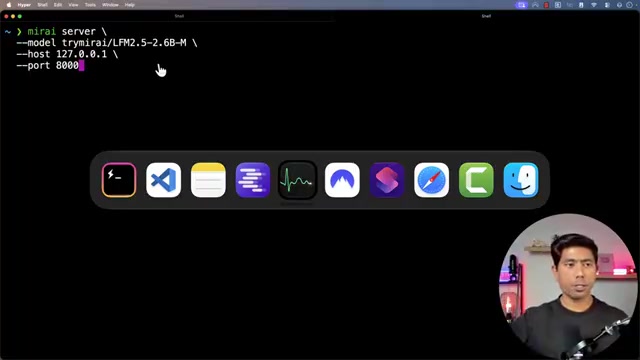
为展示差异,UP 主将模型替换为 LFM2.5-2.6B(通过 Mirai AI 服务器运行)。在相同 OpenClaw 任务(关闭工作模式)中,小型模型内存占用降至 17GB,但操作耗时明显更长,生成速度约 54.2 tokens/秒,且任务未及时完成。
相比之下,24B 模型虽占用近 30GB 内存,但响应迅速且任务完成度高。UP 主总结:小模型节省内存但智能不足导致操作延迟;大模型在 32GB Mac mini 上能提供更流畅的智能体体验。
局限与未来测试
当前测试中,NordVPN 快捷指令无法指定连接位置,UP 主推测需要编写脚本解决。此外,他尚未在 Apple M5 Max 上测试该模型,但引用文档称可达 184 tokens/秒。UP 主表示,若观众感兴趣,可进一步测试 M5 机型及更复杂的任务场景。
总体而言,LFM2.5-24B 在 Mac mini M6 上展现了出色的本地推理性能,结合快捷指令优化,为个人 AI 助手提供了可行方案。对于拥有 32GB 内存 Apple Silicon 设备的用户,这是一个值得尝试的模型。
相关推荐

3分钟看懂DeepSeek:从量化私募到开源AI领跑者的崛起之路
3分钟看懂DeepSeek发展史:从幻方量化的算力积累,到V2的MLA推理降本、V3的557.6万美元训练账单、R1开源引爆全球,再到V4与70亿美元A轮融资,梳理深度求索的关键节点与技术路线。

本地文学创作模型PK:Qwen3.8 27B微调版胜出,DeepSeek v4.1表现平淡
B站UP主横向测评七款本地文学创作模型:海明威、HumanLike Chat基于Qwen3.8 27B微调表现最佳,DeepSeek v4.1叙事平淡,东方朔角色混乱垫底。附三道测试题评分与使用建议。

梁文锋的三次豪赌:DeepSeek为何将82%毛利开源?
DeepSeek为何把82%毛利的推理框架DeepInfer开源,又启动千亿融资?从技术路线、国产芯片到组织纯粹性,解析梁文锋的三次豪赌与开源战略背后的商业与理想逻辑。