LiteLLM 智能路由实战:本地 LLM 的大小模型自动分流
LiteLLM 作为本地多模型统一网关,按任务复杂度自动路由到最合适的模型,兼顾算力效率与开发体验。
本文介绍了如何用 LiteLLM 搭建一个本地多模型智能路由系统。在 Apple M5 Max 这类高配本地机器上同时运行 Ollama、MLX、LM Studio 等多个模型提供商时,手动按任务切换模型既低效又不现实。LiteLLM 作为统一网关,通过启发式分类器和 LLM 分类器两种方式评估提示词复杂度,自动将简单查询分流到小模型(如 Qwen3.5 4B),将代码生成等复杂任务路由到大模型(如 Gemma)。整套配置通过 Docker Compose 一键拉起,对上层应用(如 Pi Coding Agent)完全透明。实测中三个模型常驻内存共占用约 86GB,但在 Apple Silicon 统一内存架构下可行。该方案的核心价值是在不改变现有工具链的前提下,以近乎无感的方式实现本地算力的按需调度。
为什么本地 LLM 需要一个"交通调度员"
在本地机器上跑大模型早已不是新鲜事。Ollama、MLX、LM Studio 这些工具让 Gemma、Qwen、Llama 等模型可以在个人电脑上流畅运行,再搭配 Pi Coding Agent 或 Codex 这类编程助手,本地 AI 编程工作流基本成型。但问题随之而来:并不是每个任务都值得动用最大的模型。
正如 B 站 UP 主在演示中指出的,即便手握 Apple M5 Max 这样的强力机器,每一次把全部提示都丢给最大模型,都会消耗大量计算资源。查询"包含代码的仓库是什么"这种简单问题,和"帮我构建一个机器学习算法"这类复杂任务,根本不该用同一个模型来处理。
核心矛盾在于:不同的编程代理需要不同的端点、模型名称、运行时和能力,而本地同时跑着多个提供商(Ollama、MLX、LM Studio)时,手动切换几乎不可行。这正是 LiteLLM 要解决的问题——它充当一个统一网关,根据任务复杂度自动把流量路由到最合适的模型。
LiteLLM 到底做了什么
LiteLLM 本质上是一个连接不同模型提供商的网关层。你只需要创建一份配置(契约),就能接入 Ollama、MLX、LM Studio 这些本地提供商,同时也支持 OpenAI、Gemini、DeepSeek广告 等云端服务——官方宣称可连接一百多个 LLM 提供商。
但它远不止是一个"API 翻译器"。UP 主强调,LiteLLM 内置了身份验证、负载均衡、日志记录、成本追踪、速率限制等一整套功能。对于需要在多模型、多提供商之间调度的场景,这些能力把它从一个简单代理提升为真正的流量控制中枢。
有人可能会问:既然 LangGraph 之类的框架已经能做类似编排,为什么还要再加一层 LiteLLM?答案在于本地场景的特殊性——当你用本地模型跑本地编程代理时,"每次操作都用最大模型"是不可承受的资源浪费,而 LiteLLM 的智能路由恰好在模型选择这一环节做了精细的分类决策。
LiteLLM 对外暴露一个兼容 OpenAI API 格式的统一端点,这意味着任何支持 OpenAI 接口的客户端(包括各类编程代理、IDE 插件、脚本)无需修改代码就能接入。它通过一份 YAML 配置文件声明所有模型的「别名」和路由规则,底层再自动处理各提供商之间的参数差异——例如 Ollama 使用本地 HTTP 端口,MLX 有自己的运行时格式,而 OpenAI 需要 API Key 认证,LiteLLM 在网关层统一抹平这些差异。其「代理服务器」模式(Proxy Server)以独立进程或 Docker 容器形式运行,对上游应用完全透明,也是本文演示中采用的部署方式。
两种分类器:启发式 vs LLM 分类器
LiteLLM 提供两种路由分类方式。
启发式分类器通过预定义信号给提示词打分,包括长度、是否含代码、推理需求、token 数量和复杂度模式,然后把分数映射到对应的路由层级(如 small / medium / complex)。它的优势是快速、无需额外模型开销。
LLM 分类器则使用一个小型语言模型来理解提示的语义,由这个"分类器模型"来决定该走哪个层级。在演示中,UP 主采用的是 LLM 分类器,分类器模型跑在 Ollama 里,所有"选哪个模型"的决策都交给它处理。
一个值得借鉴的配置细节:UP 主把启发式分类器设为 LLM 分类器的回退方案。也就是说,一旦分类器模型因故障(模型挂了、镜像丢失)无法工作,系统会自动降级到启发式分类,保证路由不中断。同时还设置了默认路由模型指向小模型(Qwen3.5 40亿参数),确保每次运行都有兜底选择。
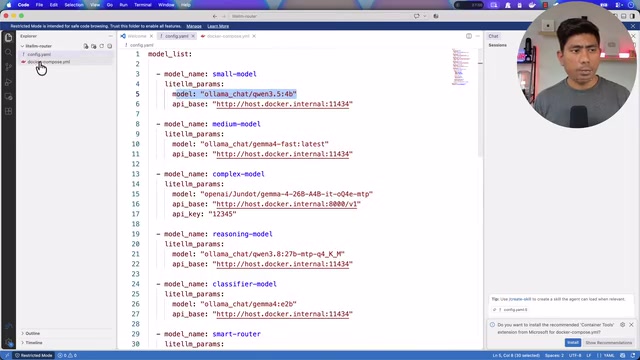
整套配置通过 Docker Compose 的 YAML 文件管理,一条 docker compose up -d 就能把网关、分类器、路由规则全部拉起。
这两种分类器对应 LiteLLM 中的 router_settings 配置项,具体字段为 routing_strategy。启发式分类器(simple-shuffle 或基于规则的策略)依赖静态特征,计算成本接近零,适合对延迟极度敏感的场景;LLM 分类器在实现上通常是向一个轻量级模型发送包含原始提示的元请求,让该模型输出一个分类标签(如 low / medium / high),再依据标签查表选模型。这个分类器模型本身也消耗推理资源,因此通常选用参数量极小的模型(1B–3B 量级)以保证分类延迟在百毫秒内。将启发式分类器设为 LLM 分类器的 fallback 是一种防御性设计,可避免分类器模型崩溃时整个路由层级联失败。
实测:同一窗口,三个模型自动分流
演示环节最有说服力。UP 主在 LiteLLM 的仪表盘里连续抛出三个难度递增的问题,观察路由器的决策:
- 问"光速是多少"——这类简单事实查询,路由器选择了 Qwen3.5 40亿参数小模型,响应极快;
- 问"怎么从惠灵顿坐飞机到新西兰"——复杂度上升,路由器切换到了 Gemma 最新快速模型,输出风格明显不同;
- 问"能帮我构建机器学习算法/用全新技术微调大模型"——更高复杂度的任务,仍由 Gemma 模型处理,实测速度稳定在每秒 93.1 个 token。
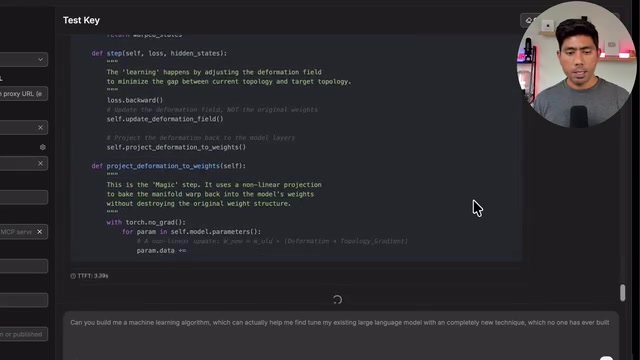
关键点在于:这一切发生在同一个聊天窗口内,用户完全无感知。路由器根据负载自动在三个模型间切换,这与 Visual Studio Code 自动按负载选模型的体验高度相似。
接入 Pi Coding Agent 的真实表现
把 LiteLLM 接入 Pi Coding Agent 后,效果更贴近实际开发场景。UP 主打开活动监视器显示,由于三个模型(含 MLX 里的 Gemma)同时驻留内存,总占用达到了 86GB。
再次提出视频开头那个"这个仓库能构建什么新功能"的问题时,可以看到由于问题相对简单,系统启用的是较小的 Qwen3.5 模型。而当追问"你能帮我构建这个功能"这类需要生成完整代码的复杂请求时,Qwen 明显力不从心,路由器随即把流量转给唯一的复杂推理模型 Gemma,token 速率稳定在 80-95 区间。
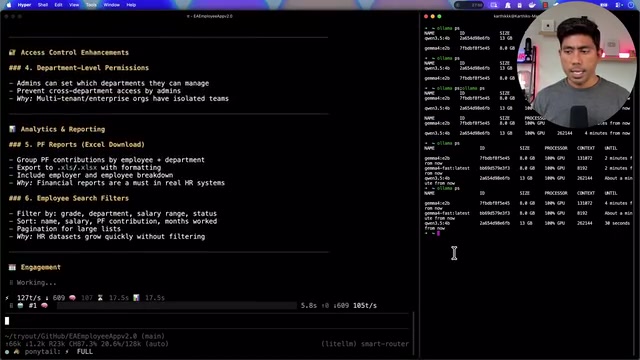
这里体现了一个巧妙的工作流设计:小语言模型先掌握会话中所需的全部上下文,当遇到真正复杂的操作时,再把流量路由到更大的模型来完成。UP 主还提到,如果换用 Qwen3.8 的 270亿参数模型,配合编程助手的效果会更出色。此外,LiteLLM 还支持为同一模型配置不同量化版本,针对不同操作灵活调度。
MLX 是苹果为 Apple Silicon 设计的机器学习框架,专门针对统一内存架构(CPU 与 GPU 共享同一物理内存)做了优化。在 M 系列芯片上,MLX 能以接近原生 Metal 的速度运行量化模型,而无需像 CUDA 那样在 CPU 内存和显存之间拷贝数据。这也解释了为何演示中三个模型同时常驻内存能达到 86GB——在 Apple Silicon 上,「内存」即是统一的系统内存,模型权重直接由 GPU 计算核心访问,因此内存容量(而非显存)成为本地多模型并发的瓶颈。M5 Max 最高支持 128GB 统一内存,这是该演示得以实现的硬件前提。
这套方案值得尝试吗
对于手握高配置本地机器、同时又关注资源效率的开发者来说,LiteLLM 的智能路由提供了一个务实的解法。它不需要你放弃任何现有模型或提供商,而是用一个统一网关把它们串联起来,按需调度。
核心价值可以归纳为三点:降本——简单任务不再浪费大模型算力;统一——多提供商、多模型通过一份契约接入;韧性——LLM 分类器失效时自动回退到启发式分类。
当然,这套方案也有代价。多模型常驻内存意味着对硬件内存要求不低(演示中达到 86GB),而 LLM 分类器本身也会引入额外的推理开销。对于只跑单一模型的轻量场景,这层路由可能是过度设计。但对于追求"本地 AI 编程全家桶"的进阶用户,LiteLLM 确实让多模型协作从繁琐变得几乎无感。
相关推荐

智能体底座(Harness)比模型本身更关键:YC深度解析Agent架构演进
YC在Harness Night分享会上提出:决定智能体能力的关键不是模型本身,而是外层的Harness底座。本文梳理从GPT-2到自改进Harness的演进,解析Prime Agent、OpenJarvis、QM三大实践及Agent架构设计要点。

用n8n搭建LinkedIn线索抓取与丰富化自动工作流
一套基于n8n的LinkedIn线索抓取与丰富化自动工作流:只需填写职位、地点、行业和公司规模,系统即可自动生成含专业邮箱和验证状态的客户名单并写入Google表格。本文解析其流程、输出字段与合规注意事项。

SageMaker HyperPod:跨团队共享GPU集群的隔离与公平性实践
Amazon SageMaker HyperPod 推出跨团队共享GPU集群的参考架构,通过IAM Identity Center认证、Kubernetes命名空间隔离、Task Governance公平调度和成本分摊,实现算力安全共享与费用透明化。