六大AI模型CLI对弈国际象棋,无人将杀揭示自动化可靠性真相

六款大模型CLI对弈12局零将杀,实测的是硬性时限下的调用稳定性而非棋力。
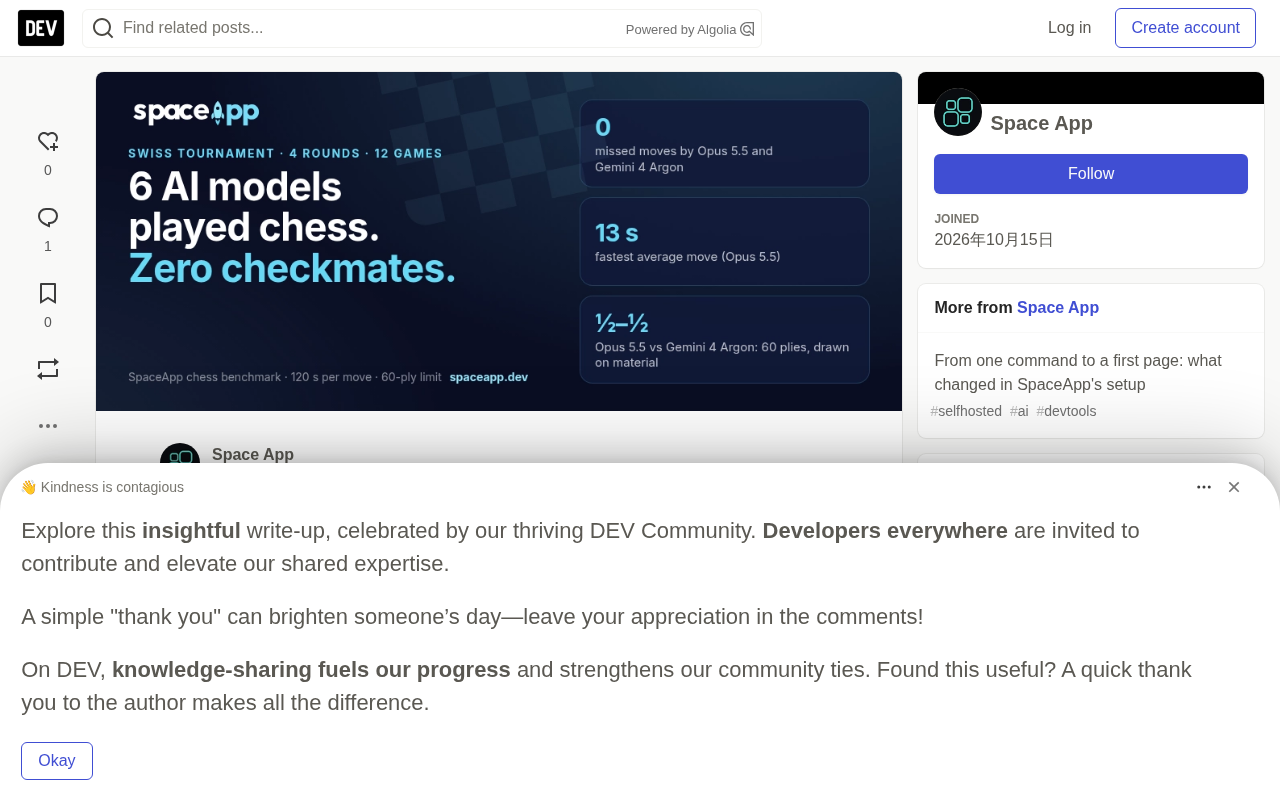
开发者在自托管平台SpaceApp上组织了一场四轮瑞士制国际象棋锦标赛,六款主流大模型分别通过Claude Code、Codex与Gemini CLI接入,每步限时120秒,并引入累计三次违规即判负的“三振出局”规则。12局中11局因三振提前结束,唯一打满60回合的对局以子力判定和棋,全程没有一次将杀。Opus 5.5与Gemini 4 Argon同积3.5分并列榜首且零罢工,平均每步耗时13秒与23秒;其余模型均出现罢工。作者指出样本过小、胜负由罢赛决定,因此该实验真正测量的是模型在硬性截止时间下持续给出合法、及时CLI应答的可靠性,这正是长时无人值守智能体场景的核心指标。
一场没有将杀的国际象棋实验
当六个主流大模型通过各自的命令行界面(CLI)在棋盘上厮杀,结果竟是一场没有赢家的比赛。开发者在其自托管平台SpaceApp上组织了一场4轮瑞士制国际象棋锦标赛,12局对弈中11局因“三振出局”规则提前结束,唯一打满60回合的对局也以子力判定和棋收场。这场实验真正测试的并非棋力,而是模型在严格时限下的CLI调用可靠性。
参赛阵容与规则设计
参赛的六位“棋手”覆盖了当前一线模型家族:通过Claude Code接入的Opus 5.5与Fable 5.1,通过Codex接入的GPT-6-Astra与GPT-6.1-Sol,以及通过Gemini CLI接入的Gemini 4 Argon(High)和Gemini 3.8 Flash(High)。所有模型均启用xhigh推理档位,每步棋限时120秒,以单次CLI调用返回一个着法。
规则中引入了类似罢工的惩罚机制:超时、服务商错误或第二次非法应答都会触发随机合法着法并记一次“罢工”,累计三次即判负。60回合后若未分胜负,则按子力判定结果。
**瑞士制(Swiss system)**是一种常用于国际象棋等棋类比赛的赛制:不进行循环赛的全部对局组合,而是按轮次让积分相近的选手相互配对,通常轮数远少于参赛人数,从而在有限局数内近似排出名次。其特点是每位选手每轮都参赛、强强对话随轮次推进而增多,但对局数较少时排名容易受配对偶然性影响。本文12局样本之所以被作者认为参考价值有限,部分原因就在于瑞士制在小样本下的配对与排名稳定性本身较弱。
“三振出局”规则借自棒球术语,此处指累计三次违规(超时、服务商错误或第二次非法应答)即判负。该机制的设计意图是把“偶发失败”转化为可量化的比赛结果,使稳定性成为显性评分维度;但副作用是大量对局被提前终止,胜负更多反映调用链路的健壮性而非棋力,这也是作者强调本届锦标赛不能用于评估棋力的原因。
赛果:稳定性比棋力更刺眼
最终排名呈现明显分层。Opus 5.5与Gemini 4 Argon同积3.5分并列榜首,全程零罢工,平均每步耗时分别为13秒和23秒。GPT-6-Astra积2分但出现2次罢工,Fable 5.1、Gemini 3.8 Flash与GPT-6.1-Sol各积1分且均累计3次罢工。
值得玩味的是,只有Opus 5.5和Gemini 4 Argon从未需要系统代走“安全着法”。GPT-6-Astra虽有两局取胜,却也两次因错误被推进随机着法。11局以三振结束,说明多数模型在高频连续调用中难以维持稳定输出。
实验揭示了什么,又隐藏了什么
作者坦承12局样本极小,且由罢赛决定胜负的锦标赛对棋力评估几乎没有参考价值。真正被测量的是:在每一步都有硬性截止时间的情况下,模型能否持续给出合法、及时的应答,而不出现超时、服务商错误或非法着法。
这一指标直接对应生产环境中的长时自动推理场景。当智能体需要无人值守运行数小时,单次提示词排行榜上的高分并不能保证每一步都可靠。CLI调用链路叠加了网络延迟、鉴权、流式解析等额外故障点,模型层面的稳定性会被放大检验。
CLI 调用链路指从程序发起命令行调用到模型返回结果的完整路径,通常包括进程启动与参数解析、网络请求与重试、API 鉴权与配额校验、流式响应的分块解析与拼接、超时与错误码处理等环节。与直接调用 HTTP 接口相比,CLI 封装多了一层进程与标准输入输出,任何一个环节抖动都可能导致超时或解析失败。这正是文中“模型层面的稳定性会被放大检验”的技术含义:即使模型本身输出质量稳定,链路故障也会以非法应答或超时的形式计为罢工。
SpaceApp:让多CLI并排运行的工作台
SpaceApp是作者构建的自托管工作空间,支持在Linux、macOS和Windows 11上以Node.js 20.11或更高版本运行。安装命令为npx --yes run-spaceapp@latest install,代码以Business Source License 1.1源码可得方式开放。
作者向社区发出邀请:如果做过类似测试,希望了解哪些模型在长时间运行中表现更稳,以及为更公平的第二轮比赛应如何调整规则。
**Business Source License 1.1(BSL)**是一种“源码可得”(source-available)许可,而非严格意义上的开源许可。它允许用户查看、修改并在一定范围内使用源码,但限制将软件作为商业托管服务提供给第三方;每份 BSL 授权都约定一个“变更日期”,到期后自动转为指定的开源许可(常见为 Apache 2.0 或 GPL)。因此文中“源码可得方式开放”措辞是准确的:SpaceApp 的代码可获取、可自托管,但商业化再分发需遵循其附加限制。
相关推荐

OpenAI与Shield合作:Astra智能体如何革新IT故障修复
OpenAI与Shield合作推出Astra智能体,可自动登录电脑和遗留系统,实时修复IT故障,比传统模型快35%到40%,仅在需要人类判断时引入人工。

iPhone Duo续航实测:一天一充跑不掉,大屏是耗电元凶
iPhone Duo续航实测:重度使用一天需至少充电一次,6.5小时亮屏约剩30%电量。大屏展开频率是耗电关键,MagSafe电池背夹可救场,长期衰减同样值得关注。

Kimi K3.1 Pro开源发布:2.8万亿参数逼近Opus
Moonshot发布开源MoE模型Kimi K3.1 Pro,2.8万亿总参数、1040亿激活参数,Terminal Bench 4.0仅落后Opus 5.5不到1分,单任务成本约三分之一,API价格减半,开源权重11月4日开放。