浏览器Agent看图的代价:opencli与claude-in-chrome的Token账单

7500+次真实调用显示,截图调用Token约为文本的5倍,优先读文本可省约27%开销。
文章基于开发者对7,500多次浏览器工具调用的真实API计数,比较了claude-in-chrome(返回截图)与opencli(返回文本)的Token消耗。结果显示,截图调用中位数消耗1,855 Token,约为文本调用(373 Token)的5倍,仅占23%的截图调用却贡献了49%的总Token消耗。opencli每次调用中位数为397 Token,与文本路径持平,两者差距完全来自截图。在9个网站的对比中,opencli在7个上胜出,按调用量加权平均节省约27%,Telegram Web等已登录应用节省高达85%。作者据此提出“API→文本→截图”的优先级,并主动披露了非严格A/B测试、截图上下文残留、样本偏差等局限。
一个被忽视的成本:让AI"看"网页有多贵?
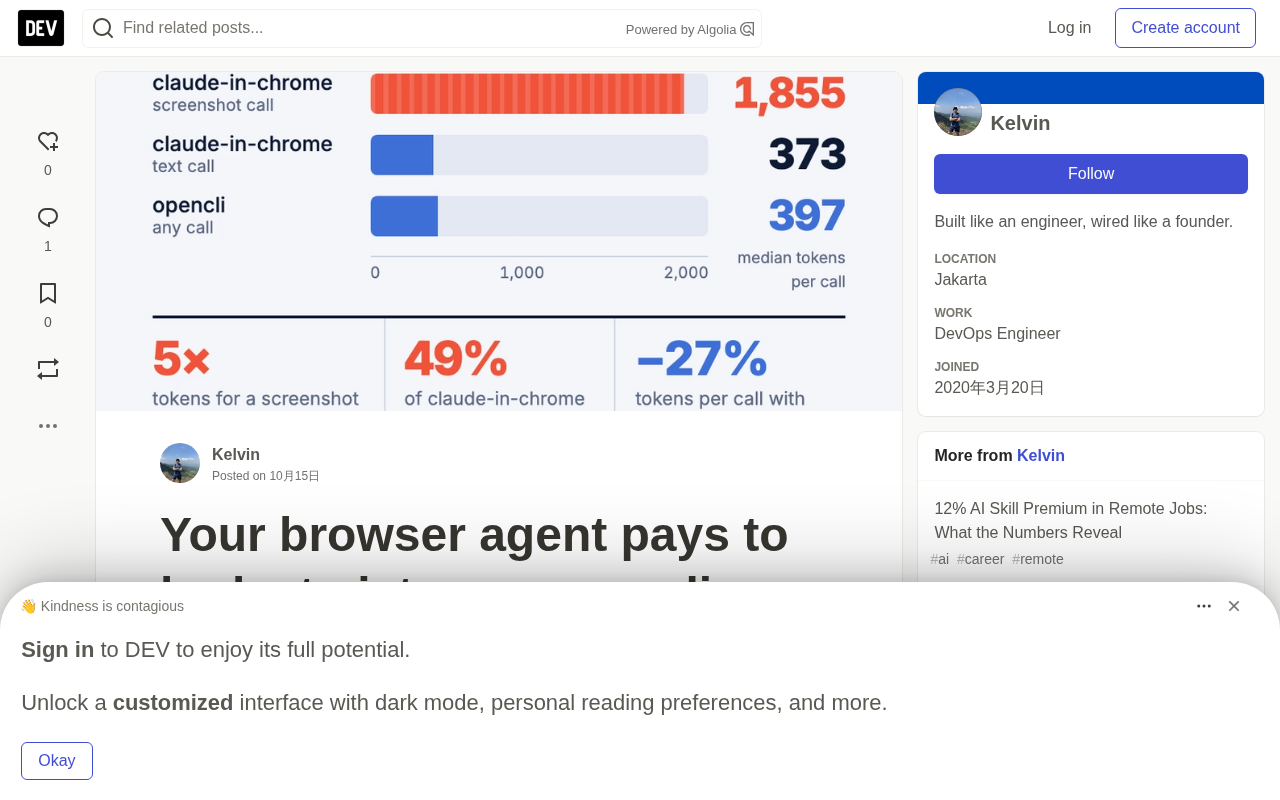
当我们让Claude Code帮我们做clickops——读仪表盘、查设置、从网页应用里拉一个数字——通常会选择两种路径:claude-in-chrome驱动Chrome并返回截图,或者opencli驱动同一个已登录的Chrome但返回纯文本。
问题在于:这两种方式在Token消耗上差距有多大?有开发者在Dev.to上分享了一组基于真实API计数的测量数据,覆盖了7,500多次浏览器工具调用,结论相当直观。
截图调用占了近一半的Token
测量方法是遍历真实的Claude Code会话日志,对每次调用取API报告的前后Token数差值。这不是基于字符数的估算,而是真实的API计数。
结果如下:
| claude-in-chrome调用类型 | 调用占比 | 每次调用中位数Token |
|---|---|---|
| 返回截图 | 23% | 1,855 |
| 仅返回文本 | 77% | 373 |
一次截图调用的Token消耗大约是文本调用的5倍。更关键的是,仅占23%的截图调用贡献了claude-in-chrome总Token消耗的49%。
opencli的每次调用中位数为397个Token,和claude-in-chrome的文本调用基本持平。两个工具的差距完全来自截图,而非文本提取本身。
Token与多模态输入的分层定价
理解这组数据需要先了解大模型处理图像的机制。当Claude接收一张截图时,图像并非以像素形式直接输入模型,而是先被视觉编码器切分成若干图像块(patch),每块转换为一组视觉Token,再与文本Token拼接进入同一上下文窗口。一张1920×1080的网页截图通常会产生1000至1600个视觉Token,具体取决于模型的分辨率切分策略。这正是截图调用中位数(1,855 Token)远高于纯文本调用(373 Token)的根本原因——网页文本经HTML→Markdown提取后往往只有几百字,而同样的页面对应的视觉信息却要膨胀数倍。此外,多数API对图像输入按Token等价计费,视觉Token和文本Token消耗同一份预算,所以截图不仅挤占上下文长度,也直接推高单次调用成本。
同一批网站,两种工具的实际差距
在9个至少各有10次以上调用的网站上,该开发者对比了两种工具每次调用的中位数Token差异:
| 网站 | claude-in-chrome | opencli | 变化 |
|---|---|---|---|
| telegram.org | 1,879 | 275 | −85% |
| github.com | 580 | 336 | −42% |
| cloudflare.com | 578 | 378 | −35% |
| google.com | 605 | 437 | −28% |
| linkedin.com | 736 | 594 | −19% |
| youtube.com | 542 | 470 | −13% |
| lokerdollar.com | 432 | 386 | −11% |
| nvidia.com | 363 | 384 | +6% |
| bing.com | 270 | 353 | +31% |
opencli在9个网站中的7个上胜出,按调用次数加权后,每次调用平均减少约27%的Token消耗。优势最大的场景是已登录的Web应用,比如Telegram Web、GitHub和Cloudflare仪表盘——这些页面复杂,截图信息密度低,文本提取的价值就凸显出来了。
但并非所有场景都是opencli占优。在简单的公开页面上,两个工具表现接近甚至持平;Bing上opencli反而多用了31%的Token。nvidia.com和bing.com两行的样本量均不足30次调用,结论仅供参考。
实操规则:先文本,后截图
基于这组数据,该开发者给自己团队定下了clickops的三条规则:
- 有API或curl可用时,优先用API
- 用opencli以文本方式读取页面
- 只有在需要检查视觉元素时才截图
这个优先级排序的逻辑很清晰:API调用的Token效率最高,文本提取次之,截图是成本最高的兜底方案。把截图限制在真正需要视觉判断的场景——比如检查布局错位、确认图表渲染、验证UI状态——能显著降低日常浏览器自动化的Token开销。
clickops之外的通用原则
这套“API→文本→截图”的优先级并不局限于clickops场景,它是整个Agent工具设计的一条通用权衡。任何一次工具调用返回的观察结果,都会以Token形式永久驻留在对话上下文中,并在后续每一轮被重新读取计费。因此工具输出越冗长,其边际成本就越高——不只是这一次调用贵,而是此后每轮推理都在为它付费。截图的问题正在于此:一张截图可能被模型在多轮中反复“看”,而文本提取的内容短且可被后续摘要压缩。工程上的常见对策包括:让浏览器工具在返回前先做一次摘要或只返回与当前任务相关的片段;对确实需要的截图,用视觉描述替代原图;以及在多轮任务中定期清理或折叠历史观察结果,避免上下文无限膨胀。
这个测量有哪些局限
该开发者主动披露了方法的边界,这些限制值得关注:
任务不完全对等。 网站对比是按相同网站匹配调用,并非同一任务用两种工具各跑一遍,因此这是现场测量而非实验室A/B测试。
截图结果会残留上下文。 截图返回后留在上下文中,后续轮次还会被重新读取。由于两个工具的会话长度不同,这部分成本被排除在外,意味着截图的实际代价可能比数据显示的更高。
样本偏差。 部分网站调用量偏少,个别行不足30次调用,统计意义有限。
尽管存在这些局限,"截图的Token成本远高于文本"这一核心结论,在7,500+次真实调用的大样本下仍然成立。对于任何在Agent工作流中大量使用浏览器自动化的人来说,这组数据提供了一个明确的优化方向:能读文本就不截图。
背景补充
为什么网页文本提取能如此精简
opencli这类工具之所以能把单次调用压到400 Token以内,关键在于它对DOM做了大幅剪枝。原始HTML页面动辄包含几十万字符的标签、内联样式、脚本和注释,直接塞给模型既昂贵又容易干扰推理。主流做法是先将页面转为可访问性树(accessibility tree)或语义化Markdown,丢弃样式与装饰性节点,只保留标题、正文、链接、表单控件等有语义的元素。以GitHub仓库页为例,完整HTML可能超过200KB,但提取后的结构化文本通常只有2至5KB,折合几百个Token。这种压缩比是文本路径的核心优势,也是它能在Telegram Web、Cloudflare仪表盘这类重度前端应用上仍保持低开销的原因。不过剪枝也有代价:一旦页面依赖Canvas渲染、动态图表或纯视觉状态(如按钮的禁用灰化),文本提取就会丢失信息,此时才需要回退到截图。
相关推荐

iPhone Duo续航实测:一天一充跑不掉,大屏是耗电元凶
iPhone Duo续航实测:重度使用一天需至少充电一次,6.5小时亮屏约剩30%电量。大屏展开频率是耗电关键,MagSafe电池背夹可救场,长期衰减同样值得关注。

Kimi K3.1 Pro开源发布:2.8万亿参数逼近Opus
Moonshot发布开源MoE模型Kimi K3.1 Pro,2.8万亿总参数、1040亿激活参数,Terminal Bench 4.0仅落后Opus 5.5不到1分,单任务成本约三分之一,API价格减半,开源权重11月4日开放。

Costco科技产品价格竞猜:显示器、键鼠、Bose音响值不值?
YouTube博主在Costco竞猜科技产品价格:2K 180Hz显示器、罗技键鼠、Bose音响和CyberPower UPS实测估价,揭示仓储会员店的选品定价逻辑与品牌溢价真相。