llama.cpp:C++实现的大模型本地推理引擎

llama.cpp以纯C/C++实现LLM推理,靠量化和自研ggml库让大模型跑在普通硬件上。
llama.cpp是ggml-org维护的纯C/C++大模型推理引擎,GitHub星标超13.4万、fork超2.5万。文章指出,选择C/C++是为了满足推理阶段对低内存、快启动、少依赖和易部署的要求,其自研ggml张量库避开了主流深度学习框架。量化是其关键能力,通过压缩权重位宽降低模型体积和内存带宽需求,使消费级设备也能运行较大模型。项目定位为推理引擎而非应用框架,作为通用底座被上层聊天、RAG等工具调用,活跃社区也推动了新模型架构的快速适配。文章最后建议开发者从官方示例和小模型入手,理解量化档位与硬件后端选择后再逐步替换为目标模型。
llama.cpp:C++实现的大模型本地推理引擎
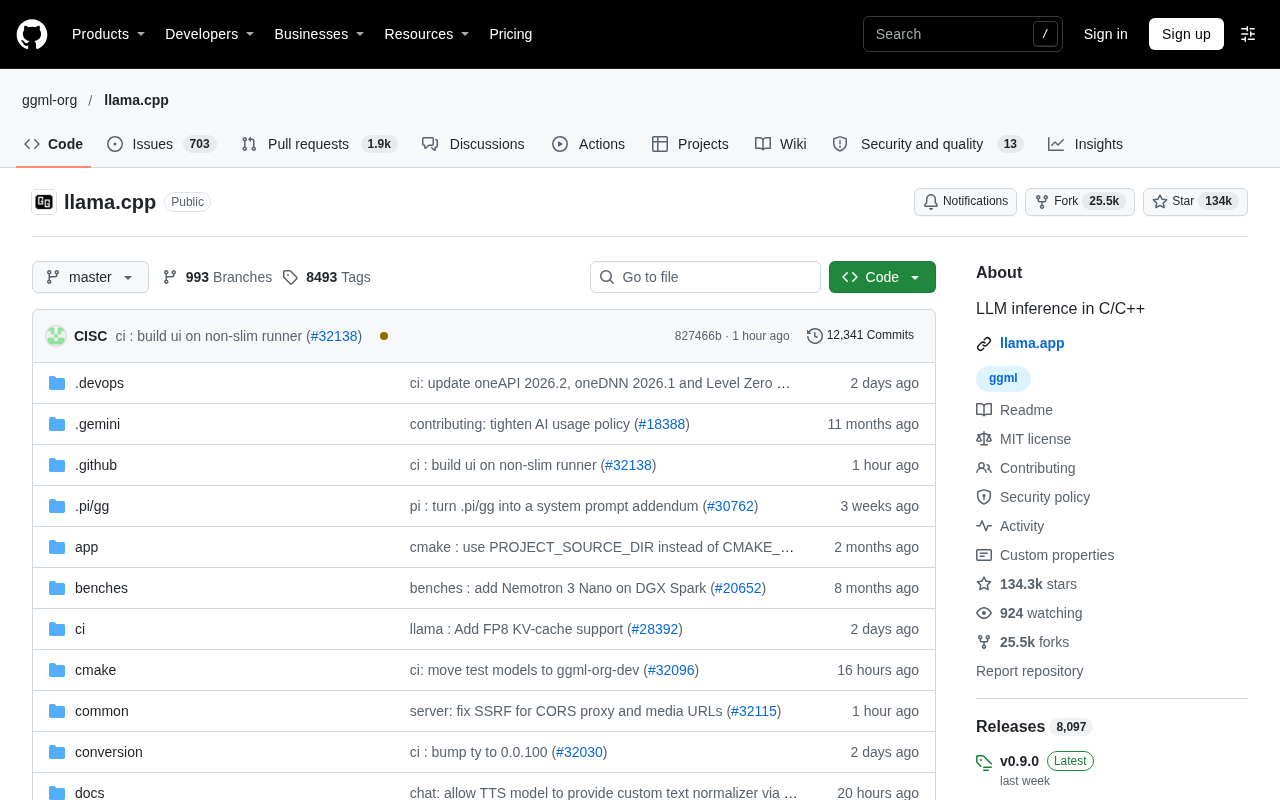
在云端API主导的AI应用浪潮中,一个用纯C/C++写成的项目却持续吸引着开发者的目光。ggml-org/llama.cpp 目前在GitHub上已收获超过13.4万颗星标、2.5万次fork,单日新增star仍有162颗。对于一个底层推理引擎来说,这样的热度并不寻常——它指向一个真实需求:让大模型脱离昂贵的GPU集群,在普通硬件上跑起来。
为什么用C/C++做LLM推理
llama.cpp的核心定位是"LLM inference in C/C++"。选择C/C++而非Python,本身就是一种工程取向的声明。Python生态在模型训练和实验上无可替代,但推理阶段的诉求完全不同:内存占用要小、启动要快、部署要简单、依赖要少。C/C++编译出的原生二进制可以几乎没有运行时依赖地跑在从服务器到树莓派的各类设备上,这在边缘部署和隐私敏感场景中价值明显。
项目背后的ggml张量库同样是自研的纯C实现,避开了对主流深度学习框架的依赖。这种"从底层重写"的路线,使得整个推理栈可控、可裁剪,也为后续的量化优化留出了空间。
GGUF(GPT-Generated Unified Format)是llama.cpp生态当前使用的模型文件格式,取代了早期的GGML格式。它采用键值对元数据加张量数据的结构,把模型架构超参数、分词器配置、量化类型等信息与权重打包在同一个文件中,因此单个文件即可自描述,无需额外配置文件。GGUF还支持内存映射(mmap)加载,让操作系统按需把权重页调入内存,显著缩短大模型的启动时间并降低峰值内存。格式上的可扩展性使社区能较快纳入对新模型架构(如不同注意力变体、MoE结构)的支持,这也是llama.cpp能快速跟进新模型的重要原因之一。
量化:让大模型挤进消费级硬件
llama.cpp广为人知的能力之一是对模型量化的支持。通过把权重从高精度浮点压缩到更低比特的表示,模型体积和内存带宽需求大幅下降,从而让参数规模不小的模型也能在消费级设备上运行。量化并非无损,但项目提供了多种量化档位,使用户可以在精度损失和资源占用之间做取舍。
这一设计直接扩大了大模型的可用边界。对个人开发者而言,意味着不必依赖云端就能做本地实验;对企业而言,则意味着在数据不出内网的前提下完成推理成为可能。
量化本质上是用低位宽整数(如4位、5位、8位)近似表示原本的FP16/BF16浮点权重和激活值。LLM推理是内存带宽密集型任务,模型权重越大,每生成一个token需要搬运的数据越多,因此压缩权重位宽往往能直接提升解码速度并降低显存/内存占用。常见的后训练量化方法包括GPTQ、AWQ以及llama.cpp主推的GGUF格式配合K-quants系列(如Q4_K_M),后者对不同的张量按敏感度分配不同比特数,在同等体积下保留更多精度。实践中,7B级模型量化到4位后通常可压缩至约4GB,使得在16GB内存的笔记本上运行成为可能;而2位或更低档位虽然体积更小,但困惑度上升明显,需谨慎评估。
生态位置:推理引擎而非应用框架
需要区分的是,llama.cpp是推理引擎,不是上层应用框架。它提供模型加载、计算调度和采样等底层能力,开发者在其之上构建聊天、RAG、代码补全等具体应用。这种分层让它能作为一个通用底座存在,被各类前端工具和封装库调用。
从star和fork的量级看,项目已经形成了一个活跃的贡献者社区。2.5万次fork意味着大量开发者在其基础上做二次开发或适配,这也是它能快速跟进新模型架构的重要原因——社区力量分担了适配工作。
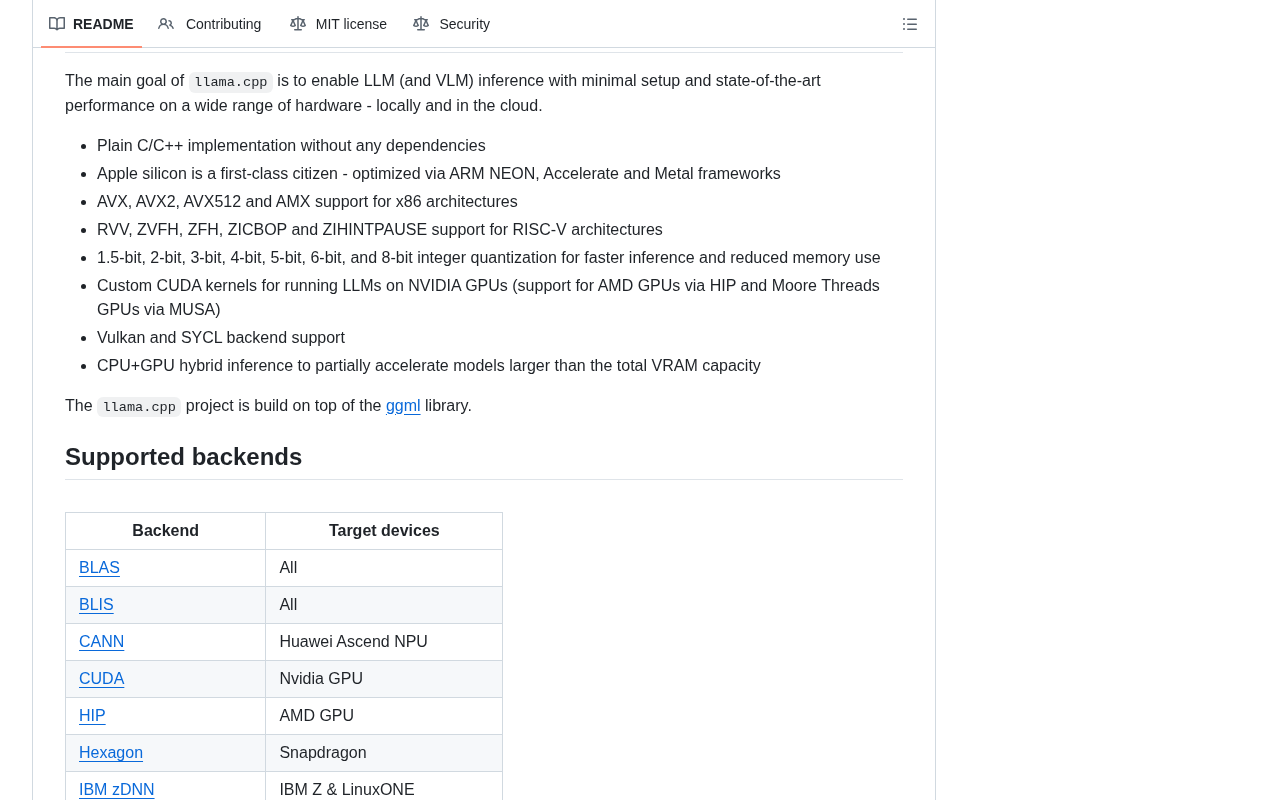
推理后端的选择直接影响llama.cpp的实际性能。项目支持纯CPU推理(利用AVX2、AVX-512、NEON等SIMD指令集),也支持将部分或全部层卸载到GPU执行。GPU后端覆盖CUDA(NVIDIA)、Metal(Apple Silicon)、Vulkan、ROCm/HIP(AMD)等,通过-ngl参数可控制卸载到GPU的层数,实现CPU与GPU的混合调度。对Apple Silicon设备而言,Metal后端配合统一内存架构往往能获得较好的性价比;而在多卡或显存不足的场景下,分层卸载让用户可以在有限硬件上权衡吞吐与延迟。理解这些后端差异是选型与调优的前提。
适用人群与上手建议
llama.cpp更适合对性能和部署有实际要求的开发者,而不是只想快速调API的初学者。上手前需要理解量化档位的含义、硬件后端的选择(CPU、GPU或混合),以及模型格式的转换流程。建议从官方示例入手,先用小模型跑通完整链路,再逐步替换为目标模型并调整量化参数。
对于需要在本地或私有环境部署大模型的团队,这类C/C++推理引擎提供了一个不依赖云服务的可行路径;而对于应用层开发者,理解其能力边界有助于在选型时判断何时该用它、何时该用更高层的封装。
相关推荐

普朗克长度是最小距离吗?物理学家为何存疑
普朗克长度常被称为宇宙最小距离,但科普视频指出这一说法从未被实验证实。本文解析普朗克长度的来源、显微镜思想实验的障碍,以及它真正告诉我们的——量子引力变得不可回避的尺度,而非时空像素。

AI代理驱动支出管理,Payhawk获2.8亿美元融资
Payhawk宣布完成2.8亿美元融资,估值达20亿美元。这家成立于2018年的企业财务管理平台以AI代理追踪和管理费用与采购,本文分析其产品定位演进、估值信号及对企业支出管理赛道的影响。

Snapchat开放AI助手构建AR滤镜:支持Claude Code与Cursor
Snapchat 宣布 Lens 创作者可用自然语言描述 AR 滤镜需求,由 Claude Code、Cursor 等 AI 助手完成从构建到完成的整个开发流程,AR 创作门槛大幅降低。