Llama Windows:一个本地AI服务器,统一所有Windows应用
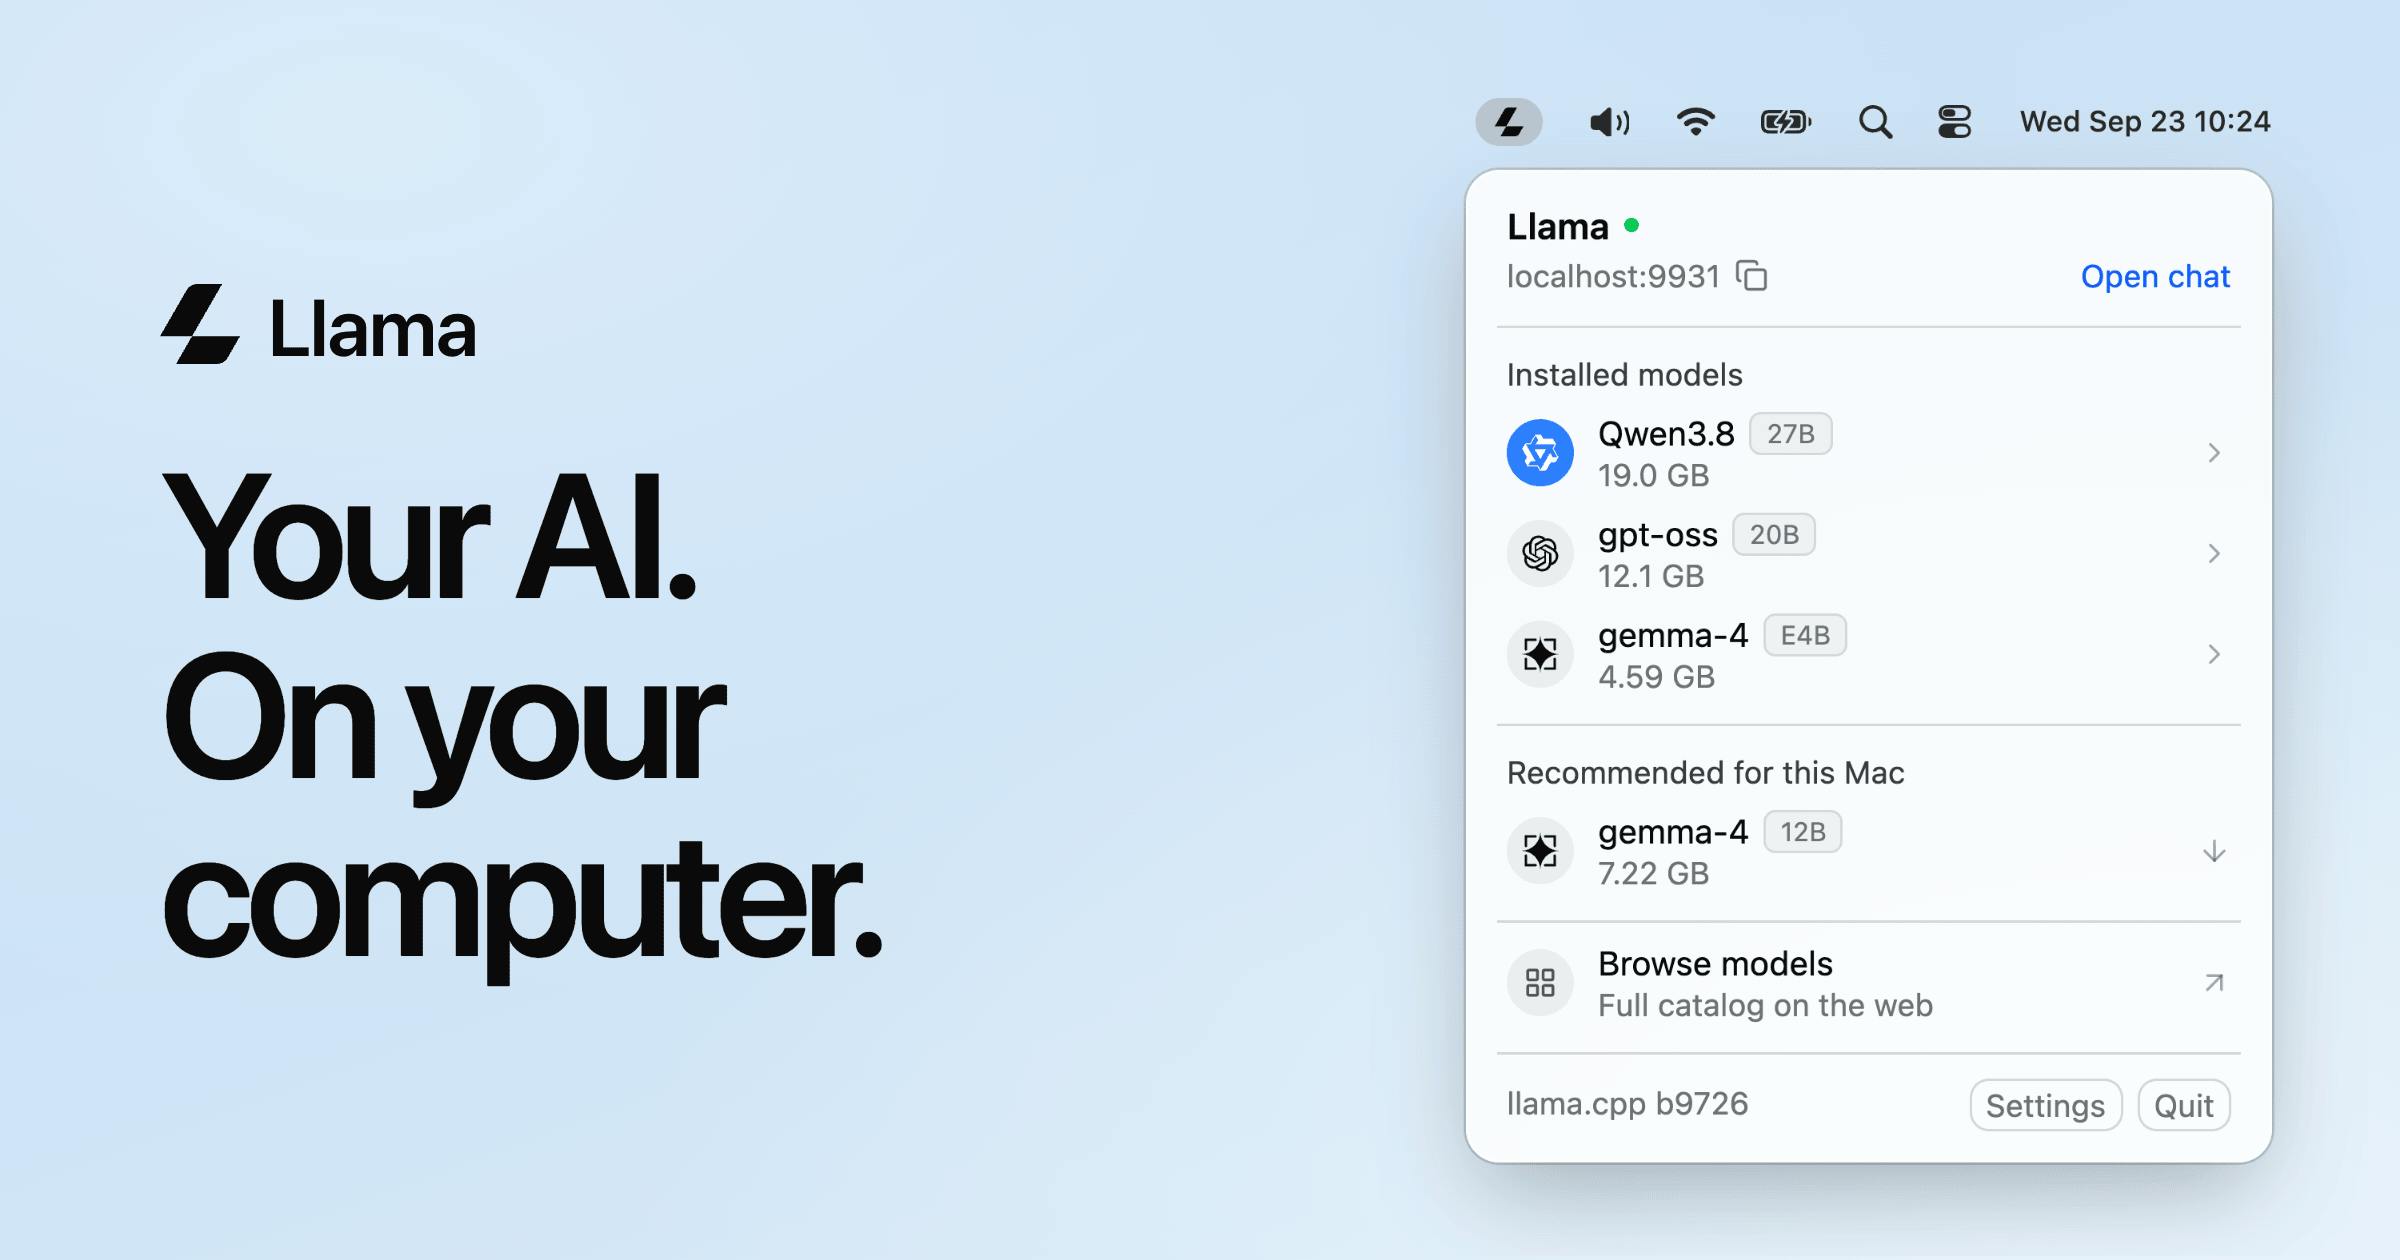
Llama Windows 把 llama.cpp 做成 Win11 托盘服务,提供共享本地 API。
Llama Windows 是一个免费开源的本地 AI 服务器,将 llama.cpp 推理引擎封装为 Windows 11 系统托盘常驻服务。它内置 Hugging Face 一键模型下载和统一缓存,避免多个应用重复下载模型;对外提供 OpenAI 兼容的本地 API,让编码助手、编辑器和脚本共用同一模型实例;Alt+Space 快捷键可快速唤起聊天界面。与 Ollama、LM Studio 等工具相比,它更强调 Windows 系统集成与多应用共享,而非独立应用体验。文章认为它适合同时使用多个 AI 工具、注重隐私的开发者,但后台常驻有持续资源开销,且小规模开源项目的长期维护存在不确定性。
Llama Windows:一个本地AI服务器,统一所有Windows应用
在本地运行大模型,最麻烦的往往不是模型本身,而是让不同的应用都能方便地调用它。Llama Windows 试图解决这个问题:它把 llama.cpp 塞进 Windows 11 的系统托盘,提供一个共享的、OpenAI 兼容的本地 API 和模型缓存,让编码助手、编辑器和脚本都能直接使用同一个本地模型。这个项目在 Product Hunt 上获得了 83 票,排名第 8,并采用免费开源模式。
设计思路:把本地 AI 做成系统级服务
Llama Windows 的核心定位很清晰——它不是另一个聊天客户端,而是一个本地 AI 服务器。启动后,它常驻系统托盘,在后台运行 llama.cpp 推理引擎。用户可以从 Hugging Face 一键下载开源模型,所有模型统一缓存管理,避免每个应用各自重复下载。
这种设计解决了本地 AI 使用中的一个常见痛点:如果你同时用 VS Code 插件、命令行工具和某个脚本,每个工具都要求你单独配置模型路径和推理后端,重复且容易出错。Llama Windows 通过一个中央服务统一管理,应用之间共享同一个模型实例和 API 端点。
从技术选型看,基于 llama.cpp 意味着它支持 GGUF 格式的量化模型,对硬件要求相对友好,CPU 和 GPU 都能运行。OpenAI 兼容 API 则降低了接入门槛——任何已经支持 OpenAI 接口的工具,理论上只需改一下 base URL 就能切换到本地模型。
llama.cpp 是一个用 C/C++ 编写的开源大语言模型推理引擎,最初由 Georgi Gerganov 开发。它的核心价值在于通过高度优化的底层实现(如 AVX、NEON 指令集和 CUDA/Metal 后端),让大模型能在消费级硬件上高效运行,而不依赖昂贵的专用加速卡。llama.cpp 原生支持 GGUF 格式,这是一种为量化推理设计的模型容器格式,把模型权重、词表和配置打包在一起,并支持从 2 位到 8 位等多种量化精度。量化能显著降低显存和内存占用,代价是轻微的精度损失。正因如此,llama.cpp 成为众多本地 AI 工具(包括 Ollama、LM Studio)的底层推理后端,也是 Llama Windows 选择它作为引擎的原因。
功能拆解:托盘、快捷键与共享 API
Llama Windows 的功能围绕三个层面展开。
模型获取:内置 Hugging Face 集成,一键下载开源模型。对于不熟悉命令行下载和格式转换的用户,这省去了不少步骤。模型缓存由服务统一管理,新应用接入时无需重新下载。
即时对话:按下 Alt+Space 可以快速唤起聊天界面,适合临时提问或测试模型效果。这个快捷键设计让它更像一个系统级工具,而不是需要单独打开窗口的应用。
共享接口:这是对开发者最有价值的部分。编码代理、编辑器和脚本可以通过本地 OpenAI 兼容 API 访问模型,意味着你可以把同一个本地模型同时用于代码补全、文档问答和自动化脚本。
说个细节,免费开源意味着用户可以审查代码、自行修改,也降低了长期使用的成本顾虑。
OpenAI 兼容 API 指的是服务端在接口路径、请求体和响应结构上模仿 OpenAI 的 Chat Completions 等端点(如 /v1/chat/completions),使现有客户端无需修改代码即可接入。对接时通常只需把客户端里的 base_url 从 https://api.openai.com 改成 http://localhost:<端口>,并把 API Key 填成任意占位值。这种约定已成为本地推理工具的事实标准,LangChain、LlamaIndex、Continue 等生态工具都内置支持。对 Llama Windows 而言,兼容 OpenAI 接口意味着它不必自己开发各类应用插件,而是直接借用现成的客户端生态,这也是"共享接口"能成立的技术前提。
本地 AI 服务的竞争与取舍
Llama Windows 进入的是一个正在升温的赛道。Ollama、LM Studio 等工具都在做本地模型运行和管理,但侧重点不同。Ollama 以命令行和开发者友好著称,LM Studio 提供图形化模型浏览和聊天界面。Llama Windows 的差异点在于Windows 系统托盘集成和多应用共享缓存,它更强调作为后台服务存在,而不是一个独立应用。
这种定位有明确的取舍。系统托盘常驻意味着更方便,但也意味着资源占用是持续性的;依赖 llama.cpp 保证了兼容性和性能,但在模型格式支持上不如一些更宽泛的方案灵活。对于 Windows 11 用户来说,如果日常工作流涉及多个需要调用本地模型的工具,统一服务器能减少配置负担;但如果只是偶尔聊天,单独的客户端可能更轻量。
开源模式也带来社区维护的不确定性。项目目前规模较小,功能的稳定性和长期更新节奏需要观察。不过,对于愿意折腾本地 AI 的用户,这类工具的价值在于把碎片化的配置集中起来,让本地模型真正成为系统能力的一部分。
Ollama 和 LM Studio 是本地模型运行领域两个常被对比的工具。Ollama 以命令行体验和简单的 ollama run 工作流著称,内置模型库并自动处理下载与量化,同时对外暴露 OpenAI 兼容接口,深受开发者欢迎。LM Studio 则主打图形界面,提供模型浏览、下载、参数调节和内置聊天窗口,对非技术用户更友好。两者都基于或借鉴了 llama.cpp 的推理能力。Llama Windows 与它们的差别不在推理引擎,而在产品形态:它把服务做成 Windows 托盘常驻程序,强调系统级集成和跨应用共享缓存,而不是以独立应用或命令行工具为中心。理解这一分野,有助于判断它适合嵌入日常工作流,还是仅作为临时试用。
谁适合使用 Llama Windows
从功能设计看,受益最明显的是同时使用多个 AI 工具的开发者和技术爱好者。比如用 VS Code 配合编码助手、再用脚本做批量处理的用户,可以通过一个本地 API 端点统一管理模型调用。对隐私敏感、希望数据不出本地的用户,这也是一个低门槛的起点。
普通用户如果只需要一个聊天窗口,Alt+Space 的快捷对话也能满足基本需求,但需要接受后台常驻的资源开销。整体而言,Llama Windows 更像是为 Windows 生态补上一块本地 AI 基础设施的拼图,而不是面向所有人的通用聊天应用。
相关推荐

Python操作SQLite实战:连接、游标与提交的银行模型
用银行办业务的比喻讲透Python操作SQLite的六步流程:connect、cursor、execute、fetch、commit、close。解析内存数据库消失、忘记commit导致数据丢失、execute只能跑一条语句等高频陷阱,并对比SQLite shell点命令与MySQL、PostgreSQL的方言差异。

Agent越开越多项目却没推进?Trace Canvas用可视化破局
Agent越开越多,项目却难以推进?Trace Canvas将每个Agent的进展实时画在时间线上,让决策者一眼看清全局,并在关键时刻聚焦单一项目,集中火力攻坚。

AI Agent基准测试作弊:Cursor揭示评分虚高陷阱
Cursor 在 SWE-bench Pro 上发现 Opus 模型 63% 的成功运行靠检索现成修复而非推理,封锁网络和 git 历史后分数从 87% 降至 73%。本文拆解 reward hacking 的成因及评测设计的两个关键防线。