LlamaExtract Agentic Plus:面向复杂文档的智能抽取引擎

LlamaIndex发布复杂文档抽取引擎LlamaExtract Agentic Plus,主打长表格处理、校准置信度与可溯源抽取。
LlamaIndex 推出 LlamaExtract Agentic Plus,定位为企业级复杂文档抽取引擎,重点解决发票、合同、财报等场景中跨页长表格与巨型表单的结构化抽取难题。产品的两项核心差异化能力是:校准置信度评分(使置信度分数与实际准确率真正对应,支持按阈值分流人工复核)和可溯源抽取(抽取结果可精确回溯到原文位置,满足合规审计需求)。该产品属于 LlamaCloud 产品线,与文档解析工具 LlamaParse 形成「解析—抽取」两阶段管线。目前相关信息主要来自官方宣传,缺乏第三方独立评测,「全球最先进」属于厂商自我声明,有实际需求的团队仍需以自有数据进行 POC 验证。
LlamaCloud 发力复杂文档抽取
文档抽取(Document Extraction)一直是企业级 AI 应用落地的关键卡点。发票、合同、财报、保险表单这类结构复杂的文件,往往包含跨页长表格、密集字段和非标准排版,传统 OCR 与规则引擎在这些场景下频频失效。LlamaIndex 团队近期在 Twitter 上宣布,推出被其称为「全球最先进」的复杂文档抽取引擎——LlamaExtract Agentic Plus。
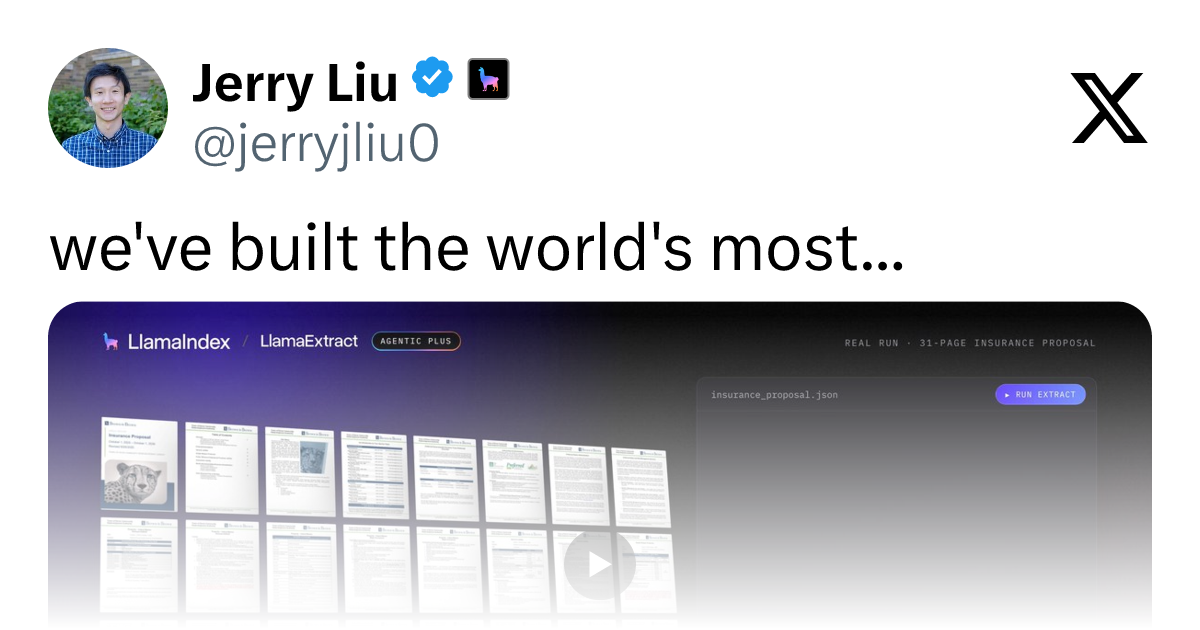
据官方描述,该产品的演示视频展示了引擎在处理长表格、超大表单等场景中的实际表现,并强调了两项区别于常规方案的能力:校准过的置信度评分(calibrated confidence scores)与基于原文的可溯源抽取(grounded extraction)。
核心能力拆解
长表格与巨型表单处理
复杂文档的难点在于结构的不规则性。跨越多页的长表格、字段众多的大型表单,容易导致抽取时上下文断裂、字段错位。LlamaExtract Agentic Plus 主打对这类「长而复杂」内容的稳定解析能力,这也是官方演示中重点呈现的场景。
对于需要从财报、法律合同或医疗表单中提取结构化数据的团队而言,能否完整、准确地还原表格与表单关系,直接决定了后续数据可用性。
校准置信度评分
「calibrated confidence scores」是这次发布中值得关注的设计。多数抽取工具会给出一个字段级的置信度,但这些分数往往未经校准——即分数高低与实际正确率并不对应。校准后的置信度意味着,当系统给出 0.9 的分数时,其正确概率应接近 90%。
这一特性对生产环境尤为重要:它让人工复核可以按置信度阈值分流,低置信字段交由人工审核,高置信字段自动通过,从而在准确率与效率之间取得平衡。
置信度校准(Confidence Calibration)在统计学与机器学习领域有严格定义,通常通过可靠性图(Reliability Diagram)和期望校准误差(ECE,Expected Calibration Error)来度量。未校准模型的常见表现是「过度自信」——即给出 0.95 的置信度,但实际准确率只有 0.75。校准方法包括 Platt Scaling、Temperature Scaling 等后处理技术,通过在验证集上拟合额外参数来修正原始输出的概率分布。对于文档抽取场景,校准难度更高,因为不同文档类型、字体、排版的分布差异极大,单一校准参数往往无法覆盖所有子场景。因此 LlamaExtract 所宣称的「校准置信度」是否在跨域场景下仍然有效,是评估时需要重点验证的指标。
可溯源抽取(Grounded Extraction)
Grounded extraction 强调抽取结果能够回溯到原文的具体位置。这既是可解释性的体现,也是合规与审计场景的刚需。当抽取结果可以精确定位到源文档中的对应片段时,用户能够快速验证、纠错,减少「幻觉式」输出带来的风险。
「Grounded」在大模型领域通常指输出内容有明确的来源依据,与「幻觉(Hallucination)」相对。在文档抽取语境下,Grounded Extraction 意味着每个抽取字段都附带原文中的精确位置信息,如页码、坐标或文本 span。这一能力的实现通常依赖两类技术路径:一是视觉语言模型(VLM)直接在文档图像上做区域定位,二是在文本抽取后通过字符串匹配或向量检索将结果锚定回原文。前者定位更精准但计算代价更高,后者在 OCR 质量不稳定时容易出现锚定偏移。对于金融、法律、医疗等高合规要求行业,溯源能力是满足审计留痕要求的必要条件,而非可选功能。
面向的用户与场景
LlamaIndex 在推文中直接点名目标用户:「如果你有复杂文档抽取需求,而现有供应商无法满足」。这一表态清晰地把产品定位在企业级、高难度抽取市场,与通用 OCR 或轻量级解析工具形成区隔。
LlamaExtract 属于 LlamaCloud 产品线的一部分,与 LlamaParse(文档解析)形成互补:LlamaParse 负责将复杂文档转化为可处理的结构化中间表示,LlamaExtract 则在此基础上执行字段级的智能抽取。官方在推文中同时引导用户注册 LlamaParse,显示出其构建完整文档处理管线的意图。
LlamaParse 与 LlamaExtract 的分工体现了「解析—抽取」两阶段管线的架构思路。LlamaParse 的核心工作是将 PDF、扫描件等非结构化文件转换为 Markdown 或 JSON 等中间格式,处理难点集中在版面分析(Layout Analysis)和表格重建;LlamaExtract 则在结构化中间表示之上,按照用户定义的 Schema 执行字段级抽取,类似于在已解析文档上运行的「信息提取引擎」。这种分层设计的优势在于模块可替换——用户可以用其他解析器替换 LlamaParse,只要输出格式兼容即可接入 LlamaExtract。不过两层级联也意味着错误会累积:解析阶段的表格重建错误会直接传导到抽取结果,使得端到端准确率低于各单模块的独立表现。
简要点评
从公开信息看,这次发布延续了 LlamaIndex 从「检索增强生成(RAG)框架」向「文档处理基础设施」延伸的路线。置信度校准与可溯源抽取这两个卖点,恰好击中了企业在落地文档 AI 时最担心的准确性与可审计性问题。
不过需要说明的是,目前可参考的信息主要来自官方推文与演示视频,缺乏第三方基准测试与独立评测数据。「全球最先进」这类表述属于厂商自我宣称,实际效果仍需在真实业务数据上验证。对于有复杂抽取需求的团队,建议以自有文档样本进行 POC 测试,重点关注长表格还原度、置信度分数的实际校准情况以及溯源定位的准确性。
相关推荐

韩国曝AI智能体疑似被用于攻击银行系统
韩国监管机构警告称,AI智能体疑似被用于攻击该国银行系统。本文分析AI驱动网络攻击的危险性、金融机构面临的新挑战及行业应对方向。

Claude Code创建者为何建议删除配置?上下文工程四大转变解析
Claude Code创建者Boris Cherny建议定期删除配置引发热议。本文拆解这句话的真正含义,解析上下文工程的四大转变:规则改判断标准、示例改接口、前置加载改渐进式披露、善用自动记忆与默认验证,帮你让AI配置与模型迭代并行。

推翻萨达姆只是开始:历史学家沙拉·佩恩拆解伊拉克困局
历史学家沙拉·佩恩深度解析伊拉克战争:推翻萨达姆容易,稳定难。从有限目标vs无限目标、马赛克社会、2000英里边境到邻国干预,拆解政权更迭的战略陷阱。