Claude Code创建者为何建议删除配置?上下文工程四大转变解析

Boris Cherny「删除配置」建议的真正含义:移除过度约束,用四大转变重塑与Claude的协作方式。
Claude Code 创始人 Boris Cherny 建议定期删除 CLAUDE.md 等配置,但本文指出大多数人误读了他的意图。他真正想说的是:先清空再根据模型实际表现逐步补充,以识别哪些配置是真正必要的。深层原因是 Anthropic 发现 Claude Code 被过度约束,而非模型能力不足。基于此,文章提出四大上下文工程转变:将刚性规则改为灵活判断标准、用接口替代固定示例、采用渐进式披露按需加载上下文、利用模型已内置的自动记忆与默认验证能力。这些转变的核心逻辑是:从「你指导模型」转向「你分享你的世界信息」,保留特定情境知识,移除限制性规则,让开 Claude 的路与它一起构建。
Claude Code的创建者Boris Cherny因为一句建议而在开发者社区引发热议:使用Claude Code时,每隔一段时间删掉你的CLAUDE.md文件、删掉你的技能(skills)、删掉你的钩子(hooks),看看模型能做什么。这句话听起来相当激进——你辛辛苦苦积累的配置,难道要全部扔掉?
但讨论这个话题的大多数人其实没有理解他真正想表达的意思。本文将拆解Boris究竟说了什么、他为什么这么说,以及这对普通使用者意味着什么,最后给出一套可操作的上下文工程优化原则。
Boris到底说了什么
Boris的原话是在被问到「人们是否应该删除一切」时给出的回答。他的建议分为两步:第一步是删除,第二步是使用。
关键在于他对删除的后半句解释:「因为你可能无法准确预测模型需要哪些指令,所以不要靠猜。只有当你看到模型反复在同一件事上卡住时,才是你把它加回来的时候。」
换句话说,Boris真正想传达的不是「盲目删除」,而是「实验你的配置」——先清空,再根据模型的实际表现逐步加回必要的约束。这是一种实验驱动的配置管理思路,而不是一刀切的清空。
不过需要警惕的是,如果真的开始盲目删除东西,长远来看对你并没有好处。Boris本人也不真的相信应该删掉所有东西。
CLAUDE.md 是 Claude Code 的核心配置文件,存放于项目根目录,每次对话启动时会被自动加载进上下文窗口。它相当于给模型的「永久系统提示词」,开发者在这里写入项目规范、编码风格、禁止行为等约束。技能(skills)是可复用的任务模板,钩子(hooks)则是在特定触发条件下自动执行的脚本或动作。这三者共同构成了 Claude Code 的「上下文工程基础设施」——设置得好能大幅减少重复指令,设置得过细则可能把模型约束进一个比实际需要更窄的行为框架,导致它在明明可以灵活处理的场景下仍机械遵守过时规则。
为什么他要你删除配置
这段话走红,部分原因是Anthropic当时发布了新模型。深入阅读Anthropic团队关于模型变化如何影响实际工作的文章后,事情比「删除一切」要复杂得多。
问题的核心可以归结为一句话:Anthropic发现他们过度约束了Claude Code——无论是通过系统提示词,还是通过CLAUDE.md文件和技能。
删除确实能解决「过度约束」的问题,因为没有约束就不存在过度约束。但删除同时也会带走你所有的行业知识、既定的文档化解决方案,而且无法阻止模型反复犯同样的错误。
因此更准确的说法应该是:删除所有过度约束Claude的部分,而不是删除一切。这个版本一旦理解,Boris的建议就合理多了。而值得注意的背景是,Boris面对的是有闲暇做实验、处于极技术领域的初创公司工程师,对于非技术背景的使用者,直接照搬这种方法帮助有限。
上下文工程的四大转变
与其删除一切,更稳妥的做法是调整未来使用Claude的方式。在动手之前,务必先保存现有系统:技术型用户把项目推送到GitHub,非技术用户则可以用一段提示词让Claude Code把整个设置复制到一个带日期的文件夹里并说明如何恢复。消除「删除焦虑」之后,才能更自由地进行以下四个转变。
转变一:把「规则」改为「判断标准」
规则是「永远不要做X」,判断标准则是「匹配周围的环境」。规则会以一个可能不适用于所有情况的方向去约束Claude,容易产生矛盾。
Anthropic举的例子是:你可能在一处写着「默认不写注释,最多一行」,另一处又写「写清晰详尽的注释」,这种矛盾导致结果不一致,Claude也比必要的工作更努力。
替代做法是给方向而非规定:「写读起来像周围注释的注释,匹配密度、命名约定和风格」。同理,与其规定「总是输出CSV」,不如说「以项目批准的格式生成报告」。
转变二:将「示例」改为「接口」
以前的建议是提供确切的示例供Claude参考,但这会限制模型可以思考的领域。比如你告诉AI「这是三份报告供参考」,它就会被限制在那个结构里。
接口只是「指南」的另一种说法——告诉AI需要什么以及约束是什么,而不规定具体形态。例如「查看过去一个月的数据,创建一份帮助我们确定绩效的报告」。
经验法则是:你想让AI当工厂工人还是创意者? 当它是创意者时,示例会伤害它,倾向用接口;当它只需产出标准化结果时,示例仍然有用。
「接口」(interface)在这里借用了软件工程的概念:接口只声明「需要什么输入、产出什么输出、有哪些约束」,而不规定内部实现。对应到提示词工程,就是描述任务的目标、边界条件和验收标准,而非给出具体的输出样本。这种做法之所以对创意型任务更有效,根源在于大模型的「锚定效应」:当上下文中存在具体示例时,模型会将其作为强先验,后续生成会向示例的结构、风格和长度靠拢,即使任务实际上需要不同的解法。接口式指令则避免了这种隐性锚定,让模型在更大的解空间中搜索最优方案。当然,对于需要格式严格统一的场景(如数据提取、表单填写),示例反而是最高效的约束方式,两种策略并不互斥。
转变三:从「前置加载」改为「渐进式披露」
渐进式披露的意思是只在真正需要时才加载上下文。CLAUDE.md文件里的内容每次都会被加载,所以不要把大段内容直接塞进去,而是指引到上下文所在的位置,让Claude自行决定何时加载。
比如不要写「这是我的写作风格」后面跟一大段,而是写「这是我的写作风格指南」加一个文件路径。技能同理,都应该是轻量级的上下文负担,详细内容存储在参考文件中。这一条没有什么微妙之处,直接执行即可。
渐进式披露(Progressive Disclosure)源自 UX 设计领域,原意是界面只在用户需要时才展示更多选项,以降低认知负担。移植到上下文工程后,逻辑相同:LLM 的上下文窗口是有限且有成本的资源,一次性把所有背景塞入不仅浪费 token,还会稀释真正关键信息的权重。研究者将这种现象称为「上下文污染」——当无关信息占据窗口,模型在检索关键约束时注意力会被分散,输出质量下降。用文件路径替代内联内容,本质上是把「检索决策权」交还给模型:它会在判断确实需要某段知识时才去读取,而不是被动接受所有预加载信息。这也是为什么 CLAUDE.md 应该保持轻量,充当索引而非百科全书。
转变四:利用自动记忆与默认验证
新版Claude会自动把信息存储在记忆文件中。以前你必须主动提醒Claude保存信息,现在它默认这样做——在终端输入Memory就能看到设置和记忆文件夹。当然,你仍然可以明确要求它记住某事。
更大的变化是模型现在默认验证输出。过去需要在CLAUDE.md里写「发送前验证你的响应」,但现在模型会自动尝试验证。如果你还保留验证规则,可能导致双重验证,浪费时间和成本。识别验证方式仍然重要,但你需要的是指导它「如何」验证特定输出,而不是再写一条通用的验证指令。
四大转变背后的统一模式
回顾这四个转变,有一个清晰的模式:
- 转变之前的所有版本,都是「你指导模型,因为它还不够好」;
- 转变之后的所有版本,都是「你分享关于你的世界和偏好的信息」。
这正是Boris建议的本质。目标不是删除你的技能,而是删除所有过度约束Claude的部分。但有意的边界绝不能删——如果你的世界里存在禁区或固定要求,那是事实,你应该继续与Claude分享。
如何验证改动是否有效
如果想测试效果,可以挑一件Claude今天总是搞不对的任务,先用Claude Safe Mode在不加载任何上下文的情况下运行,作为基线(相当于Boris说的「删除一切」状态),再分别用归档的旧项目和经过四大转变优化的新项目执行同样任务,交叉比较结果。
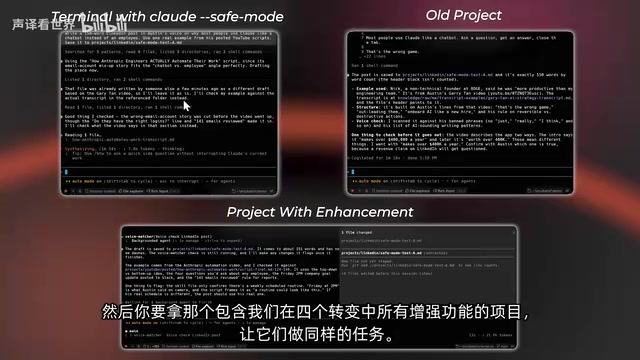
不过对于非技术任务,这种比较带有主观性,很难做出精确判断。更现实的态度是:这些转变都是战略性的最佳实践,方向正确即可,不必执着于量化每一点改进——反正没有很好的衡量方法。核心原则只有一条:保留所有特定于你情况的信息,移除限制性规则。
让系统与AI并行,而非竞争
面对模型快速迭代,很多人会焦虑:每次模型更新,我是不是都要改一遍配置?答案是——设置你的系统,使其与AI并行,而不是与它竞争。
你提供的上下文、技能、指导,不应该试图限制模型,而应该给它那些它永远无法自行知道的、关于你具体情况的超具体知识,然后放手让它发挥。如果没把握,可以运行Claude Doctor分析并清理你的设置。
Boris说「删除一切」,真正的意思是:让开Claude的路,与它一起构建。 即使有了正确的指导,负担也会转移到系统所引用的上下文上——那部分永远不会消失,而这恰恰是人类持续创造价值的地方。
相关推荐

Cursor AI编程工具保姆级教程:下载、模式与模型选择全解析
Cursor AI编程工具保姆级教程:从下载安装、界面布局到Agent/Ask/Manual三种模式解析,以及GPT、Claude大模型选择建议,帮你快速上手这款强大的AI代码编辑器。

Cursor Projects深度解读:云端代理会终结Claude Code吗
Cursor Projects通过云端代理解决上下文衰减问题,支持多代理并行、完整开发闭环和真实软件交付。本文解读其工作机制、实测观察,并分析它能否真正挑战Claude Code与ChatGPT Codex。

Cursor创始人深度对话:代码之死与"品味"的崛起
Cursor创始人Michael Truell深度对话:解析AI编程的真实瓶颈、"vibe coding"为何在专业开发中行不通,以及为什么"品味"将成为未来工程师唯一不可替代的能力。附AnySphere从CAD到90亿估值的创业历程。