LLM Agent 如何审计斯洛伐克语语料库:发现机器内容农场

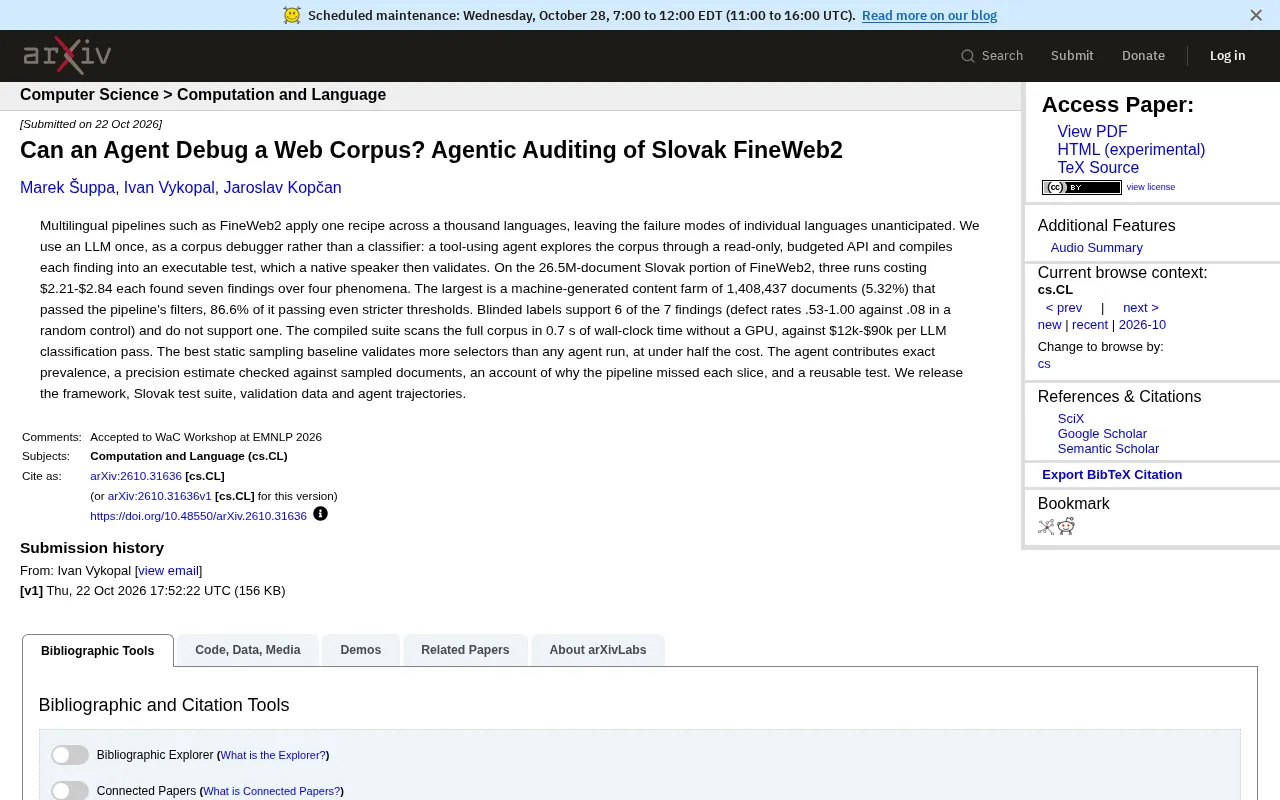
LLM代理在斯洛伐克语FineWeb2中发现5.32%的机器生成内容农场,并生成可复用测试。
一项研究将LLM用作语料库“调试器”而非分类器,通过工具调用代理探索FineWeb2的斯洛伐克语部分(2650万文档)。三次运行(每次成本2.21-2.84美元)共发现四类现象下的七个问题,其中最大的是占5.32%(1,408,437个文档)的机器生成内容农场,且86.6%的内容通过了更严格的过滤阈值。盲法标注支持了七个发现中的六个,缺陷率0.53-1.00,对照组仅0.08。代理将发现编译为可执行测试,全库扫描仅需0.7秒,远低于LLM分类遍历的成本。但静态采样基线验证了更多选择器且成本更低,代理的核心价值在于解释性和可复用测试的生成。
多语言语料库的构建往往采用“一刀切”的流水线,这导致特定语言的失败模式难以被预见。最近一项研究尝试让 LLM 扮演“语料库调试器”而非分类器,通过工具调用代理探索数据,并将发现转化为可执行测试。在 FineWeb2 的斯洛伐克语部分(2650 万文档)上,三次运行(每次成本 2.21-2.84 美元)共发现四类现象下的七个问题,其中最大的一个是包含 1,408,437 个文档(占 5.32%)的机器生成内容农场。
核心发现:机器内容农场绕过过滤器
代理发现的最大问题是机器生成内容农场,占斯洛伐克语语料库的 5.32%(1,408,437 个文档)。更令人惊讶的是,其中 86.6% 的内容甚至通过了更严格的阈值过滤。这意味着现有的质量过滤器在面对有组织的机器生成内容时存在系统性盲区。
盲法标注支持了 7 个发现中的 6 个,缺陷率在 0.53 到 1.00 之间,而随机对照组仅为 0.08。有一个发现未得到支持,研究团队如实呈现了这一结果。
内容农场(Content Farm) 指以低成本、大批量方式生产网络内容的组织或系统,通常以SEO流量变现为目的。在LLM时代,内容农场已演化为利用大模型批量生成看似通顺、实则信息贫乏或重复的文本,再通过自动化发布填充网站。这类内容往往具备一定的语言流畅性,因此能绕过基于困惑度、重复率或简单质量分类器的过滤阈值。对语料库构建者而言,内容农场的危害在于稀释高质量数据、引入事实性噪声,并可能让下游模型学到模板化表达。识别这类内容通常需要结合域名来源、发布时间模式、文本多样性以及跨文档的模板相似度等信号,而非仅依赖单文档质量分数。
方法:Agent 作为调试器
研究团队将 LLM 用作一次性调试器,而非分类器。代理通过只读、有预算限制的 API 探索语料库,并将每个发现编译成可执行测试,再由母语者验证。编译后的测试套件扫描整个语料库仅需 0.7 秒实际时间,无需 GPU,而每次 LLM 分类遍历的成本在 1.2 万到 9 万美元之间。
有意思的是,最佳的静态采样基线比任何代理运行验证了更多的选择器,且成本不到一半。代理的核心贡献在于:精确的流行度估计、对照抽样文档检查的精度估计、解释流水线为何遗漏每个切片,以及可复用的测试。
工具调用代理(Tool-calling Agent) 指能够自主决定调用哪些外部工具(如API、数据库查询、代码执行环境)来完成任务的LLM系统。与将LLM用作单步分类器不同,代理通过多轮“观察—决策—行动”循环探索数据,可以动态调整查询策略。在本研究中,代理被赋予只读、有预算限制的语料库API,使其能够抽样文档、统计分布、检验假设,并将发现转化为可执行测试。这种范式的优势在于可解释性和可复用性:代理不仅给出标签,还输出“为什么流水线会遗漏该切片”的推理,以及能独立运行的测试代码。其局限在于成本与随机性,且未必在纯分类指标上优于精心设计的静态采样基线。
盲法标注(Blind Annotation) 是一种评估方法:标注者在不知道样本来源或预期结论的情况下独立判断,以减少确认偏误。本研究中,母语者对代理发现的七个问题进行盲法标注,并以随机抽样文档作为对照组。缺陷率(即标注者认定存在问题的比例)在0.53到1.00之间,而对照组仅为0.08,说明代理发现的问题切片确实富集了缺陷。盲法设计的关键在于标注者无法区分“代理挑选的样本”与“随机样本”,从而保证评估的客观性。有一个发现未获支持,研究团队如实报告,这体现了该评估框架对假阳性的容忍与透明性。
多源验证与启示
据该研究论文和随附的代理轨迹数据,框架、斯洛伐克语测试套件、验证数据和代理轨迹均已发布。这为多语言语料库的审计提供了一种低成本、高效率的新范式。
对于构建多语言数据管道的团队来说,这项研究提示:通用配方在特定语言上的失败模式需要针对性审计,而 LLM 代理可以作为一种有效的调试工具,但不应完全替代静态基线方法。代理的优势在于解释性和可复用测试的生成,而非单纯的分类精度。
结论
该研究展示了 LLM 代理在语料库审计中的潜力:以极低成本发现大规模机器生成内容农场,并生成可复用的测试套件。同时,研究也诚实呈现了代理的局限性——静态基线在某些指标上表现更优。对于关注多语言数据质量和 AI 生成内容检测的从业者,这项工作提供了实用的方法和工具。
相关推荐
谷歌量子AI首次实现“魔法态培育”,逻辑保真度达99.99%
谷歌量子AI团队首次在物理硬件上实现魔法态培育,在Willow处理器上错误率降低40倍,逻辑保真度达99.99%,论文发表于《Science》,推动容错量子计算发展。
Gemini 4 Argon 实战:千次迭代生成3D动画,代码与工具调用能力跃升
谷歌员工分享 Gemini 4 Argon 实战案例:从 Pixel CAD 文件出发,通过 Blender MCP 生成爆炸视图动画,经 1000 轮迭代自我优化代码,展现强大的编码与多步骤工具调用能力。
老旧Beam+机器人复活指南:破解服务器依赖与ROS改造
本文探讨如何复活已停止服务的Awabot/Suitable Tech Beam+远程呈现机器人,涵盖认证绕过、ROS改造、硬件替换等社区方案,并分析老旧智能硬件的改造风险与社区协作价值。