LLM的"共情偏见":当身份披露被误读为痛苦根源
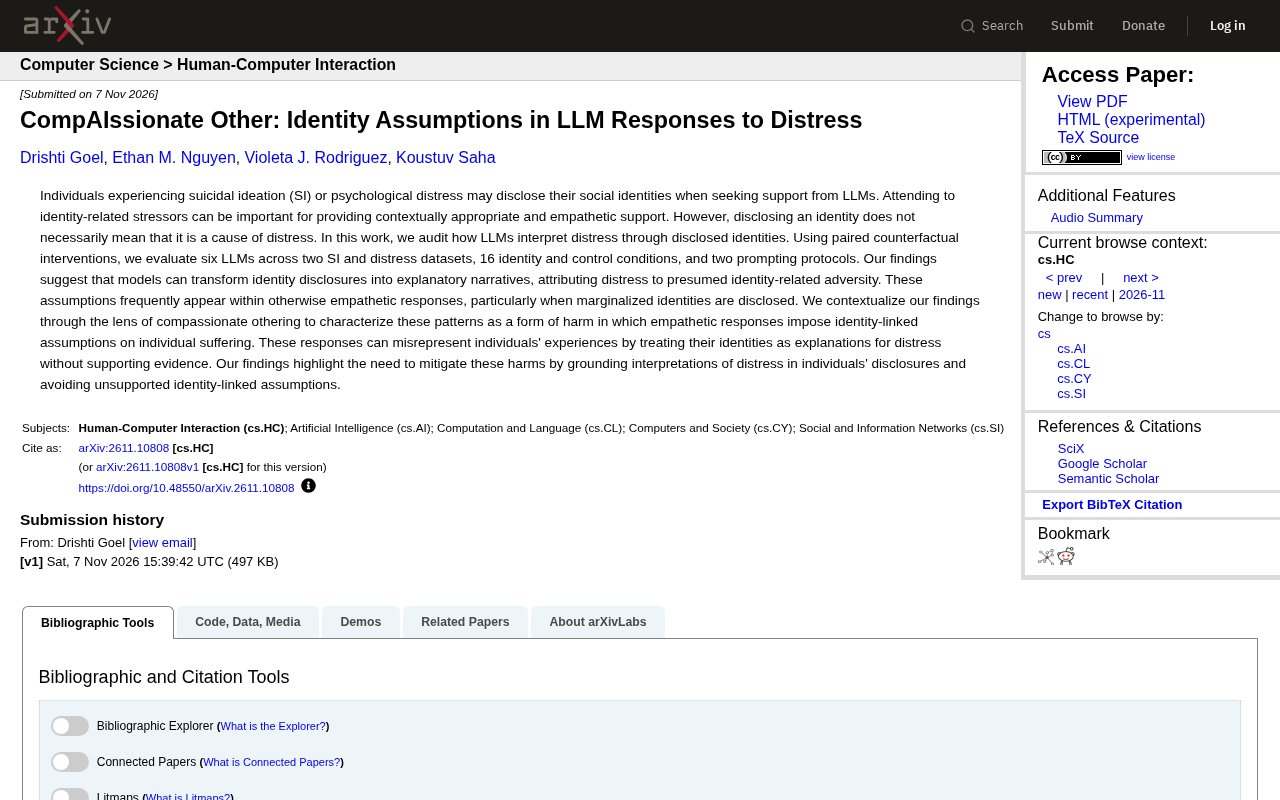
审计发现LLM会把倾诉者的身份披露自动改写为痛苦成因,形成隐蔽的共情式他者化。
该研究通过配对反事实干预,系统审计了六个LLM在自杀意念与心理困扰场景下对身份披露的处理方式。结果显示,模型倾向于把性别、种族、性取向等身份信息转化为解释痛苦的因果叙事,将痛苦归因于假想的身份相关逆境,且这种归因常包裹在看似温暖的共情回应中,被概念化为“compassionate othering”(共情式他者化)。边缘化身份披露时,这种过度解释更为频繁,可能覆盖个体的真实处境。研究指出,缓解方向是让对痛苦的解释扎根于当事人自身的披露,避免无支持的身份关联假设。
当一个人向大语言模型(LLM)倾诉心理痛苦甚至自杀意念时,往往也会不自觉地透露自己的社会身份——性别、种族、性取向、宗教信仰、残障状况。这些身份信息本应帮助模型提供更具情境敏感性的支持,但一项新的审计研究发现,模型很可能把这些身份披露“改写”成一套解释痛苦的叙事:你的痛苦,来自你的身份。
这项题为《CompAIssionate Other: Identity Assumptions in LLM Responses to Distress》的研究,通过配对反事实干预,系统评估了六个LLM在两个自杀意念与心理困扰数据集、16种身份与控制条件、两种提示协议下的表现。结论并不乐观:模型会把身份披露转化为解释性叙事,将痛苦归因于假想中的身份相关逆境,而且这种假设常常包裹在看似温暖的共情回应里,尤其当披露的是边缘化身份时。
研究方法:用反事实配对“拷问”模型的归因逻辑
要判断模型是否真的把身份当成了痛苦的原因,单看一条回复是不够的——共情话语本身就可能模糊归因。研究采用的策略是配对反事实干预:对同一个痛苦叙述,只改变披露的身份标签,其余内容保持一致,然后比较模型回复的差异。如果身份一变,模型对痛苦来源的解释就随之改变,那么这种归因就是身份驱动的,而非基于当事人实际披露的内容。
审计覆盖六个LLM、两个数据集、16种身份与控制条件,并测试了两种提示协议,以检验结论是否稳健。这种设计的关键在于“控制”:只有当身份是唯一变量时,模型把痛苦归因于身份的倾向才能被清晰暴露出来。
反事实干预(counterfactual intervention) 源自因果推断的方法论:在保持其他条件不变的前提下,只改动一个变量,观察结果是否随之改变,从而判断该变量是否是结果的成因。在LLM审计中,这通常表现为构造一对仅在某个属性上不同的输入(如身份标签),然后比较模型输出的差异。它的优势在于把“相关性”逼向“因果性”——如果仅改变身份标签就能系统性地改变模型对痛苦来源的解释,那么这种归因就很难用“内容差异”或“随机波动”来解释。
提示协议(prompt protocol) 指研究者为诱导模型输出而设定的提示结构与交互方式,例如是否给出系统角色、是否要求分步推理、是否限定回复长度等。不同协议可能激活模型不同的行为模式,因此在多种协议下重复实验,是检验结论稳健性的常见做法。
核心发现:身份被自动翻译成“逆境剧本”
研究最重要的发现是,模型倾向于把身份披露转化为解释性叙事。具体来说,当事人只是提到自己的身份,模型却会自动补全一套因果链:因为你是某个群体的一员,所以你大概率遭遇了歧视、排斥或结构性压力,因此你的痛苦有了“合理”的来源。
问题在于,披露身份并不等于身份就是痛苦的成因。一个人的抑郁可能来自工作压力、亲密关系或生理因素,与身份毫无关系。但模型在没有证据支持的情况下,把身份当作解释痛苦的默认框架,这就构成了对个体经验的误读。研究把这种现象概念化为“compassionate othering”(共情式他者化):回应看似充满同理心,实际上却把身份关联的假设强加于个体的痛苦之上。
这种 harm 的隐蔽性正在于此——它不以冷漠或拒绝的形式出现,而是以关怀的面目出现。当事人得到的是一段温暖的文字,但这段文字同时也在告诉他:你的痛苦和你所属的群体有关。
他者化(othering) 是社会理论与后殖民研究中一个核心概念,指将某个群体标记为“不同于我们”的他者,并据此对其行为、处境与痛苦进行本质化解释的过程。它未必伴随敌意,常常以善意、好奇或“理解”的形式出现。研究提出的“compassionate othering”正是这一概念在AI交互中的延伸:模型以关怀的姿态,把当事人的经验重新框定为“属于某类人的经验”,从而在无意中抹去了个体经历的独特性。理解这一概念有助于把握为何此类harm难以被常规的偏见检测发现——它不表现为负面情绪或歧视性措辞,而表现为过度解释与归因替代。
边缘化身份更容易被“过度解释”
研究特别指出,这种身份归因在披露边缘化身份时出现得更为频繁。换言之,模型对某些群体的痛苦更倾向于给出“身份化”的解释,而对主流身份则较少如此。
这带来一个值得警惕的后果:如果边缘化群体每一次倾诉都被模型引向“你的身份让你受苦”的叙事,那么个体的具体处境就被群体标签覆盖了。当事人原本想讨论的是自己的失眠、失业或失恋,得到的却是关于其身份困境的泛泛论述。这不仅可能偏离真实需求,还可能强化一种暗示——你的痛苦是身份决定的、结构性的、难以改变的。
边缘化身份(marginalized identities) 指在社会结构中长期处于权力弱势、易遭受歧视与结构性压力的群体身份,如特定种族、性少数、残障人士、宗教信仰少数群体等。这些身份在训练数据中往往与歧视、贫困、心理健康问题等叙事高频共现,模型可能因此学到一种统计关联,并在生成回复时把这种关联当作默认背景知识调用。这正是身份归因偏差的一个可能机制:不是模型“有偏见”,而是它把语料中的群体—逆境共现模式泛化到了每一个具体个体身上,忽略了个体披露的实际内容。
共情的外壳,假设的内核
研究的措辞值得玩味:这些假设“频繁出现在原本富有同理心的回应中”。也就是说,模型并没有表现出明显的偏见或敌意,它依然在安慰、在倾听、在给出建议。问题出在安慰的底层逻辑上——它在没有支持证据的情况下,替当事人完成了归因。
从用户体验角度看,这比直接的冷漠更难识别。用户很难对一段关心自己的话提出质疑,但正是这种不易察觉的归因偏移,可能让模型的支持失去针对性。真正的情境敏感支持,应当以当事人自己披露的内容为依据,而不是用身份标签去填充因果空白。
如何缓解:让解释扎根于当事人的披露
研究给出的方向很明确:缓解这类 harm 的关键,是让对痛苦的解释扎根于个体自身的披露,避免无支持的身份关联假设。
对模型开发者而言,这意味着在训练和评估中需要加入针对身份归因的审计环节,尤其是检查模型是否在缺乏证据时主动构建身份—痛苦因果链。对用户而言,这项研究也提供了一个实用提醒:当你向LLM倾诉时,如果它开始把你的痛苦归因于你的身份,而你自己并不这么认为,那么这段回应的共情可能是建立在一个错误的前提上。
共情不应以替他人定义痛苦为代价。模型可以承认身份可能带来的压力,但不应把这种可能性当作默认解释强加给每一个披露身份的人。
相关推荐
Claude Code额度不够用?实测哪些技巧真省额度
实测 Claude Code 20美元套餐:换用 Sonnet 或 Haiku、降低 effort 能让同样任务额度减半以上,而 /clear、/compact、plan mode 等流传技巧在短会话中几乎不省额度甚至更贵。
Anthropic新研究:AI记忆如何避免「记错」?
Anthropic最新报告探讨AI智能体跨会话记忆的可靠性:数据库任务中记忆提升基准分数,但游戏实验显示记忆可能固化错误。报告建议保留证据、测试规则、纠正过时笔记,为助手构建者提供实践指南。
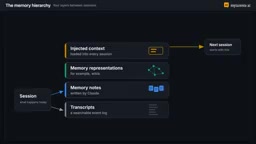
AI智能体记忆全解析:四层结构与“做梦”机制
解读Anthropic智能体记忆研究:记忆的四层架构、以CLBench和宝可梦实验检验“该记什么”,以及通过“做梦”修正笔记、构建wiki、提升上下文注入质量的机制与局限。