LLM分类的本质是特征工程:重新理解大模型的应用范式
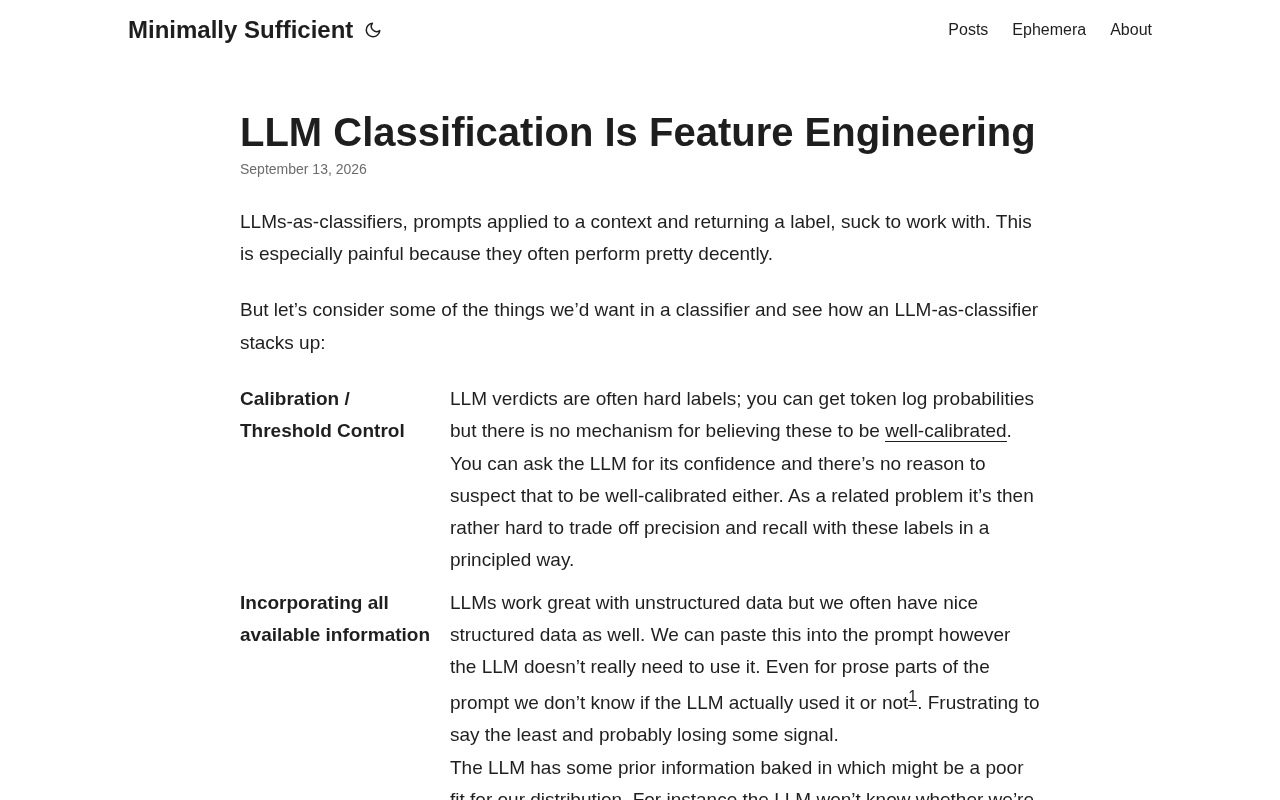
用LLM做文本分类本质上是特征工程,理解这一点才能构建稳定可维护的分类系统。
本文提出一个反直觉但实用的工程视角:用LLM做分类,本质上是在做特征工程。任何分类任务都包含「表示」与「决策」两个环节,传统机器学习将其分离,而LLM将二者压缩进单次前向推理。由此推论,提示词工程就是现代形式的特征工程——类别定义的清晰度、示例的分布,直接决定模型在语义空间中的决策边界。这一视角能够解释LLM分类不稳定的根源,提示混合架构(LLM做特征提取、轻量分类头做决策)的价值,并指导团队构建分层、可版本管理的生产系统,而不是陷入无休止地调整提示词的低效循环。
当我们用LLM做分类时,到底在做什么
把大语言模型(LLM)当作分类器使用,正在成为许多工程团队的默认选择。无论是判断用户意图、给工单打标签,还是对海量文本做情感识别,直接把文本丢给模型并要求它输出一个类别标签,看起来既简单又高效。然而这种便利背后隐藏着一个容易被忽视的本质:用LLM做分类,实际上是在做特征工程。
这个观点乍看有些反直觉。传统机器学习中,特征工程是指人工从原始数据中提取、构造有意义的输入变量,供下游模型使用。而LLM似乎跳过了这一步——它直接从原始文本走到了预测结果。但如果换个角度审视,LLM在完成分类任务时,内部所做的正是把非结构化文本转换为高维语义表示,再映射到有限的输出空间。这一过程与特征工程的目标高度一致。
分类问题的两个隐藏环节
任何分类任务都可以拆解为两个环节:表示(representation)与决策(decision)。表示环节负责把原始输入转换为可比较、可判别的形式;决策环节负责在这个表示空间上划出边界。
在传统流程里,这两个环节是分离的。数据科学家花大量时间设计TF-IDF、词嵌入、统计特征等表示,再训练一个逻辑回归或梯度提升模型来完成决策。而LLM把这两个环节压缩进了同一次前向推理中。当你写下一个分类提示词(prompt),并列出候选类别时,你其实是在告诉模型:请用你预训练得到的语义特征,去逼近我心中的那条决策边界。
这意味着,提示词工程在很大程度上就是特征工程的现代化身。你如何描述类别、给出多少示例、如何界定边界,直接决定了模型在语义空间中的划分方式。改一个词的定义,分类结果可能天差地别——这与传统特征工程中特征选择对模型的敏感影响如出一辙。
语义嵌入(Semantic Embedding)是理解LLM如何完成「表示」环节的关键概念。LLM在预训练过程中,通过海量文本学习到词语、句子乃至段落之间的语义关系,并将其编码为高维向量空间中的点。语义相近的文本在这个空间中距离更近,这使得模型能够识别「退款」和「钱没到账」表达的是同一意图。当LLM接收到一段分类文本时,它实际上是先在内部构建出这段文本的高维语义表示,再根据提示词所描述的类别边界来决定输出哪个标签。这与传统词嵌入模型(如Word2Vec、GloVe)的思路一脉相承,只是LLM的表示能力大幅提升,能够捕捉上下文、语气、隐含语义等更复杂的特征。正因如此,提示词中对类别的描述方式本质上是在引导模型在这个语义空间中划定决策边界——描述越精确,边界越清晰,分类结果越稳定。
为什么这个视角很重要
把LLM分类理解为特征工程,能带来几个实际的工程收益。
其一,它解释了为什么LLM分类经常不稳定。 既然模型的输出依赖于它对提示词语义的解读,那么类别定义的模糊、示例分布的偏差,都会像糟糕的特征一样污染最终结果。团队与其反复微调温度参数,不如回过头审视类别定义本身是否清晰、是否互斥。
其二,它提示了混合架构的价值。 一个更稳健的做法是把LLM当作特征提取器——让它输出语义嵌入或中间判断,再交给一个轻量的、可训练的分类头去做最终决策。这样既利用了LLM强大的语义理解,又保留了传统分类器的可控性、可解释性和低成本推理优势。
其三,它重塑了评估方式。 如果分类质量本质上取决于特征质量,那么评估就不该只看端到端准确率,而应该关注模型对边界样本的表示是否合理、对同义表达是否稳定。这些正是特征工程时代成熟的诊断方法。
「分类头(Classification Head)」是混合架构中的核心组件,指接在特征提取器之后、专门负责做最终类别判断的轻量模型层。在深度学习中,它通常是一个简单的全连接层加Softmax激活,将高维特征向量映射到各类别的概率分布。当把LLM作为特征提取器时,具体做法是:对输入文本调用LLM的Embedding接口(而非生成接口),获取固定维度的语义向量,再将这些向量作为输入训练一个逻辑回归或小型神经网络分类头。这样做的好处是多方面的:分类头的训练只需要少量带标签数据;推理时可以只运行轻量的分类头而无需每次调用完整大模型,大幅降低延迟和成本;业务规则变化时只需重训分类头,不必修改提示词;同时分类头的权重也具有一定可解释性。这一架构在工业界的文本分类系统中已有大量成功实践。
从提示词到可维护的分类系统
对于正在把LLM分类投入生产的团队,这个视角给出了清晰的实践方向。
当分类需求简单、类别少且定义清晰时,直接用提示词让LLM完成端到端分类是合理的,成本低、上线快。但随着类别数量增长、边界变得微妙,纯提示词方案会迅速触及天花板:一处修改牵动全局,回归测试困难,成本随调用量线性上升。
此时更值得投入的方向是分层设计——用LLM生成稳定的语义表示,把易变的业务规则和决策边界下沉到独立的、可版本管理的分类层。这样一来,业务逻辑的调整不再需要重写提示词,也不必每次都调用昂贵的大模型。
结语
“LLM分类即特征工程”不是要贬低大模型的能力,而是提供一个更清醒的工程框架。它提醒我们:LLM并没有废除机器学习几十年积累的方法论,只是把其中的表示学习环节做到了前所未有的强大。理解这一点,工程师就能跳出“不断调提示词”的低效循环,用更结构化的方式构建稳定、可维护、成本可控的分类系统。
相关推荐
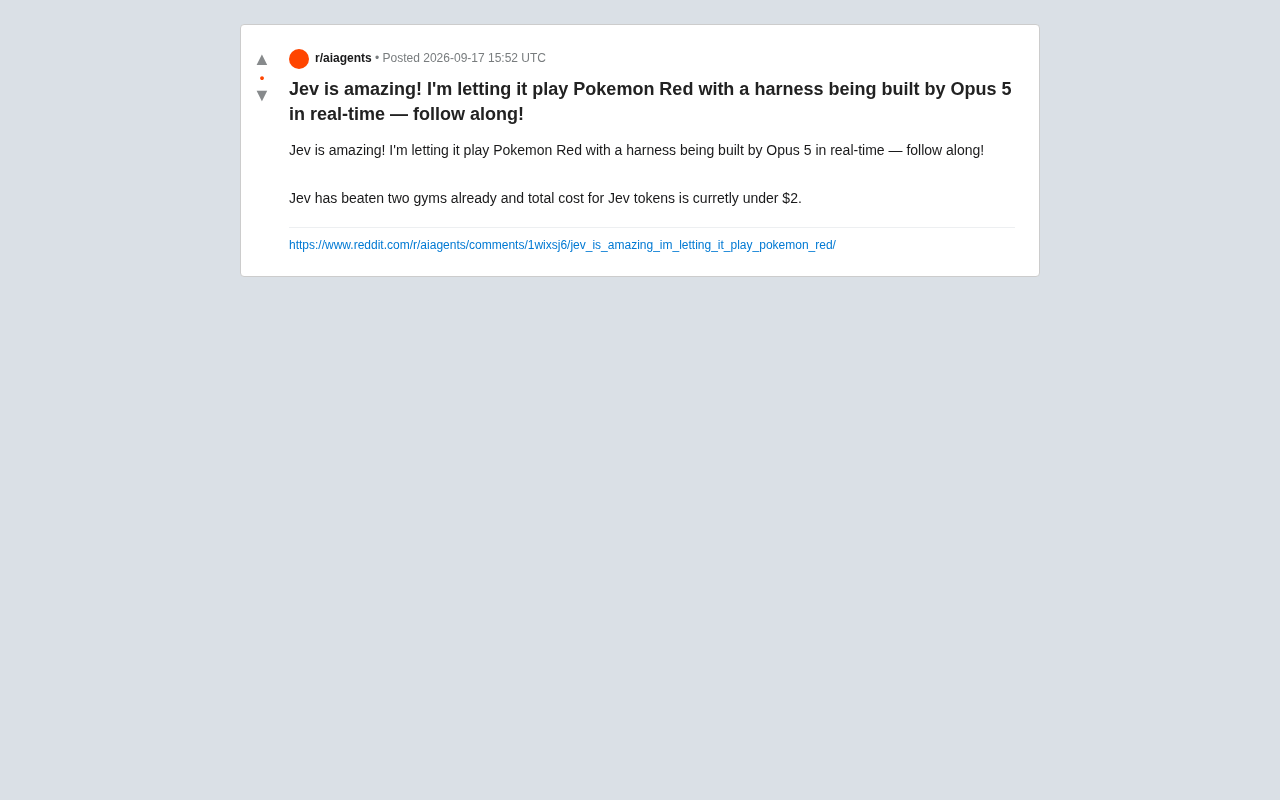
AI玩转《宝可梦红》:Jev仅花2美元通关两个道馆
一位Reddit用户让AI模型Jev实时游玩《宝可梦红》,harness由Opus 5同步搭建,仅花不到2美元就击败两个道馆,展现了低成本AI智能体的潜力。
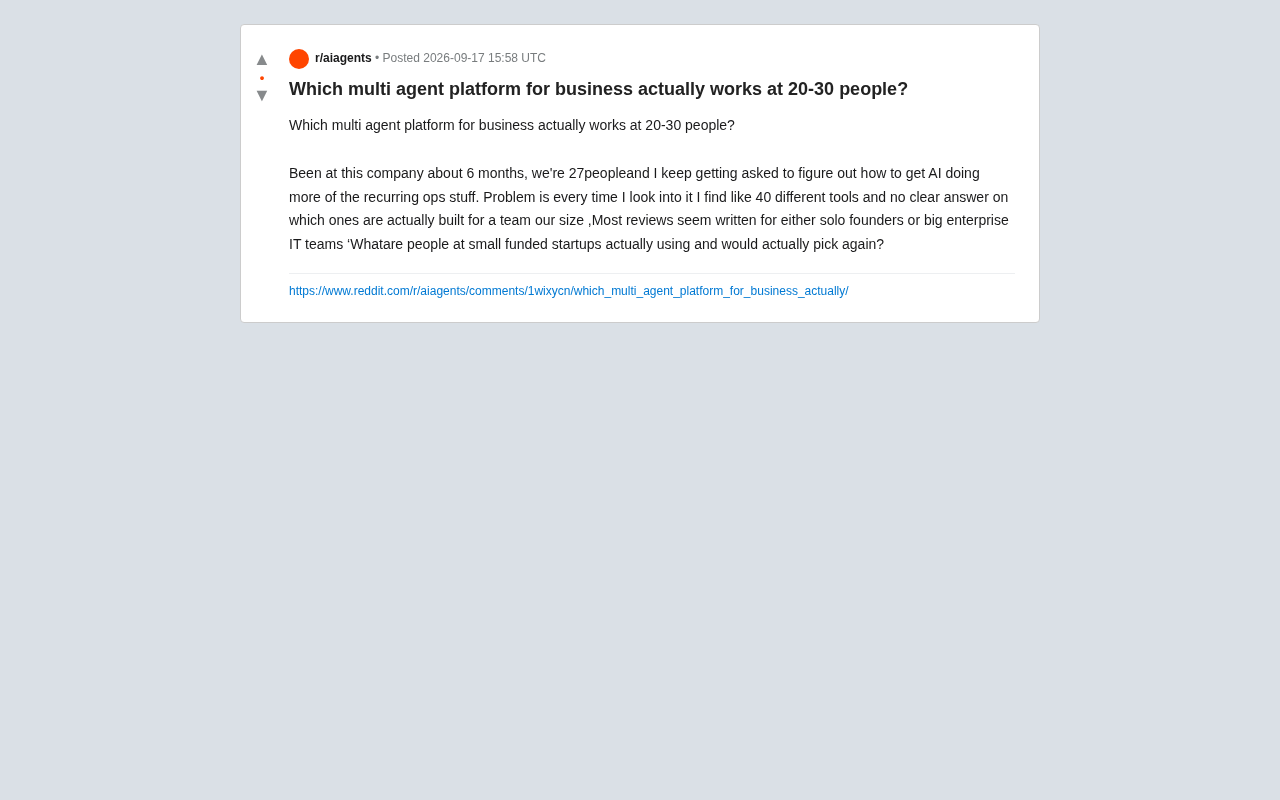
20-30人小团队如何选对多智能体AI平台?
20-30人的初创团队如何在数十款多智能体AI平台中选对工具?本文基于Reddit真实讨论,分析中小团队的选型痛点,并给出从高频场景切入、关注留存意愿等实用建议。
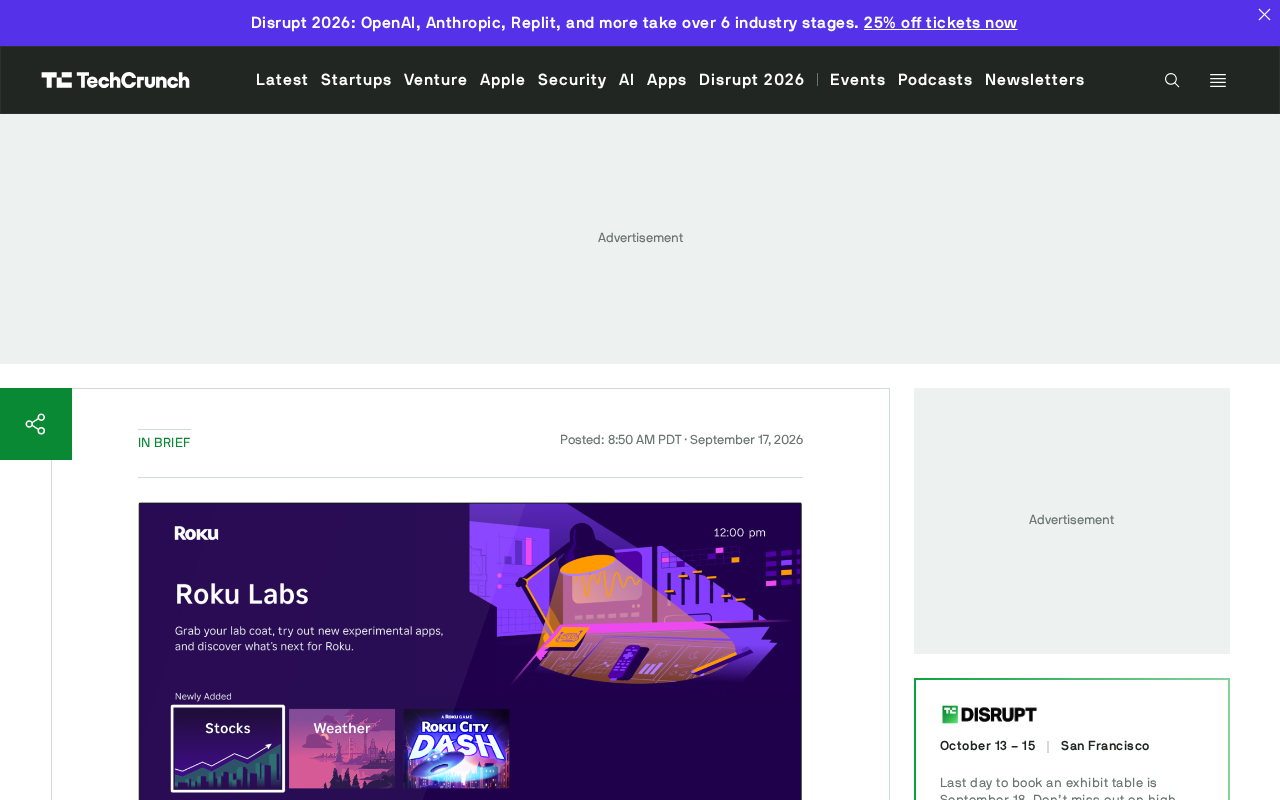
Roku Labs 上线:实验性应用登陆大屏幕
Roku 最新 OS 更新推出 Roku Labs 实验性应用入口,同时扩展个性化主屏市场覆盖并引入流媒体订阅捆绑功能,进一步强化其智能电视软件生态。