LLM挑战Zachtronics烧脑神作TIS-100
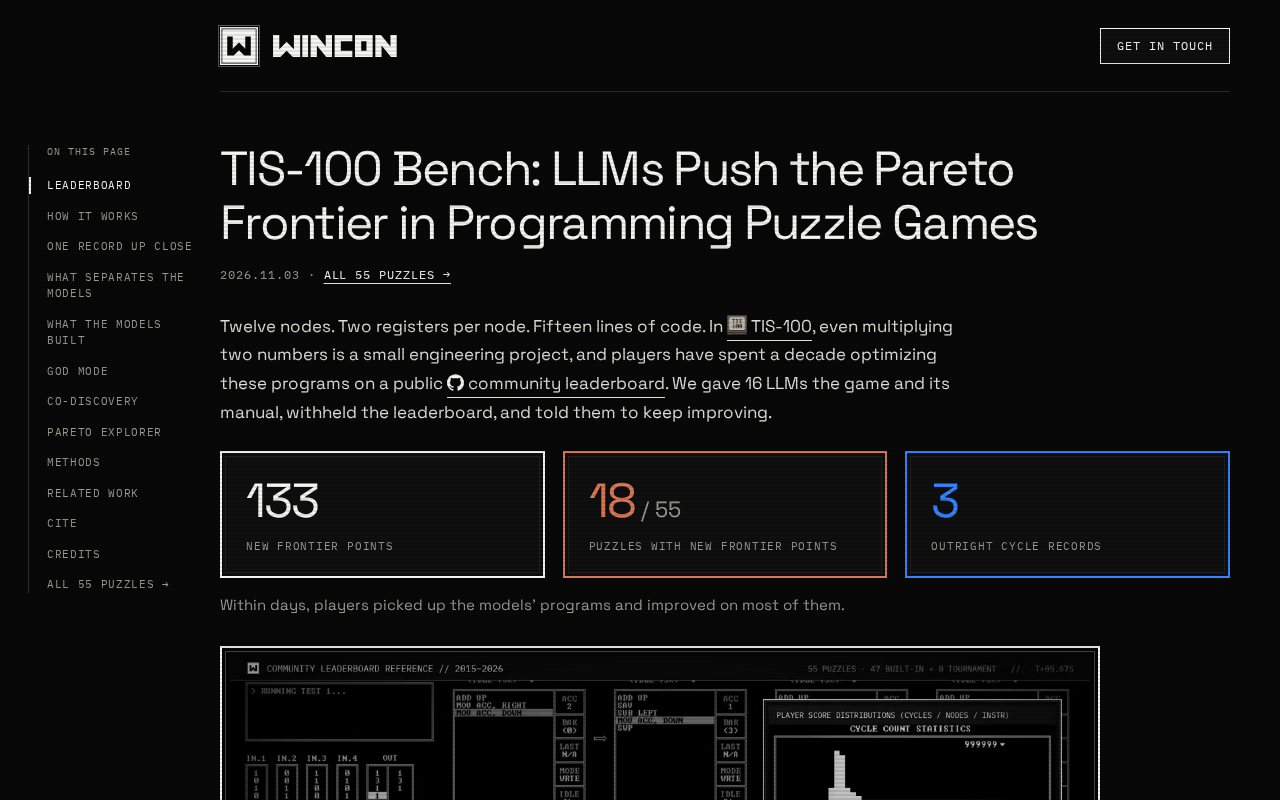
LLM挑战Zachtronics硬核汇编解谜游戏TIS-100,检验其在严格指令集下的程序合成与并发协调能力。
Hacker News上出现了一个让大语言模型游玩Zachtronics编程解谜游戏《TIS-100》的项目。该游戏要求玩家用极简汇编指令在多个节点间编写并行程序完成数据变换,对状态跟踪和并发协调要求极高。文章分析了TIS-100成为LLM试金石的原因:它没有框架和库可依赖,将难点从语法记忆推向计算思维。项目目前处于早期展示阶段,仅获5个点数且无评论,未公开通关数据。文章推断可从指令语义理解、多节点数据一致性、失败后迭代修正三个维度观察模型能力边界,并指出此类受控环境可作为LLM程序合成的基准测试,对开发处理嵌入式、底层协议等强约束场景的AI编程工具具有启示意义。
当语言模型遇上汇编解谜
Hacker News上出现了一个引人注目的项目:让大语言模型(LLM)尝试游玩Zachtronics出品的硬核编程解谜游戏《TIS-100》。原作要求玩家用类似汇编的指令集,在一个个节点间编写并行程序来变换数据流,堪称对逻辑与耐心的双重考验。将LLM放进这种环境,不只是玩票,更像是对模型程序合成与空间推理能力的一次极限测试。
TIS-100为何成为LLM的试金石
《TIS-100》的核心机制围绕一台虚构的TIS-100计算机展开。玩家需要读懂手册里的指令语义,在有限的寄存器与端口间规划通信,写出满足输入输出规范的微型程序。与常见的代码生成任务不同,这里没有庞大的框架和库可供调用,每个解法都必须精确控制数据在节点间的流动。
这种设定把难点从“语法记忆”推向了“计算思维”。LLM擅长模仿代码模式,却要在极小的指令空间里做状态跟踪和并发协调。游戏还内置了周期数与节点数的评分体系,逼迫解法在正确之外追求效率,进一步放大了挑战。
TIS-100指令集与并行计算模型
TIS-100的指令集极为精简,典型指令包括 MOV(在寄存器/端口间移动数据)、ADD/SUB(算术运算)、JMP/JEZ/JNZ(条件跳转)、SAV/SWP(暂存与交换)等,全部为单操作数或双操作数格式,没有函数调用、堆栈或动态内存。每个节点仅有 ACC(累加器)、BAK(备份寄存器)、NIL 以及上下左右四个端口可用,程序必须通过端口读写来与相邻节点通信。这种设计迫使解法以“数据流经过节点网络”的方式构建:上游节点负责产生或过滤数据,下游节点负责汇总或输出,必要时用多个节点流水线化处理。对LLM而言,难点在于必须同时维护每个节点的局部状态和节点间的时序同步——端口读写是阻塞式的,读空端口会等待,写满端口也会等待,任何一处时序错位都会导致死锁或输出错序。
Zachtronics风格与程序合成评测
Zachtronics 以《SpaceChem》《Infinifactory》《Opus Magnum》等作品闻名,其共同特征是“多种正确解、按效率排名”的开放式工程解谜。TIS-100 将这一理念压缩到纯汇编层面,使每一关都成为一个形式化规格:给定输入序列,要求输出序列满足变换规则,且程序在有限周期内停机。这与程序合成(program synthesis)领域的基准任务高度同构——给定输入输出示例,搜索满足规格的程序。不同之处在于,TIS-100 的规格由游戏关卡隐式给出,且评分函数(周期数、节点数)提供了多目标优化信号。因此,它天然适合作为评测LLM“从规格到代码”能力的沙盒:任务规模小、反馈确定、可自动判分,同时保留了并发与资源约束带来的真实难度。
项目透露出的能力边界
从Hacker News的讨论页面看,该项目目前只获得了5个点数且暂无评论,说明它还处于早期展示阶段。公开信息中并未给出模型通关的具体关卡数量或成功率数据。
不过,从任务性质可以推断出几个观察方向:模型能否正确理解TIS-100指令集的语义约束;在需要多节点协作时,是否维持住数据一致性;面对失败反馈时,能否迭代修正程序而不是重复同样的错误。这些维度恰好对应了LLM在严格规则系统下的常见短板。
对AI编程工具开发的启示
这类实验的价值不在游戏本身,而在于它提供了一个受控的、可自动评判的编程环境。与开放式的代码补全相比,TIS-100的每一关都有明确的通过标准,天然适合作为LLM程序合成能力的基准测试。
如果模型能在这类任务上表现出稳定的迭代能力,意味着未来的AI编程助手或许能更好地处理嵌入式、底层协议解析等强约束场景。反之,若模型在简单指令集上频繁迷失,则提醒开发者:上下文中的规则理解仍是需要重点补强的一环。
社区视角与后续关注
Hacker News上的低讨论量表明,这个项目尚未引发大范围关注,但也可能意味着它只是作者的一次个人探索。对于关注AI编程能力评测的读者,值得跟踪该项目后续是否公开代码、测试用例和模型表现细节。
将LLM放入复古硬核解谜游戏,看似猎奇,实则是用最小化的规则系统探测模型推理的极限。这种实验思路,比单纯的基准分数更能揭示模型在真实约束下的行为模式。
相关推荐
Starlink Mini 2 发布:便携卫星上网再进化
Starlink Mini 2 在 Hacker News 引发热议,帖子获 285 点、291 条评论。本文梳理便携卫星终端的迭代方向、社区讨论焦点及实际使用场景。
PewDiePie自搜趣谈:退休、自研AI模型Ajax与Linux日常
PewDiePie发布自搜视频,回应退休传闻,透露自研AI模型Ajax已达60 tokens/s、仍处BF16训练阶段,并分享Arch Linux日常、OpenAI封禁经历与对YouTube生态的疲惫感。
PewDiePie自曝失败:两年喂乌鸦计划为何翻车?
PewDiePie分享两年失败经历:试图与日本乌鸦交朋友,从喂花生到拯救倒吊乌鸦,最终被一位日本爸爸“抢走”荣耀。视频展现了与野生动物互动的真实挑战,以及创作者坦诚失败的一面。