LLM应用开发入门:从Token原理到LangChain与LangGraph

LLM的本质只是预测下一个token,应用价值全靠围绕它搭建的脚手架。
文章指出,ChatGPT、Claude等模型的底层能力只有一个——预测下一个token,所有实际应用都是在这个基础之上搭建的脚手架:它能看到什么上下文、调用哪些工具、记住什么。围绕这一核心,文章介绍了Transformer架构下的五个关键概念(分词、嵌入、上下文窗口、温度、微调),梳理了LLM的强项与短板(如幻觉、记忆短、推理弱),并给出搭建应用的路径:用LangChain连接模型与外部工具、管理记忆与链式调用,用LangGraph实现多步编排与多Agent协作,再通过Prompt工程中System/Human/AI/Tool消息的角色分工提升输出质量。文章最后提醒读者,框架并非必需,Anthropic建议从直接调用API起步;这张地图有时效性,也不包含代码与实测,核心决策顺序是先定上下文,再定权限,最后定记忆。
ChatGPT、Claude、Gemini、DeepSeek这些模型为什么能像人一样理解你、回复你?整篇文章的核心其实就一句话:LLM只预测下一个token。所以每一个有用的应用,都是围绕它搭建的脚手架——它能看到什么上下文、能调用哪些工具、能记住什么。
理解这一点,你就能明白为什么同样一个模型,在不同的产品里表现差异巨大:差别不在模型本身,而在脚手架搭得好不好。
LLM到底是什么
大语言模型(Large Language Model)是一种用来处理和生成类人文本的AI系统。底层是深度学习,具体来说是那篇著名论文《Attention Is All You Need》提出的Transformer架构。模型在海量文本(比如fineweb数据集)上训练,从中习得语言模式、上下文关系和语义。这让它们擅长生成文本、翻译、摘要等任务。
传统规则系统执行的是人写好的指令,而LLM是概率性的——它基于训练中见过的内容,预测最可能的下一个词。正因如此,它才能应对五花八门的问题,同时给出贴合上下文的回答。
绕不开的五个关键词
Tokenization(分词):把文本拆成更小的单元token。一个token可能是一个词、词的一部分,或单个字符。模型处理的是token,不是原始文本。
Embeddings(嵌入):用数字向量表示词或短语,捕捉它们之间的关系。模型靠它知道两个不同的词意思相近。
Context window(上下文窗口):模型一次能处理的最大文本量。窗口越大,能记住的越多,回答越连贯。超出窗口,对话早期的内容就会掉出去。
Temperature(温度):随机性旋钮。调高输出更有创意、更多样;调低则更可预测、可复现。
Fine-tuning(微调):在特定数据集上继续训练模型,让它在医疗、法律、金融等专门领域表现更好。
Transformer架构是2017年Google团队在论文《Attention Is All You Need》中提出的神经网络结构,它的核心创新是自注意力(Self-Attention)机制。与循环神经网络(RNN)按顺序逐字处理不同,自注意力允许模型在处理每个词时同时"看到"序列中的所有其他词,并动态计算它们之间的相关权重。这让训练可以高度并行化,也使模型能捕捉长距离的语义依赖。GPT、BERT、Claude、Gemini等主流大模型都建立在Transformer之上,区别主要在于层数、注意力变体(如多头注意力、稀疏注意力)以及训练方式(自回归还是掩码语言建模)。理解Transformer有助于明白为什么上下文窗口、注意力预算会成为模型的硬约束。
LLM擅长什么、不擅长什么
LLM以及整个AI,都不是万能药。认清它的边界,比盲目乐观更重要。
它真正强的地方
- 写出贴合上下文、像人写的连贯文本
- 快速提取和总结大量信息
- 跨多语言工作
- 生成结构化输出
幻觉(Hallucination)指模型生成看似合理、流畅但事实上错误或凭空捏造的内容,比如不存在的论文引用、虚构的法律条文或错误的人名日期。它并非程序错误,而是概率生成机制的副产品:模型根据训练分布预测最可能的下一个token,当缺少可靠知识或上下文时,它会"填补"出一个统计上合理的答案,而不是承认不知道。温度调高、训练数据有噪声、问题超出训练范围都会加剧幻觉。常见缓解手段包括检索增强生成(RAG)、让模型引用来源、要求它表达不确定性,以及在关键场景加入人工或规则校验。
它容易翻车的地方
- 会幻觉,而且信誓旦旦
- 记忆短,上下文窗口有限
- 可能带偏见,取决于训练数据
- 逻辑推理不是强项
- 运行成本高、能耗大
模型本身的特性说完了。接下来才是关键:怎么用它真正做出东西?
怎么用LLM搭建应用
一个裸模型做不了太多事。如果你想解决真实问题,而不是再多做一个聊天机器人,就必须给它资源:联网能力、任务工具(调API、查数据库)等等。这就轮到LangChain出场了。
LangChain
如果你认真要做LLM应用,LangChain值得放进工具箱。它提供了一套和模型对话的结构化方式,并让模型接入外部数据源、数据库和API变得容易得多。它内置了记忆、链式调用、外部工具(如搜索API)等预制组件。不管你做聊天机器人、研究助手还是AI知识库,它都能帮你省掉大量管道工作。
选择LangChain的几个理由:
- 集成:轻松接入不同模型、数据库和外部API
- 工具:模型可以调用搜索API、计算器等工具来给出更好的答案
- 链(Chains):把多次LLM调用串成对话流
- 记忆:在多轮交互中保留对话上下文
让AI对话不跑偏
LLM注意力有限(还是上下文窗口的问题),长对话容易乱。三种保持可控的方式:
- 裁剪(Trimming):砍掉不需要的对话部分
- 过滤(Filtering):只保留最相关的消息
- 摘要(Summarising):把冗长对话压缩成简短回顾
用LangChain能搭的东西不少:聊天机器人、智能搜索、写作助手、自动化研究工具。凡是需要对接数据库、外部API和知识检索系统的场景都适用。
但它也有局限。LangChain结构化了你的AI交互,可仍然受制于模型自身的约束,比如上下文窗口、没有长期记忆。单独用它也给不了你高级决策或复杂多步编排能力。这就是LangGraph要解决的问题。
链(Chains)是LangChain中的基础组合单元,指的是把多个组件按预定顺序串接起来,形成一条可复用的处理流水线。最简单的链可能只是"Prompt模板 → LLM → 输出解析器",复杂一些的可以把多次LLM调用、外部工具、条件判断串在一起。链的价值在于把散落的调用逻辑封装成声明式结构,让prompt模板、模型选择和输入输出格式集中管理,便于测试和复用。不过链是静态的、线性或轻分支的,无法表达循环与动态决策,这正是后来LangGraph用图结构取代链式编排的原因。
LangGraph
LangGraph是一个构建动态、多步AI应用的灵活框架。如果说简单应用是"输入prompt、输出答案",LangGraph让你构建带多个决策点、多个agent互相通信、结构化自动化的工作流。当你的AI需要和用户来回交互、处理不同工作流、或跨会话记忆时,它尤其好用。
你可以用它做查询路由、把大任务拆成小步骤、并行执行。自动化客服流程、一步步引导用户完成任务、带AI参与的内容生成——它提供了编排这一切的组件。
对话数据怎么存
想让AI"记住"事情?LangGraph给了几种选择:
- Memory Saver:本地存储,访问快
- Postgres Saver:用PostgreSQL做外部存储
- MongoDB:把对话存在NoSQL数据库
- Redis Saver:快速、高效的AI记忆存储
上生产前要做的准备
- 每个会话用不同的thread ID
- 用持久化检查点保存对话历史
- 避免超大用户prompt压垮模型
- 流式返回响应,体验更顺滑
- 处理错误(限流、内容审核等)
Agent(智能体)在LLM语境下指一个能自主决定下一步动作的模型驱动系统:它接收目标后,不是一次性输出答案,而是循环地"思考—选择工具—执行—观察结果",直到任务完成。与固定链不同,Agent的路径是运行时动态生成的。LangGraph用图(节点表示处理步骤,边表示转移条件)来显式描述这种循环,让多Agent之间的消息传递、状态共享和中断恢复变得可控、可调试。常见模式包括ReAct(推理加行动)、规划者与执行者分工、以及主管Agent调度多个专职Agent。
Prompt工程
想从LLM拿到准确、相关的答案,prompt至关重要。Prompt工程一半是艺术一半是科学,你怎么组织问题,直接改变答案质量。
对话里的角色分工:
- SystemMessage:设定AI的基本规则、行为和人格,定义角色、语气或整体准则
- HumanMessage:用户发的内容,通常是人打的字
- AIMessage:模型返回的内容——文本,或调用工具的请求
- ToolMessage:把工具调用的结果带回给模型,通常是获取或处理外部数据之后
这篇内容的边界在哪里
你可能根本不需要框架。 最有力的反驳来自Anthropic的《Building effective agents》:从直接调用API开始,因为框架会增加层级、隐藏prompt、让调试更难。如果你的应用只是一两次模型调用,纯SDK学得更少、坏得更少。
这是一张有时效的地图。 这个领域的框架API每隔几个月就变,作者列出的LLM"不擅长"清单也在缩短。照搬本文模式前,请先查当前文档。
这是概览,不是构建日志。 没有代码,没有实测数据。想要完整案例,可以去看Finchat这个项目。
最后记住一件事
有了LangChain和LangGraph这类框架,用LLM搭建应用比以往任何时候都容易。聊天机器人、智能助手、知识搜索工具,说到底都归结为三件事:prompt工程、上下文管理、对话工作流。
如果只记一件事:先决定模型需要看到什么,再决定它被允许做什么,最后决定它应该记住什么。按这个顺序来。所谓对的框架,就是让这三个决定最容易读清楚的那个。
相关推荐
Anthropic IPO倒计时:2万亿美元估值背后的算力账本
Anthropic IPO进入倒计时,目标估值最高2万亿美元,较半年前H轮融资翻倍。本文梳理从秘密交表到投资者日的完整时间线,分析2万亿估值背后的算力成本逻辑,以及投资者日真正要回答的核心问题。
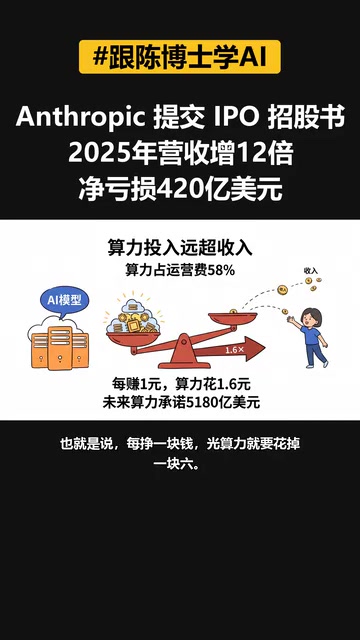
Anthropic IPO招股书揭秘:营收暴增12倍背后,算力成本与客户集中度的双重考验
Anthropic提交IPO招股书,2025年营收增12倍至46亿美元,净亏损420亿中340亿为非现金费用。本文拆解其算力成本、2万亿估值逻辑、客户集中度风险与创始团队控制权等核心看点。
Xteink X4 Pro 评测:口袋里的迷你电纸书,价格更亲民
Xteink X4 Pro 是一款 4.26 英寸迷你电纸书,比 6 英寸 Kindle 更小更薄,可磁吸在手机背面,价格也比以往更低。本文分析它的屏幕、设计、适用场景和性价比。