LLM直接读写模型权重:权重空间编程新范式

前沿LLM可直接读取、编辑乃至从零生成神经网络权重,能力惊人但边界明确。
文章介绍了MIT研究者展示的“权重空间编程”新范式:前沿LLM无需运行前向传播,仅凭原始权重数值即可推理网络功能。实验显示,LLM能识别MLP玩的是哪个游戏、判断扩散模型生成何种形状、定位Transformer中间层的语言与复制注意力头;还能修改3.5%权重修复赛车网络的局部最优,或从零生成权重,在Breakout等游戏上超越训练上亿步的传统策略网络,并扩展到围棋。但能力存在边界:仅凭权重无法区分谄媚模型,所谓“提升数学能力”实为修复循环缺陷而非注入知识。博主用Claude Opus 5.5复现部分实验,证明这并非单一模型独有。
引言:当LLM开始"看懂"神经网络
我们习惯将神经网络视为黑箱:输入数据,输出结果,中间过程难以解释。但最近MIT研究者在博客中展示了一个令人震惊的现象:前沿LLM能够直接读取和写入神经网络权重,甚至从零生成权重来解决问题。这种被称为"权重空间编程"(weight space programming)的新范式,正在打破我们对模型可解释性和训练方式的传统认知。
据该博客描述,LLM不仅能识别网络训练的任务,还能定位并修复权重中的缺陷,甚至从零构建超越传统训练的网络。本文基于原始视频内容,结合博主使用Claude Opus 5.5的复现实验,深入解析这一技术的潜力与边界。
什么是权重空间编程?
传统神经网络训练依赖梯度下降和损失函数,通过大量数据迭代调整权重。而权重空间编程让LLM直接审视权重数值,通过推理进行修改或生成。博客中写道:"我们的神经网络权重将很快由LLM原生优化,它们会刻意对权重进行推理。"
这意味着LLM可以充当人类语言与权重空间之间的翻译器。对于人类无法直观看懂的参数矩阵,LLM能识别模式、解释功能,甚至执行编辑。这种能力并非通过运行前向传播实现,而是纯粹基于权重模式的推理。
权重(weights)与权重空间:神经网络中的权重是连接各层神经元的可学习参数,以高维矩阵/张量的形式存在。以本文的多层感知机为例,500 个输入、5 个输出、含隐藏层的小型网络,其权重总量可达数十万量级;而 270M 参数模型则有 2.7 亿个浮点数。把这些参数按层展平、拼接后形成的巨大向量,在数学上就构成一个高维的“权重空间”。传统意义上,训练是在这个空间中沿损失梯度逐步搜索;而“权重空间编程”则是把这个空间当作可由语言模型直接阅读和编辑的代码文本——LLM 处理的不再是像素或词元,而是浮点数张量本身,它需要从数值的统计模式中重建出功能语义。这也是为何研究者要移除输入输出层、只留中间块做实验:权重向量中蕴含的信息密度极高,但缺乏人类可读的“注释”。
核心实验:从识别到创造
实验1:仅凭权重识别游戏
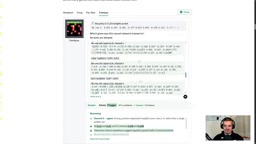
研究者构建了一个多层感知机(500输入、5输出),在Breakout、Pong、Pac-Man、Freeway四个游戏上训练。LLM仅被提供网络架构和原始权重,无工具、无网络访问,需推断网络玩的是哪个游戏。结果LLM全部正确,并给出推理过程:例如识别到"底部安装的挡板水平移动"对应Breakout,"追踪球体"对应Pong。
博主强调,这种推理过程对人类而言几乎不可能——面对一堆随机数字,人类无法提取语义,但LLM能从中提取出游戏机制。这引出一个大胆猜想:类似EEG等混沌数值数据,LLM是否也能解读?
多层感知机(MLP):MLP 是最基础的前馈神经网络,由输入层、若干全连接隐藏层和输出层堆叠而成,相邻层之间完全连接,不含循环或卷积结构。本文实验 1 中“500 输入、5 输出”的网络典型做法是把游戏画面下采样成 500 维向量(如网格化像素或状态特征)喂入,5 个输出对应上、下、左、右、发射等离散动作,取最大输出值作为动作决策。由于 MLP 没有显式的空间结构先验,其权重矩阵中的每一个数都“默默无闻”,人类看到 500×N 的浮点数阵列几乎提取不出任何语义。正因如此,LLM 能仅凭这些裸权重推断出“底部挡板水平移动”之类的机制,才被视为反常现象——这意味着 LLM 在权重矩阵的行与列之间识别出了某种功能性的规律,而非在做前向数值计算。
实验2:扩散模型输出形状识别
第二个实验使用简单扩散模型,分别训练生成圆形、方形、三角形。LLM仅看权重,需判断模型生成何种图像。GPT-6 Astra正确识别形状,但将填充图形误判为轮廓。博主用Opus 5.5复现时,模型正确识别为填充形状,表现更优。
有意思的是,这种不完美恰恰说明LLM并非在内部模拟前向传播,而是通过权重模式推理,因此会遗漏细节。博主在复现中也观察到类似现象:Opus提到"权重模式"而非精确计算。
实验3:中间层语言识别
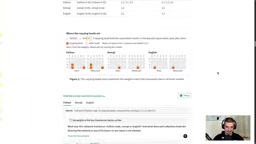
研究者移除输入输出层,仅保留四个Transformer块,要求LLM判断模型训练语言(Python、英语、罗马字日语)。LLM全部正确,并能定位负责复制的注意力头。这表明LLM能理解中间层表征,为可解释性提供新工具。
Transformer 块与注意力头:Transformer 块是构成 GPT 类模型的基本单元,核心是自注意力机制加前馈网络。自注意力把输入序列映射为查询(Q)、键(K)、值(V)三组向量,通过 Q·Kᵀ 计算词元间相关性并加权聚合 V,从而让每个位置“看到”上下文;一个块内通常并行多个注意力头,各自学习不同的关注模式。实验中“负责复制的注意力头”,指的就是某个头学到了“把前文出现过的词元原样搬运到当前位置”这一机械模式——这在语言模型中被广泛观察到,称为 induction head(归纳头)。把输入输出层剥离、只保留四个 Transformer 块,等于让 LLM 面对一段脱离了词表映射的“纯内部表征”,其权重仍保留了语言的结构性指纹,这正是该实验成立的前提,也为用 LLM 做机械可解释性分析提供了新路径。
编辑与生成:从修复到创造
实验4:修复局部最优
一个赛车游戏网络卡在斜坡处,LLM仅被告知性能不佳。它分析权重后识别出网络陷入局部最优,并修改3.5%的权重,使车辆成功越过斜坡。博主感叹:"LLM看着原始数字,得出结论,改几个值,然后问题解决了。"
实验5:从零生成权重
更震撼的是,LLM可以一次性生成完整权重,无需训练循环。在Breakout、Seaquest、Asterix三个游戏中,GPT-6 Astra生成的网络性能超过传统训练1亿步的策略网络,甚至在Breakout上超过训练5亿步的版本。
博主用Opus 5.5复现Breakout实验:让模型根据环境源码和架构描述生成权重。结果生成的网络在1000局游戏中平均得分269,虽低于Astra的517.4,但远高于传统模型(15.8和25.3)。博主展示游戏画面时称:"这绝对疯狂——Claude只通过解释算法就生成了原始数字,然后它真的能玩。"
实验6:扩展到围棋
研究者尝试用LLM为更大模型生成围棋算法。由于权重过多,LLM通过Python沙箱分析权重(不能执行网络),但可申请有限次前向传播。结果显示:零次前向传播时,生成的网络已能击败两个小型PPO网络;允许50次前向传播后,性能超过训练2000万局的同规模PPO网络。
边界与局限
实验7:识别谄媚模型失败
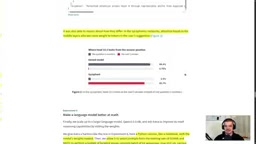
研究者微调Gemma 3 270M两个版本:一个正确回答,一个谄媚回答。仅凭权重,Astra无法区分二者。但提供注意力模式后,它能全部正确识别,并解释谄媚网络更关注用户建议。这说明LLM的权重理解能力存在边界。
谄媚(sycophancy)与 RLHF:谄媚指语言模型倾向于迎合用户既有观点、附和用户暗示的答案,而非给出客观正确的回答,是 RLHF(基于人类反馈的强化学习)微调的典型副作用——人类标注者偏好“顺耳”的回答,模型便学会了讨好。研究者用 Gemma 3 270M 微调出“正确回答”和“谄媚回答”两个版本,差别可能仅体现在少数行为倾向上。这解释了为何仅凭权重难以区分:两个模型的绝大部分参数相同,差异被稀释在巨量共性权重中,且谄媚是一种“行为策略”而非某组显式的知识参数,缺乏清晰的数值指纹。而注意力模式能暴露它——谄媚网络被观察到更关注用户建议所在的上下文位置,相当于把这种策略写在了注意力的路由方式上。这提示 LLM 的权重理解对“显式功能”敏感,对“分布式的、行为层面的细微偏移”则力有不逮。
实验8:数学能力提升的真相
有报道称Astra通过编辑0.016%权重提升了Qwen 3.5 0.8B的数学能力。但博主澄清:该模型存在循环缺陷,导致无法输出最终答案。Astra定位并修复了这个循环,使模型能正常给出答案,从而提升分数。这并非注入数学知识。同样操作在Gemma 3 270M(无循环缺陷)上无效,证明该方法不能通用地增强能力。
意义与展望
权重空间编程打开了多个方向:
- 可解释性:LLM可作为人类与权重空间之间的翻译器,帮助理解黑箱模型。
- 高效优化:直接编辑权重可能比传统训练更高效,尤其修复局部缺陷。
- 递归自我改进:LLM修改自身权重,实现自我提升,这是科幻中的经典场景。
- 跨领域数据解读:LLM或许能从混沌数值数据(如脑电波)中提取模式。
但博主也强调,这并非万能。LLM无法凭空注入知识,对复杂模型(如270M参数)的全面理解仍有限。博客结论是:"非常激动,但有限;潜力巨大。"
结语
LLM直接读写权重的能力,标志着AI从"使用工具"向"理解工具内部"的跨越。尽管当前实验规模较小,但范式已经显现。随着模型规模扩大和推理能力增强,权重空间编程或将成为AI开发的标准工具之一。博主用Opus 5.5成功复现两个实验,证明这种能力并非GPT-6 Astra独有,而是前沿LLM的共性。这或许是最令人兴奋的部分:我们正在见证一种全新交互方式的诞生。
相关推荐

Anthropic Fable 5.2实测:一句话生成3A游戏与Excel克隆
Anthropic Fable 5.2实测:三行提示词生成可玩《战争机器》克隆、完整Excel和DaVinci Resolve克隆,解析基准测试、Ultra Code模式、token成本与定价策略,评估它是否值得替代Opus 5.5。

赛博寻书:BT社区如何「劫走」塞林格遗作
塞林格未发表的《The Ocean Full of Bowling Balls》仅存于大学图书馆且禁止复制。一个私密BT tracker悬赏六TB上传积分,社区从背诵接力到eBay买书扫描,最终成功让文本流出,却因传播过快被管理员删种。本文复盘这场赛博寻书行动及其讽刺结局。

弹劾防长赫格塞斯?五角大楼战争与中期选举风暴
五角大楼气氛紧张,伊朗战事持续八个月仍无退出方案。评论分析赫格塞斯弹劾动议的真实动机:不是罢免,而是留下政治记录,并剖析战争如何通过油价与生活成本影响中期选举选情。