LM Studio vs Ollama:本地AI运行器怎么选?
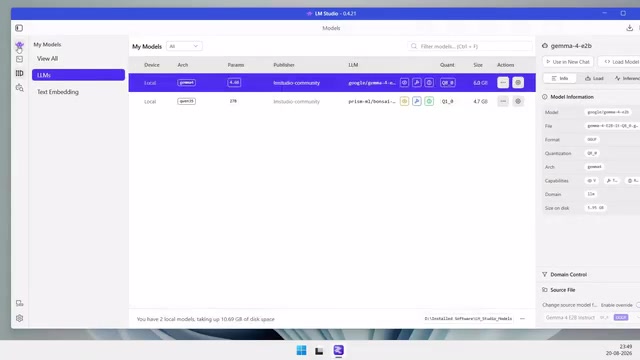
LM Studio 适合新手可视化体验,Ollama 适合开发者轻量集成,两者兼用可覆盖探索到部署的完整本地AI链路。
本文对比了本地大模型运行领域的两款主流工具:LM Studio 和 Ollama。LM Studio 是一款精致的桌面应用,内置模型浏览器、可视化参数调节和RAG功能,适合不想接触终端的新手用户;Ollama 则以轻量命令行后端为核心,提供兼容OpenAI的本地API,对开发者集成更友好。两者底层同用 llama.cpp 与 GGUF 格式,模型智能水平相同,差异在于资源占用与生态定位——NVIDIA GPU 上 Ollama 更省资源,Apple Silicon 上 LM Studio 因 MLX 支持更具优势。作者最终建议两者兼用:用 LM Studio 探索和测试模型,用 Ollama 为应用提供稳定的本地API后端。
厌倦了为云端AI付费,或者不想让对话数据离开自己的电脑?本地大模型运行工具正成为越来越多用户的选择。在这个领域,LM Studio 和 Ollama 是两个响亮的名字。它们都能让你在本地跑起强大的AI模型,但定位截然不同。这篇文章帮你理清两者的差异,找到适合自己的那一个。
定位差异:桌面应用 vs 命令行后端
LM Studio 本质上是一个私密、离线版的 ChatGPT。它提供了一套精致的桌面界面,你可以搜索模型、下载模型、开始聊天并调整各种设置,全程无需接触终端。它内置了连接 Hugging Face 的模型浏览器,能直观显示模型大小、量化选项,以及某个模型是否适合你当前的硬件配置。
Ollama 走的是另一条路。它最初是作为一个轻量级命令行工具和后台服务器构建的,虽然如今也推出了 Windows 和 macOS 的官方桌面应用,但界面极为简约——选一个模型,开始对话,就这么简单。这种简洁性恰恰是 Ollama 最大的优势之一,对初学者相当友好。
如果只看界面体验,LM Studio 更胜一筹。它更像一个完整的应用程序,提供了 GPU 层数、上下文长度等可视化控制,还有基础的文档聊天和 RAG 功能。Ollama 的桌面应用虽然更干净,但没有提供同等级别的可视化调节能力。
性能对比:底层技术相同,资源占用不同
这里有个关键认知:两个工具都基于相同的底层技术栈,包括 llama.cpp,并且都支持 GGUF 格式模型。也就是说,模型本身不会因为你用了 LM Studio 或 Ollama 就变得更聪明——智能水平取决于模型,而非运行器。
差异体现在资源效率上。Ollama 通常对系统资源占用更轻,速度也可能稍快,尤其是在 NVIDIA GPU 上表现更优。而 LM Studio 因为承载了更丰富的图形界面,会占用更多内存(RAM)。
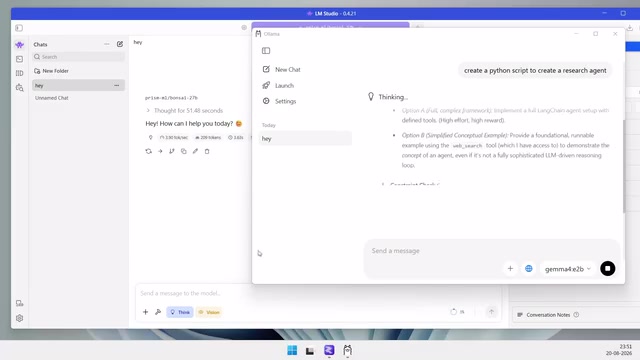
不过在 Apple Silicon 芯片的 Mac 上情况会反转。LM Studio 对 MLX 的支持让它的性能极具竞争力,在某些场景下甚至能反超 Ollama。所以硬件平台是选择时不可忽视的变量。
llama.cpp 是一个由 Georgi Gerganov 开发的开源推理引擎,用纯 C/C++ 实现了 LLaMA 系列模型的高效推理,无需 GPU 也能在 CPU 上运行大型语言模型。GGUF(GPT-Generated Unified Format)则是其配套的模型文件格式,前身为 GGML,专为量化存储和高效加载设计。量化是指将模型权重从高精度浮点数(如 float32)压缩为低精度整数(如 int4、int8),可将模型体积缩减 50%-80%,同时仅损失少量精度,使消费级硬件也能运行数十亿参数的大模型。正因为 LM Studio 和 Ollama 都以 llama.cpp 为推理核心,两者加载同一个 GGUF 文件时,输出质量理论上应当一致,性能差异主要来自各自的调度策略和界面开销。
MLX 是苹果公司专为 Apple Silicon(M 系列芯片)设计的机器学习框架,充分利用了统一内存架构(UMA)——即 CPU 与 GPU 共享同一块高带宽内存池,无需在两者之间复制数据。这一特性使得在 M1/M2/M3/M4 芯片上运行大模型时,内存带宽利用率远高于传统的 CPU+独立显卡架构。LM Studio 率先深度集成了 MLX 后端,能够直接加载 MLX 原生格式的模型,在 Mac 上获得比 llama.cpp 路径更优的吞吐量。这也是为什么在 Apple Silicon Mac 上,LM Studio 的实测速度有时会超过同样运行 llama.cpp 的 Ollama——这并非运行器本身更"聪明",而是底层计算路径不同所致。
开发者视角:Ollama 的集成优势
如果你是开发者,Ollama 开始展现出明显优势。它以本地服务器形式运行,提供兼容 OpenAI 的 API,这让你能极其轻松地把本地模型接入各类应用程序、编程工具、AI 智能体、Docker 容器,以及 LangChain、OpenWebUI 等框架。
Ollama 还支持用 Modelfile 创建可复现的模型配置,并基于 MIT 许可证开源——这对希望检查和掌控软件的开发者来说是又一大加分项。
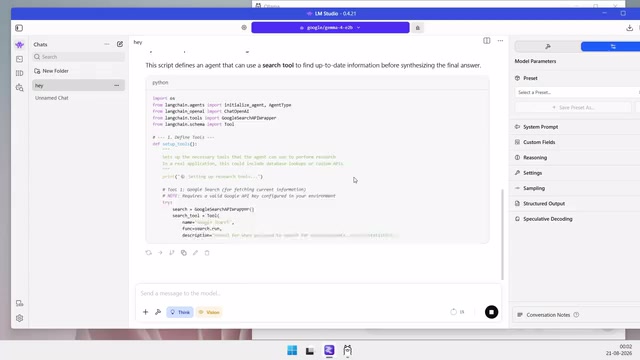
公平地说,LM Studio 同样提供兼容 OpenAI 的本地 API、名为 LMS 的命令行工具,以及无头(headless)运行能力,所以它并非不能用于开发。但整体工作流更偏向桌面用户,而非自动化和基础设施场景。
OpenAI 兼容 API 指的是遵循 OpenAI 官方 REST API 规范(尤其是 /v1/chat/completions 端点)的接口实现。由于 OpenAI API 已成为 LLM 集成的事实标准,大量开发框架、插件和工具都内置了对它的支持。Ollama 在本地默认监听 http://localhost:11434,通过将 base URL 指向该地址,开发者几乎无需修改现有代码即可将云端模型替换为本地模型。LangChain 是一个流行的 LLM 应用开发框架,提供链式调用、记忆管理、工具集成等能力;OpenWebUI 则是一个自托管的 Web 聊天界面,可直接对接 Ollama 后端,为不习惯命令行的团队成员提供友好的访问入口。Modelfile 类似于 Docker 的 Dockerfile,允许开发者声明式地定义模型参数、系统提示词和行为配置,便于版本控制和跨环境复现。
模型发现体验
在找模型这件事上,两者差异也很明显。LM Studio 把模型发现做得极其顺手:你可以直接浏览 Hugging Face、比较不同量化版本、查看文件大小,并在同一个界面内完成所有下载操作。
Ollama 有自己的模型库,通过命令或桌面应用下载模型都很简单,但整体的发现体验相对受限,不如 LM Studio 那样直观全面。
如何选择:其实不必二选一
结论并不是非此即彼。
如果你是本地AI新手,想要精致的 ChatGPT 风格体验,偏好可视化控制,或者干脆不想碰终端,那 LM Studio 是更好的起点。
如果你是开发者、进阶用户,或者正在构建AI应用、智能体、自动化工具,Ollama 会更合适——它轻量、可脚本化、易于集成,作为本地AI后端表现出色。
更聪明的做法是两者兼用:用 LM Studio 来发现和测试模型、试验各种设置、随意聊天;当需要为应用和AI工具提供稳定的本地 API 时,切换到 Ollama。两者结合能覆盖从探索到部署的完整链路。
说到底,没有绝对的赢家。LM Studio 胜在用户体验,Ollama 胜在开发者工作流与轻量级基础设施。而它们共同的价值在于:让你能在本地运行强大的AI模型,彻底摆脱对云端的依赖。
相关推荐
Vibe Coding实战:培养产品思维,用AI把日常需求变成能变现的APP
Vibe Coding系列教程第二篇,讲解独立开发者如何培养产品思维、从模仿与生活痛点中发现需求,并用AI Agent自动化调研流程,快速判断一个APP创意是否值得投入开发与变现。
OpenAI Codex 上手指南:用AI代理构建并部署应用
OpenAI Codex 速成课中文整理:从安装、价格套餐、插件与自动化,到 Plan/Go 命令、技能系统,并实战演示用声控 Flappy Bird 游戏走通构建与部署全流程,帮你真正上手这款自主 AI 编码代理。
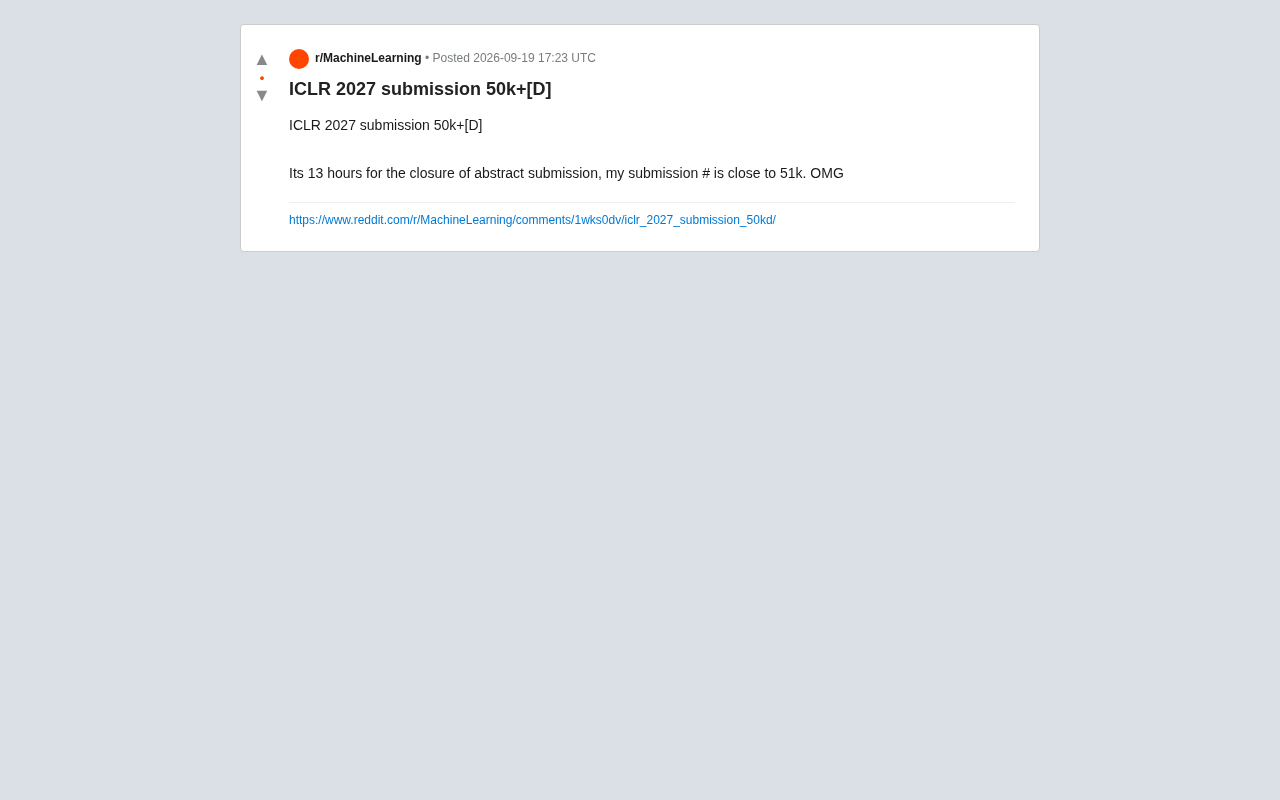
ICLR投稿量突破5万:AI顶会为何持续爆炸式增长
ICLR 投稿编号逼近 5.1 万引发 Reddit 热议。本文分析 AI 顶会投稿量爆炸式增长的原因、对评审系统的压力,以及数字背后的行业信号与反思。