LoCoMo分数波动揭秘:记忆上下文、回答提示与评判者的影响
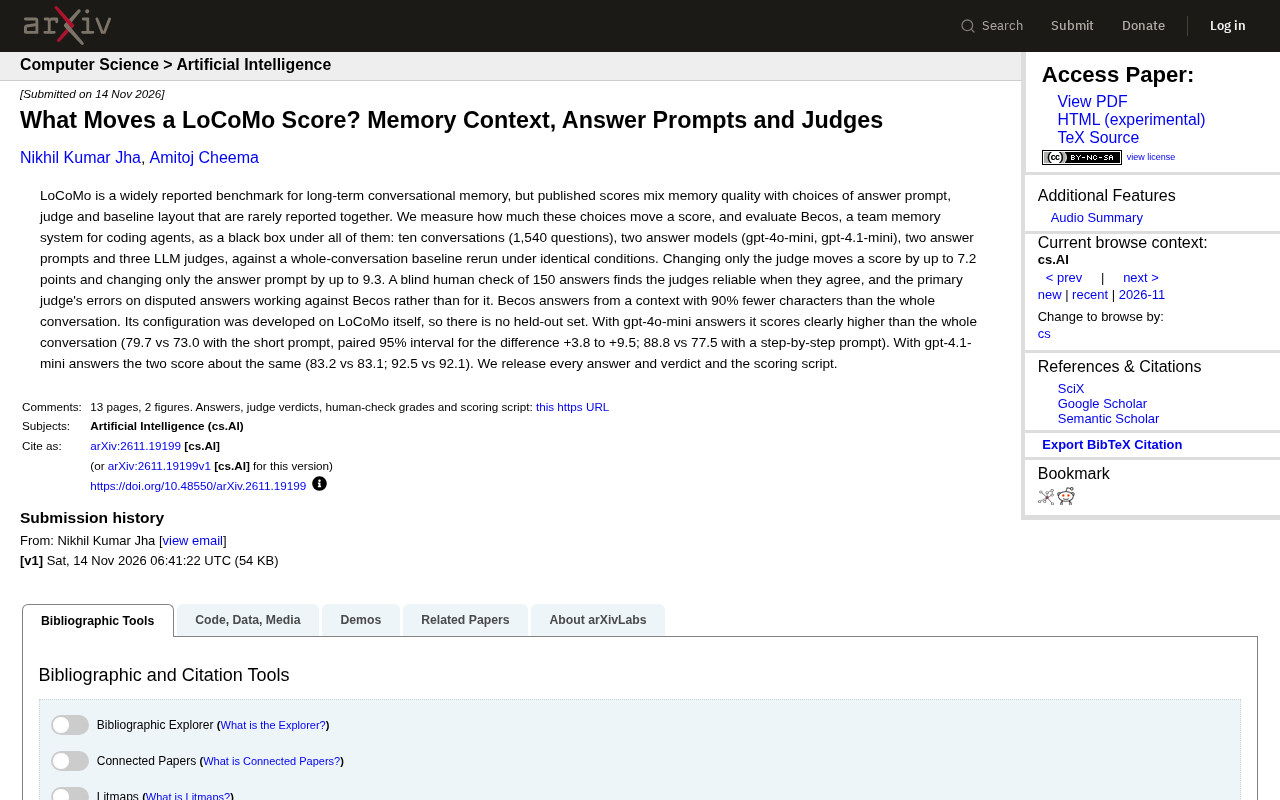
LoCoMo分数受评判者和提示词显著影响,Becos优势依赖模型能力。
一项研究系统评估了LoCoMo基准中评估配置对分数的影响,发现仅更换评判者可使分数波动7.2分,更换回答提示波动9.3分。在控制这些变量后,团队记忆系统Becos在gpt-4o-mini上显著优于全对话基线(79.7 vs 73.0),但在gpt-4.1-mini上优势消失(83.2 vs 83.1)。Becos使用少90%字符的上下文,但其配置在LoCoMo上开发,缺乏留出集。盲人人工检查显示评判者一致时可靠,但主要评判者的错误对Becos不利。研究强调透明报告评估配置的重要性,并发布了所有答案和脚本以促进可复现研究。
引言
LoCoMo 是评估长期对话记忆能力的常用基准,但已发布的分数往往混合了记忆质量、回答提示、评判模型和基线设置等多种因素,而这些设置很少被同时报告。一项新的研究系统地测量了这些选择对分数的影响,并以黑盒方式评估了面向编码智能体的团队记忆系统 Becos。
LoCoMo 基准(Long-term Conversation Memory)是评估对话记忆系统的常用数据集,包含多段长对话及基于对话内容生成的问题,旨在测试模型对长程上下文信息的保持与检索能力。其评估通常涉及生成答案并由 LLM 评判,但不同研究在回答提示、评判模型和基线设置上存在差异,导致分数难以直接比较。
实验设计:多变量控制下的严格评估
研究团队在 LoCoMo 基准上进行了受控实验,使用了 10 段对话(共 1,540 个问题)。他们比较了两种回答模型(gpt-4o-mini 和 gpt-4.1-mini)、两种回答提示(短提示和逐步提示)以及三个 LLM 评判者。同时,他们将 Becos 与在相同条件下重新运行的“全对话”基线进行对比。
这种多变量设计使得研究者能够分离出每个因素对最终分数的独立影响,而不是像通常那样只报告一个综合分数。
多变量控制实验(Multivariate Controlled Experiment)是一种实验设计方法,通过同时操纵多个自变量并控制其他变量,以分离每个因素对因变量的独立影响。在本研究中,研究者独立变化回答模型、回答提示和评判者,从而量化每个因素对 LoCoMo 分数的贡献,避免混淆效应。
关键发现:评判者和提示词足以左右分数
实验结果显示,仅更换评判者就能使分数波动高达 7.2 分,而仅更换回答提示则能带来高达 9.3 分的差异。这意味着,在比较不同记忆系统时,如果不报告这些设置,分数差异可能完全来自评估配置而非系统本身。
此外,一项针对 150 个答案的盲人人工检查发现,当评判者意见一致时结果是可靠的;而在有争议的答案上,主要评判者的错误往往对 Becos 不利,而不是有利。这暗示了自动评判可能存在系统性偏差。
Becos 的表现:上下文效率与模型依赖
Becos 是一个面向编码智能体的团队记忆系统。在实验中,它从比全对话少 90% 字符的上下文中生成答案。需要注意的是,Becos 的配置是在 LoCoMo 本身上开发的,因此没有留出集,这可能导致一定程度的过拟合。
当使用 gpt-4o-mini 作为回答模型时,Becos 显著优于全对话基线:在短提示下得分为 79.7 对 73.0(配对 95% 置信区间为 +3.8 到 +9.5),在逐步提示下为 88.8 对 77.5。然而,当使用 gpt-4.1-mini 时,两者得分相近:83.2 对 83.1(短提示)和 92.5 对 92.1(逐步提示)。这表明 Becos 的优势依赖于回答模型的能力,在更强模型上优势消失。
上下文效率(Context Efficiency)指系统在生成答案时利用的上下文信息量与性能的比率。Becos 仅使用比全对话少 90% 字符的上下文,却能在某些模型上达到或超越全对话基线的性能,表明其记忆机制能高效提取关键信息。然而,这种效率优势可能受回答模型能力影响,在更强模型上差异不显著。
对基准评估的启示
这项研究强调了在报告 LoCoMo 分数时透明地公开评估配置的重要性。不同的评判者、提示词和基线设置可以导致分数差异达到数个百分点,这足以改变系统之间的排名。研究团队发布了所有答案、评判结果和评分脚本,以促进可复现研究。
对于记忆系统的开发者而言,这意味着需要更加谨慎地解读已发表的分数,并在自己的评估中控制这些变量。同时,Becos 的案例表明,在较弱模型上观察到的优势可能无法推广到更强模型,因此评估应涵盖多种模型配置。
评判者偏差(Judge Bias)指自动评判模型在评分时表现出的系统性倾向,可能源于训练数据、提示设计或模型固有偏好。本研究中,盲人人工检查发现主要评判者的错误往往对 Becos 不利,提示自动评判可能引入非对称误差,影响系统比较的公平性。
结论
LoCoMo 分数的波动不仅反映了记忆系统的质量,还深受评估方法的影响。这项研究提供了一个透明的评估框架,并提醒社区关注评判者偏差和提示词设计。随着记忆系统在 AI 应用中的重要性日益增加,建立更稳健的评估标准将成为关键。
相关推荐

Gemini 4 Neon发布:前沿智能与高效任务执行的平衡之作
Google DeepMind 发布 Gemini 4 Neon,主打前沿智能与快速端到端任务执行。本文解析其在编程、企业分析、科学推理与网络安全上的基准表现、四档思考等级、定价与安全对齐数据。

AI是全球断网元凶?NSA、FAA接连宕机背后的信任危机
NSA机密网络五天内第四起重大故障,微软称软件bug、FAA否认新AI系统有关、NSA称例行维护。参议员沃纳提出AI加速漏洞发现导致仓促修复的另一种解释,而39%美国人对AI的负面看法让信任危机浮出水面。

机器人开发者自研B-rep内核,测试达3487项
机器人开发者自研B-rep几何内核并编写3,487项测试,探讨机器人领域为何需要专用CAD工具,以及自研内核的机遇与门槛。