LOOT:让掩码扩散模型学会自我修正

LOOT通过架构创新让掩码扩散模型具备自我修正能力,大幅降低推理成本。
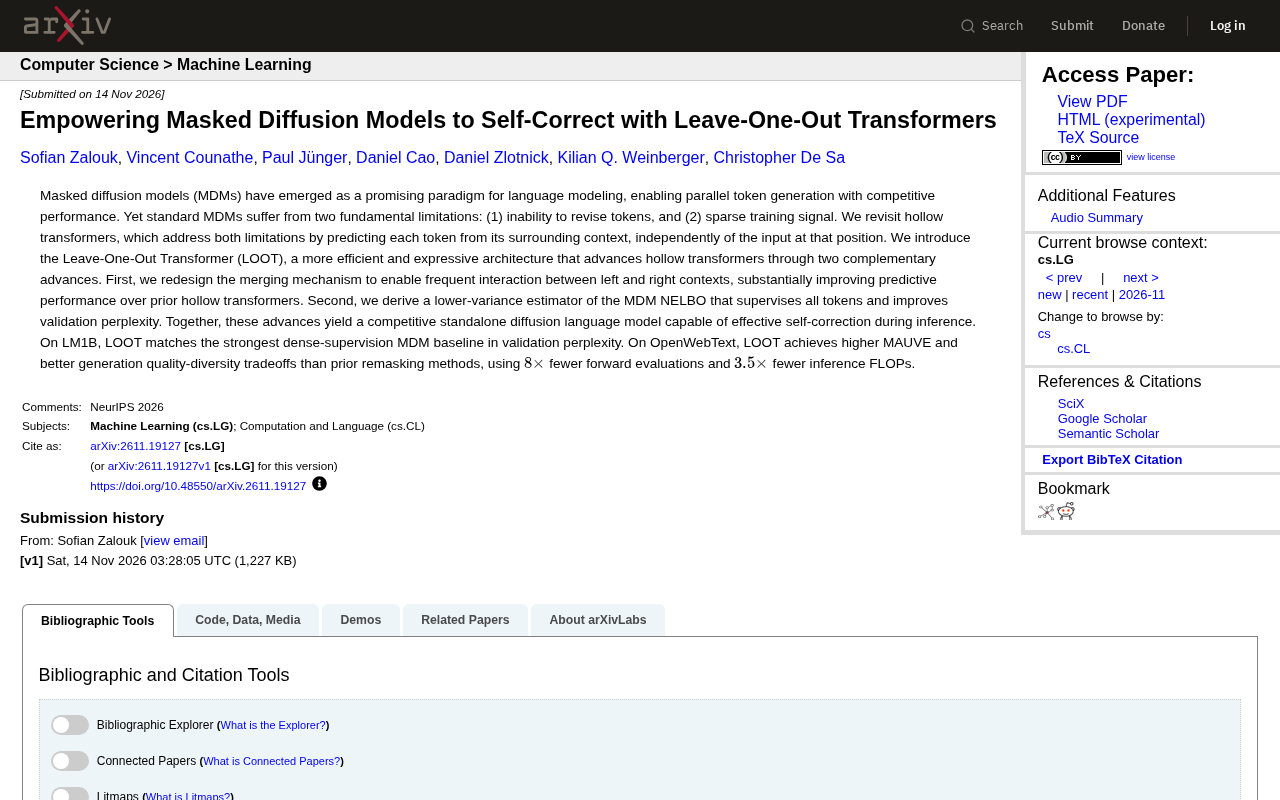
掩码扩散模型(MDM)支持并行token生成,但存在无法修正已生成token和训练信号稀疏两大局限。近期研究提出Leave-One-Out Transformer(LOOT),借鉴空心Transformer的思路,通过重新设计合并机制增强左右上下文交互,并推导低方差NELBO估计器实现全token监督。LOOT将自我修正能力内化到架构中,推理时无需额外前向评估。在OpenWebText上,相比重掩码方法,LOOT的MAUVE更高,前向评估减少8倍,推理FLOPs减少3.5倍;在LM1B上验证困惑度与最强密集监督MDM基线持平。这为扩散语言模型兼顾并行生成与高质量提供了一条新路径。
掩码扩散模型的瓶颈:只生成不修正
掩码扩散模型(Masked Diffusion Models, MDMs)作为语言建模的新兴范式,支持并行 token 生成,性能已能比肩传统自回归模型。但标准 MDM 存在两个根本性局限。
其一,它无法修正已生成的 token——一旦某个 token 被确定,模型就没有机制回头修改。其二,训练信号稀疏,每个训练样本只对部分 token 提供监督。这意味着模型在推理时若出现错误,只能将错就错,无法像人类写作那样反复推敲。
近期一篇研究提出了 Leave-One-Out Transformer(LOOT),试图从架构层面解决这两个问题。
掩码扩散模型(Masked Diffusion Models, MDMs)是一类借鉴扩散模型思想的语言生成模型。与自回归模型逐 token 从左到右生成不同,MDM 在训练时随机掩码部分 token,让模型学习从被掩码的上下文中恢复原始 token;推理时则从全掩码序列出发,通过多轮迭代逐步“去掩码”,每一轮可以并行预测多个位置的 token。这种并行生成能力是 MDM 的核心优势,使其在速度上具有潜力。然而,标准 MDM 的生成过程是单向的:一旦某个 token 被填充,它就会作为已知上下文参与后续预测,模型没有机制回头修改已确定的 token。此外,由于每次训练只对部分被掩码的 token 计算损失,监督信号天然稀疏。这两个问题共同限制了 MDM 在生成质量上的进一步提升。
空心 Transformer 的启示与局限
研究团队回溯了“空心 Transformer”(hollow transformers)的思路。这类架构的核心是:预测某个位置的 token 时,只依赖其周围上下文,而不看该位置本身的输入。这种设计天然支持“自我修正”——因为模型在预测每个 token 时都像是在做填空,可以反复重新预测。
但此前的空心 Transformer 存在效率与表达力不足的问题。左右上下文之间的交互不够充分,导致预测性能受限;同时训练目标的设计也不够理想。
LOOT 在两点上做了改进:重新设计合并机制,让左右上下文能够频繁交互,显著提升预测性能;同时推导出 MDM 负证据下界(NELBO)的低方差估计器,对所有 token 进行监督,改善验证困惑度。
“空心 Transformer”(hollow transformers)是一种特殊的 Transformer 变体,其核心设计是:在预测某个位置的 token 时,该位置的输入表示被置空或屏蔽,模型只能依赖周围位置的上下文进行预测。这种“填空”式的预测方式与掩码扩散模型的目标天然契合,并且为自我修正提供了可能——因为每个 token 的预测不依赖于其当前值,模型可以反复重新预测同一位置而不会受到已生成 token 的干扰。然而,早期的空心 Transformer 存在明显缺陷:左右上下文之间的信息交互不够充分,导致模型难以整合全局信息;同时训练目标的设计不够精细,使得预测性能受限。这些局限促使研究者重新思考架构设计,LOOT 正是在此基础上的改进。
自我修正如何实现
LOOT 的自我修正能力来自架构本身。由于每个 token 的预测都基于周围上下文而非自身输入,模型在推理时可以反复重新评估某个位置的 token——相当于在生成过程中不断“回头检查”。
这不同于传统的重掩码(remasking)方法:后者需要额外的前向评估来逐步替换 token,计算开销较大。LOOT 将修正能力内化到架构中,推理时无需反复调用模型。
论文给出的数据是:在 OpenWebText 上,LOOT 相比先前的重掩码方法,MAUVE 更高、生成质量与多样性的权衡更好,同时前向评估次数减少 8 倍,推理 FLOPs 减少 3.5 倍。
重掩码(remasking)是掩码扩散模型中常用的一种推理策略。其基本流程是:在生成过程中,模型先并行预测多个位置的 token,然后根据某种置信度评分,选择一部分 token 重新掩码,并在下一轮中重新预测这些位置。通过多轮“预测-重掩码-再预测”的迭代,模型能够逐步修正可能错误的 token。然而,这种方法需要额外的模型前向评估来评估和替换 token,计算开销较大,且修正效果依赖于重掩码策略的设计。LOOT 则将修正能力直接内化到架构中,每个 token 的预测都基于周围上下文而非自身输入,因此可以在单次前向过程中反复重新评估,无需额外的迭代调用,从而大幅降低了推理成本。
性能表现与意义
在 LM1B 上,LOOT 的验证困惑度与最强的密集监督 MDM 基线持平。在 OpenWebText 上,它在生成质量与多样性权衡上优于先前的重掩码方法,而计算成本显著更低。
这意味着扩散语言模型不必在“并行生成”与“生成质量”之间做痛苦取舍。LOOT 展示了一条路径:通过更聪明的架构设计,让模型在推理时具备自我修正能力,同时保持计算效率。
对于语言建模领域而言,这提供了一个新视角——修正能力不必依赖外部迭代流程,可以内嵌到模型结构之中。
MAUVE 是一种用于评估开放文本生成质量的自动度量指标,它通过比较生成文本与人类参考文本在分布上的相似度来衡量生成质量。MAUVE 分数越高,说明生成文本在质量和多样性上越接近人类文本。与传统的困惑度(perplexity)指标不同,MAUVE 更侧重于生成文本的整体分布特性,能够同时反映生成质量和多样性。在 OpenWebText 等开放域文本生成任务中,MAUVE 常被用来评估模型生成文本的逼真程度和多样性权衡。LOOT 在该指标上优于先前的重掩码方法,表明其在生成质量与多样性之间取得了更好的平衡。
关键要点
- LOOT 通过重新设计合并机制和低方差 NELBO 估计器,改进了空心 Transformer 的效率与表达力。
- 自我修正能力内化于架构,推理时无需额外的前向评估。
- 在 OpenWebText 上,前向评估减少 8 倍,推理 FLOPs 减少 3.5 倍。
- 在 LM1B 上验证困惑度与最强密集监督基线持平。
相关推荐

Gemini 4 Neon 曝光:或成 Opus 5.5 有力竞争者
Hacker News 讨论帖指出 Gemini 4 Neon 看起来像 Opus 5.5 的竞争者。本文解读这一社区信号背后的产品定位、顶级模型竞争格局变化,以及对开发者模型选型策略的实际意义。

Claude Fable 5.2 独立创作短片《Fable》引热议
Hacker News 上出现由 Claude Fable 5.2 独立完成剧本、画面与导演的短片《Fable》,本文分析全流程 AI 创作的意义、社区反应及对内容创作者的启示。

Anthropic IPO定价:AI巨头上市信号
Anthropic 进行 IPO 定价的消息引发关注。本文分析这一动作对 AI 行业估值、商业化路径和竞争格局的潜在影响,并指出公开市场对 AI 公司的期待与挑战。