LoRA动态秩分配:轻量微调的新优化方向
现有LoRA固定秩的“一刀切”做法存在优化空间,动态秩分配有望兼顾效率与性能。
文章围绕Reddit上一位研究者提出的LoRA优化方向展开:现有LoRA实现通常为所有层手工设定统一的固定秩,这种“一刀切”做法在复杂模型上可能造成某些层参数冗余、另一些层容量不足。动态秩分配的核心是让模型在训练中自动决定每层所需的秩,可基于梯度、损失敏感度或参数重要性等启发式规则,也可引入可学习门控。其收益在于减少冗余参数、降低显存与训练成本,并把容量分配给真正需要的地方,但同时也带来评估信号可靠性、额外计算开销和工具链兼容性等挑战。文章指出该方向已有秩剪枝与自适应分配的前期工作,但原帖想法仍处早期探索阶段,尚无公开实验或代码,作者正公开寻求合作。
为什么LoRA还需要优化
LoRA(Low-Rank Adaptation)已经成为大模型微调的主流方案:它冻结原始权重,只训练一小部分额外参数,从而大幅节省内存和算力,同时保持性能。但Reddit上一位研究者提出的问题值得关注——现有的LoRA实现中,秩(rank)通常是手工设定的固定值,所有层共享同一个秩。这种“一刀切”的做法在复杂模型上可能并不高效:有些层可能需要更高的秩来捕捉复杂模式,而另一些层用低秩就足够了。
这位研究者正在探索一种更干净、更高效的自适应/动态秩分配方案,并公开寻找合作者或讨论对象。虽然帖子本身信息量有限,但它指向了一个真实存在的优化空间。
LoRA 的低秩分解原理:LoRA 将权重更新 ΔW 分解为两个低秩矩阵的乘积 B·A,其中 A 的形状为 r×d、B 为 d×r,r 即秩(rank),通常远小于原始维度 d。前向传播时输出为 Wx + BAx,B 初始化为零、A 随机初始化,因此训练开始时模型行为与原模型完全一致。可训练参数量为 r×(d_in+d_out),当 r 取 8 或 16 时往往只占原参数的 0.1%–1%。秩 r 直接决定了适配器能表达的子空间维度:r 越大容量越强,但参数与显存开销也线性增长。正因为 r 是一个需要人工设定的超参数,且实践中常对所有层统一取值,才产生了“层间容量是否应差异化”的优化空间。

动态秩分配的核心思路
动态秩分配的核心思想是:让模型在训练过程中自动决定每一层(或每个模块)需要多少秩,而不是由人工预设。可能的实现路径包括基于梯度信息、损失敏感度或参数重要性的启发式规则,也可以引入可学习的门控机制。
这样做的好处是双重的:一方面,减少冗余参数,进一步降低显存占用和训练成本;另一方面,把容量分配给真正需要的地方,可能带来性能上的提升。不过,动态调整也引入了新的复杂度——如何稳定地评估“需要多少秩”、如何避免训练初期的不稳定,都是需要解决的问题。
这个方向并非空中楼阁:此前已有工作探索过秩的剪枝与自适应分配,但研究者认为现有方案在简洁性和效率上仍有改进余地。
基于敏感度与重要性的秩分配启发式:判断某层“需要多少秩”,常见做法是估计该层对最终损失的敏感度。例如对每个 LoRA 模块计算梯度范数或 Fisher 信息,敏感度高的层分配更大秩;也可借鉴结构化剪枝中的重要性评分,对奇异值较小的方向进行裁剪,从而实现秩的动态收缩。另一类思路是 AdaLoRA 式的参数化:把增量分解为 Q·Λ·P,通过对奇异值施加稀疏正则让不重要方向的 Λ 趋近于零,等效于自动降低秩。还有研究用可学习的标量门控乘以各秩分量,训练后按门控值剪枝。这些方法的共同点是:把“秩”从离散的手工超参数转化为可由训练信号驱动的连续或可剪枝的量。
值得关注的挑战与开放问题
从研究角度看,动态秩分配至少面临几个挑战。第一是评估信号的可靠性:用梯度或Hessian信息判断秩需求,在训练早期可能噪声很大。第二是计算开销:如果判断秩的过程本身太贵,就抵消了LoRA省算力的优势。第三是与现有工具链的兼容性,比如能否无缝接入常见的微调框架。
此外,社区讨论中常提到的一个开放问题是:动态秩带来的性能增益,是否足以抵消实现复杂度?目前还缺少系统性的对比实验。
Hessian 信息在秩评估中的角色:Hessian 矩阵刻画了损失曲面在某点的曲率,其特征值分布可以反映参数空间各方向对损失的敏感程度。若某层权重更新所在子空间的曲率较大,说明该方向对损失影响显著,可能需要更高秩来精细刻画;反之低曲率方向可被压缩。实践中精确 Hessian 计算代价为 O(n²),通常改用对角近似、K-FAC 或随机迹估计等廉价替代。但这类估计在训练早期参数远离收敛点时噪声很大,容易导致秩分配频繁抖动,因此往往需要 warm-up 阶段、指数滑动平均或分阶段重估等稳定化手段,这也正是动态秩方案落地的主要工程难点之一。
如何参与或跟进
对于感兴趣的研究者或工程师,可以从复现现有自适应LoRA方案开始,建立基线,再尝试简化或改进秩分配策略。原帖作者明确表示希望合作或交流,这类早期研究想法往往在讨论中能更快打磨成型。
需要注意的是,该想法目前仍处于探索阶段,尚无公开的实验结果或代码。关注这一方向的读者可以留意后续进展,或直接与作者联系参与讨论。
相关推荐
在终端里看片:Codex多智能体打造SSH流媒体服务
创作者用Codex多智能体工作流在终端搭建SSH流媒体服务,包含规划、云端异步开发、AI绘制电影场景和同步直播频道,展示AI编程工具如何快速实现个人创意。
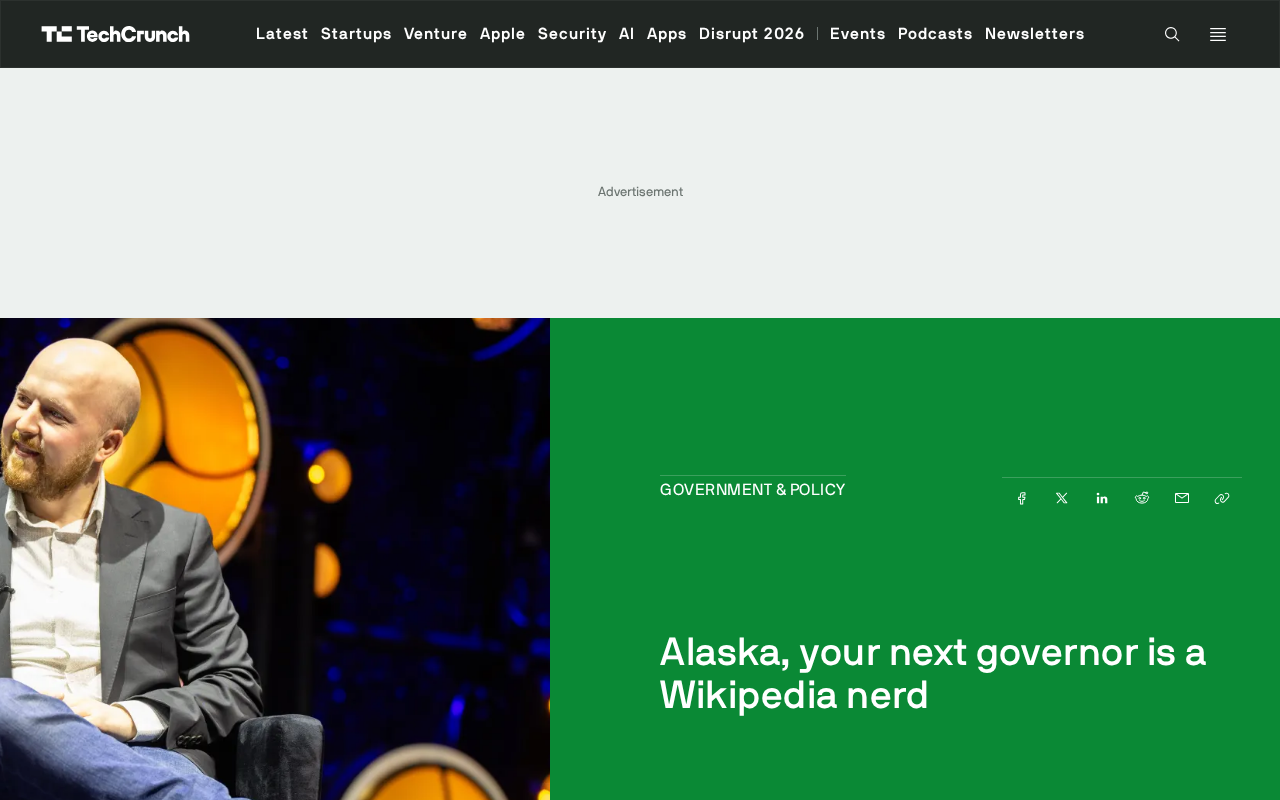
阿拉斯加新州长:一位维基百科资深编辑
阿拉斯加当选州长 Jonathan Kreiss-Tomkins 拥有超过 13,000 次维基百科编辑记录。本文分析这一身份背后的信息素养与协作能力信号,以及对技术从业者的启示。
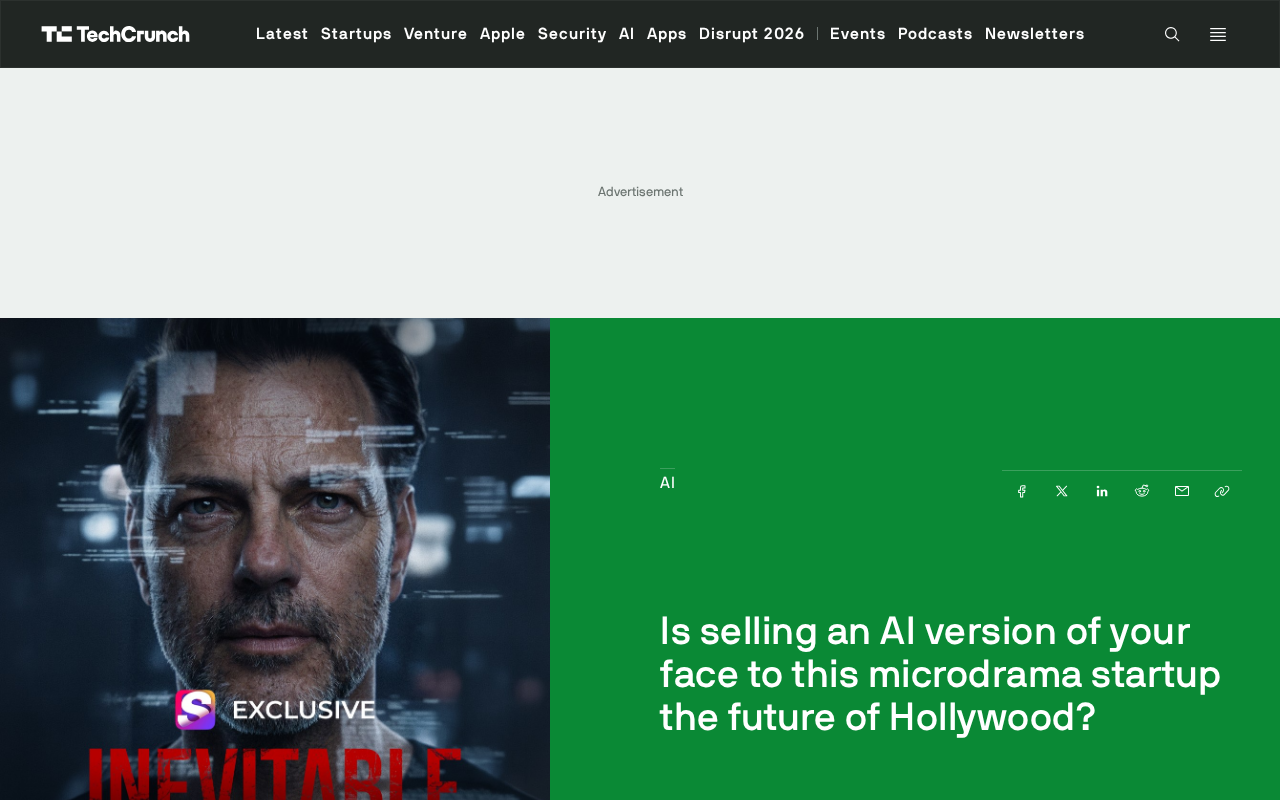
AI卖脸:微短剧新趋势还是好莱坞陷阱?
演员将面部授权给微短剧初创公司,用AI数字分身出演内容。这一模式在中国已流行,专家担忧其进入好莱坞后带来控制权流失、议价能力稀释等长期风险。