#大模型微调
共 25 篇相关文章

Together AI升级微调服务:新增模型、实时监控与精细化控制
Together AI全面升级Fine-Tuning微调平台,新增开源权重模型、Expert LoRA、早停机制、实时实验追踪、分词数据集预览与预检验证,并下调精选模型训练价格,帮助开发者更高效、可控地定制大模型。

微调如何重塑大模型内部机制:表征变化与因果重要性的解耦研究
一篇 arXiv 研究揭示大语言模型微调如何重塑内部机制:表征变化最剧烈的层与真正起因果作用的关键组件并不重合,且跨任务组件重叠不等于性能迁移,甚至可能导致相互干扰。
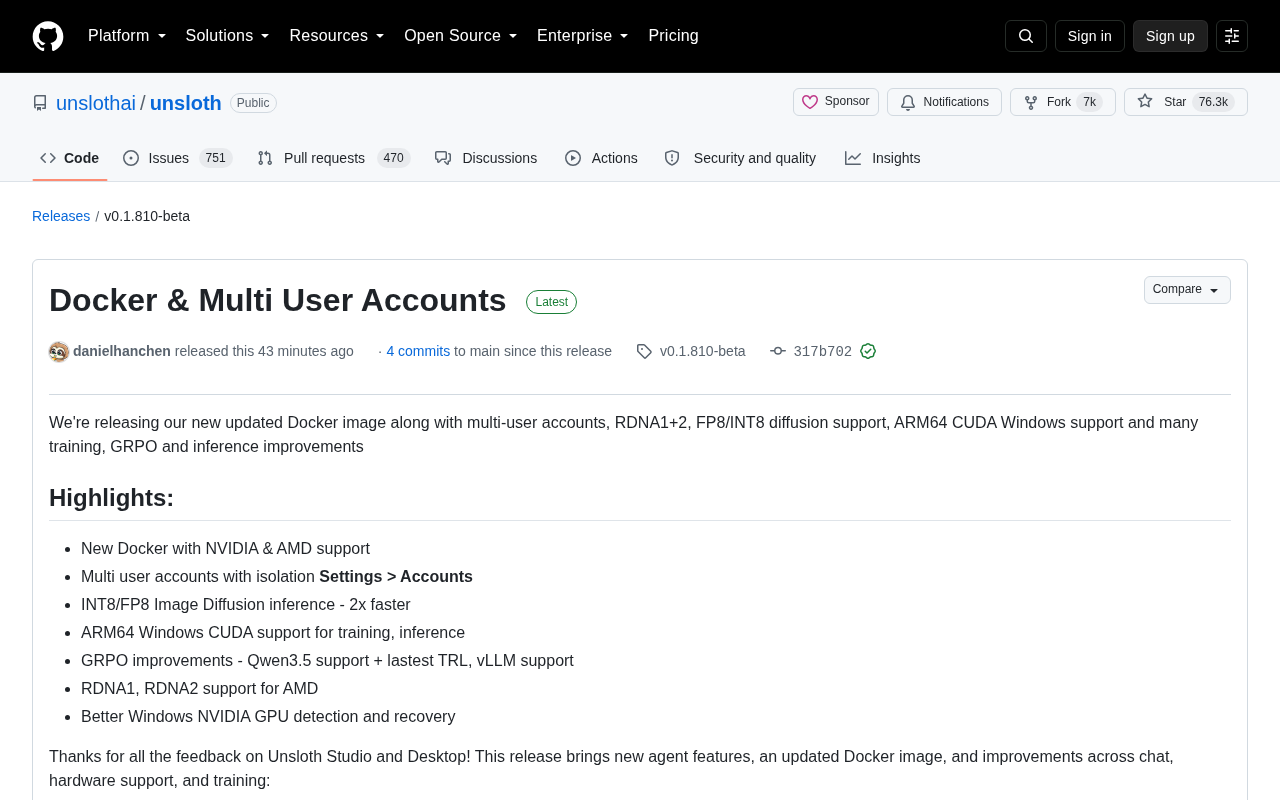
Unsloth 重磅更新:多用户账户、全新 Docker 与 FP8 扩散推理
Unsloth 发布 v0.1.810-beta,带来全新 Docker 镜像、多用户账户隔离、FP8/INT8 扩散推理 2 倍加速、AMD RDNA 与 ARM64 Windows 支持,以及 GRPO 和训练的多项改进。
双非零基础转行AI应用开发工程师,需要哪三项硬实力?
双非零基础想转行AI应用开发工程师需要哪些能力?本文梳理大模型微调实操、LangChain框架开发、模型推理与工程化部署三项核心硬实力,并给出从基础到就业方向的学习路径参考。
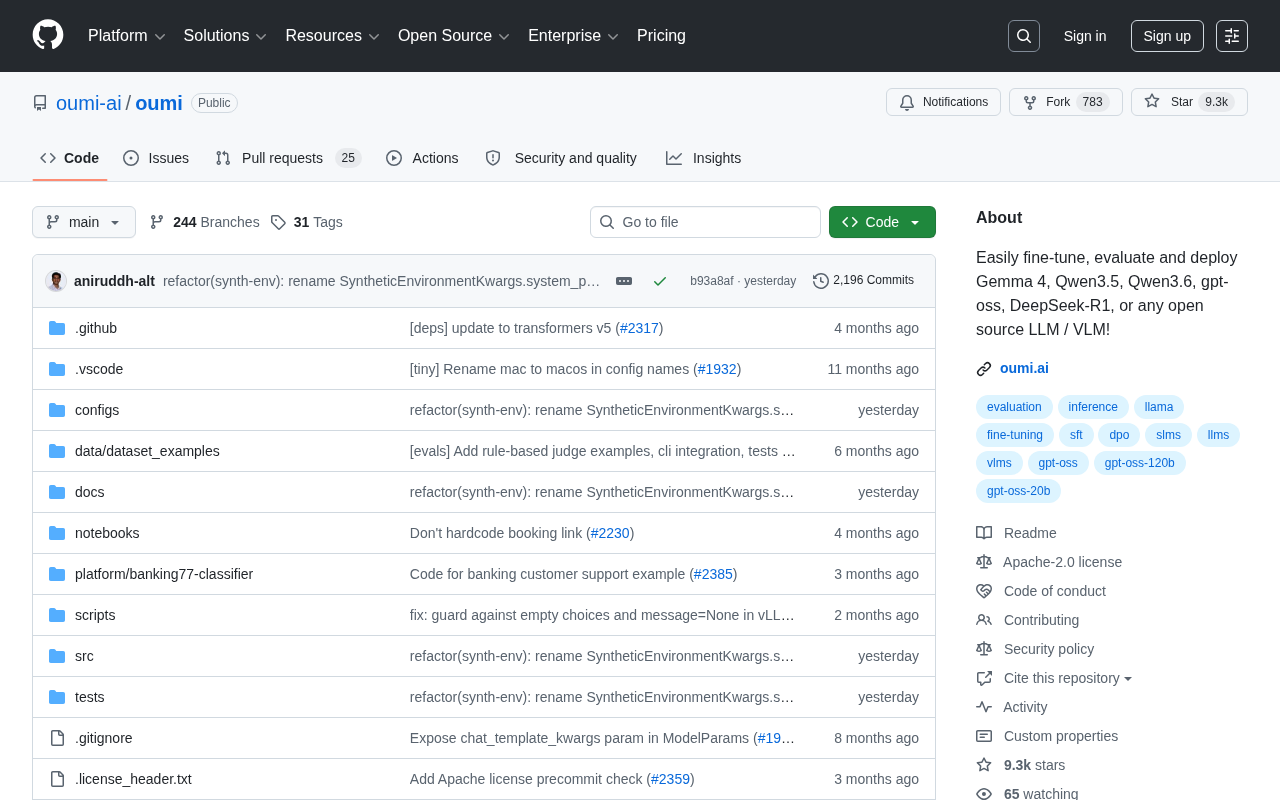
Oumi:一站式开源大模型微调、评估与部署框架
Oumi 是一个开源大模型全流程框架,支持对 Gemma、Qwen、gpt-oss、DeepSeek-R1 等主流开源 LLM 与 VLM 进行微调、评估和部署,帮助开发者用统一工具链降低模型工程化门槛。

Qwen3-27B微调实录:让大模型说出真正的"人话"
开发者基于 Qwen3.8-27B 微调出 Humanlike-Chat 模型,用 12.5 万条真人对话数据训练 rank-256 LoRA,让大模型摆脱"AI助手腔"、说出更自然的人话。本文解析其训练细节、实际效果与能力权衡。
 教程攻略
Agent Tuning:训练具备Agent能力的大模型完整指南
深入解析Agent Tuning的原理与实践,包括为什么需要Agent训练、从Prompt到RAG到Agent的技术演进、研发流程与成本评估,帮助中小模型获得顶级Agent能力实现私有化部署。
 深度解读
大模型训练全流程解析:预训练、SFT微调与偏好对齐通俗详解
详解大模型训练三大核心阶段:预训练、有监督微调(SFT)、偏好对齐(DPO/PPO),涵盖LoRA、模型蒸馏量化剪枝等关键技术,帮助开发者理解从Base Model到Chat Model的完整流程。
 教程攻略
大模型工程师必备技能:应用开发与微调训练完整指南
系统梳理大模型工程师核心技能体系,涵盖RAG、Agent应用开发及SFT、RLHF微调训练两大方向,为Java后端、AI算法工程师及零基础转行者提供清晰的学习路径规划。
 教程攻略
Qwen3-0.6B微调入门:大模型基础概念与微调方法论详解
从大模型三大核心特征讲起,系统梳理Qwen3-0.6B微调所需的基础知识,包括大模型与应用软件的区别、国内外主流模型对比、微调价值分析,以及从原理到实操的完整学习路径。
 教程攻略
4-bit QLoRA微调LLaMA 3实战:消费级GPU训练80亿参数大模型指南
详解如何使用QLoRA和Unsloth框架在消费级GPU上微调LLaMA 3 8B大模型。涵盖4-bit量化、LoRA低秩适配、Alpaca数据格式、训练流水线搭建到模型部署的完整流程,RTX 3090即可运行。
 产品体验
Unsloth:显存优化80%,本地微调大模型的最佳开源工具
Unsloth是GitHub 63K+ Star的开源大模型训练工具,支持Gemma 4、Qwen 3、DeepSeek等主流模型。通过显存优化降低50%-80%显存占用,让RTX 4090也能微调7B模型,提供Web UI一键训练。
 教程攻略
Unsloth教程:本地微调大模型省显存提速5倍
详解Unsloth开源工具如何通过LoRA优化和Web UI界面,让消费级显卡也能高效微调Gemma 4、Qwen3、DeepSeek等主流大模型,训练速度提升2-5倍,显存降低50%-70%。
 教程攻略
Unsloth教程:本地微调大模型速度提升数倍,显存节省60%
Unsloth是GitHub 63K星标的开源大模型微调工具,支持Gemma 4、Qwen3、DeepSeek等模型。通过底层内核优化实现训练加速数倍、显存大幅降低,消费级GPU即可完成微调,提供Web UI图形界面,适合个人开发者和企业私有化部署。
 产品体验
Cube Studio:腾讯开源一站式AI平台,MLOps全流程深度解析
深度解析腾讯音乐开源的Cube Studio云原生AI平台,涵盖Notebook开发、Pipeline编排、分布式训练、大模型微调、推理部署及国产化适配等核心能力,助力企业快速构建MLOps全流程基础设施。
 教程攻略
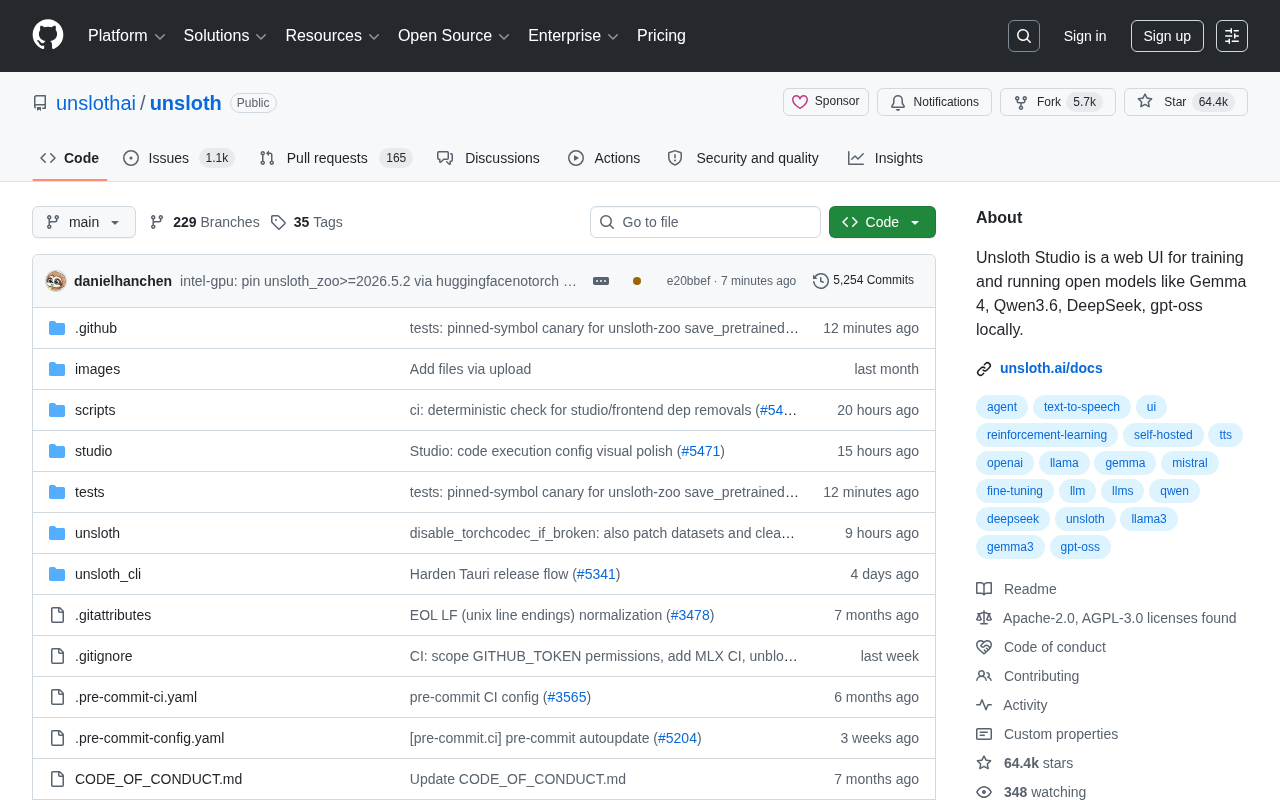
Unsloth教程:本地微调大模型省显存加速训练指南
详解Unsloth开源工具如何在本地高效微调大模型,支持Gemma 4、Qwen3、DeepSeek等主流模型,通过LoRA优化显著降低显存占用,提供Web UI界面降低训练门槛,适合个人开发者和中小团队使用。
 产品体验
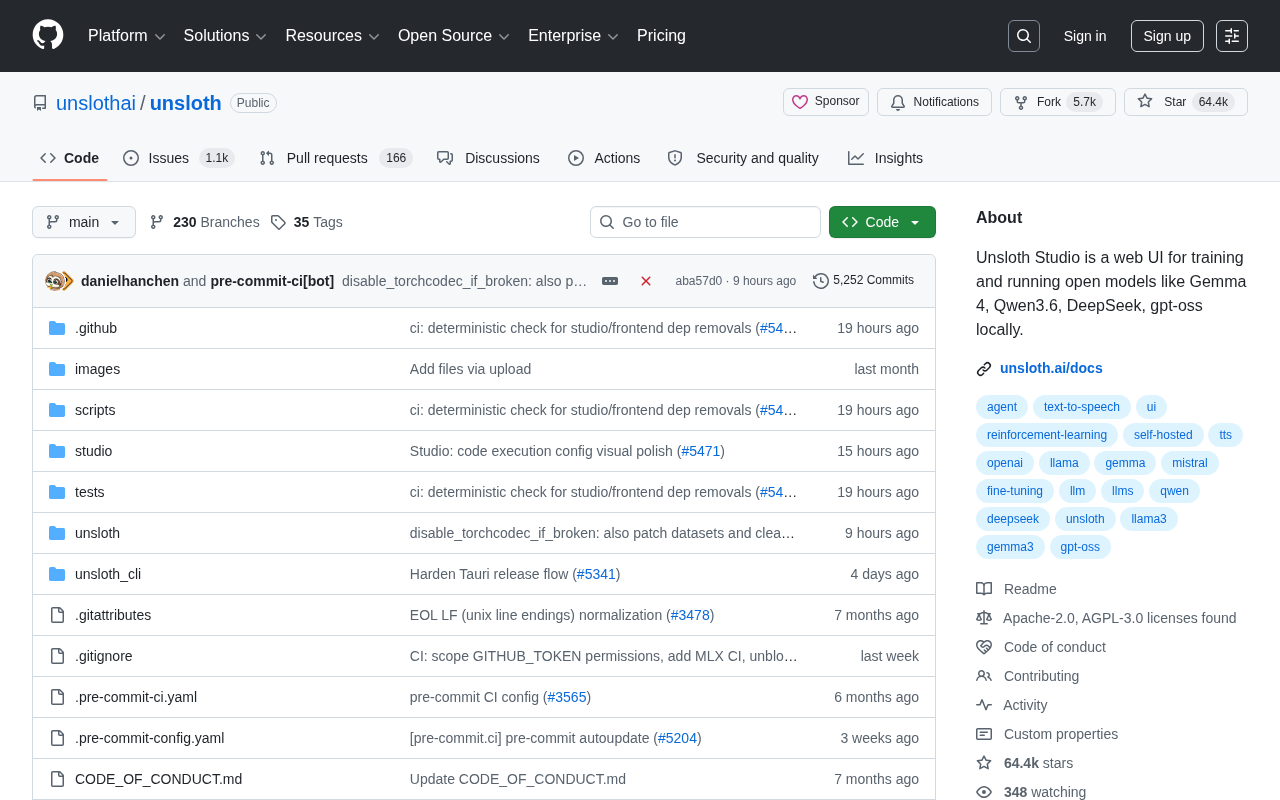
Unsloth:本地微调大模型的高效开源工具
Unsloth是GitHub上超63000星的开源项目,提供Web UI界面支持本地训练和微调Gemma 4、Qwen3、DeepSeek等主流大模型,大幅降低硬件门槛和技术难度,适合个人开发者和企业私有化部署。
 产品体验