Lossless-memory:一款拒绝摘要的AI永久记忆系统
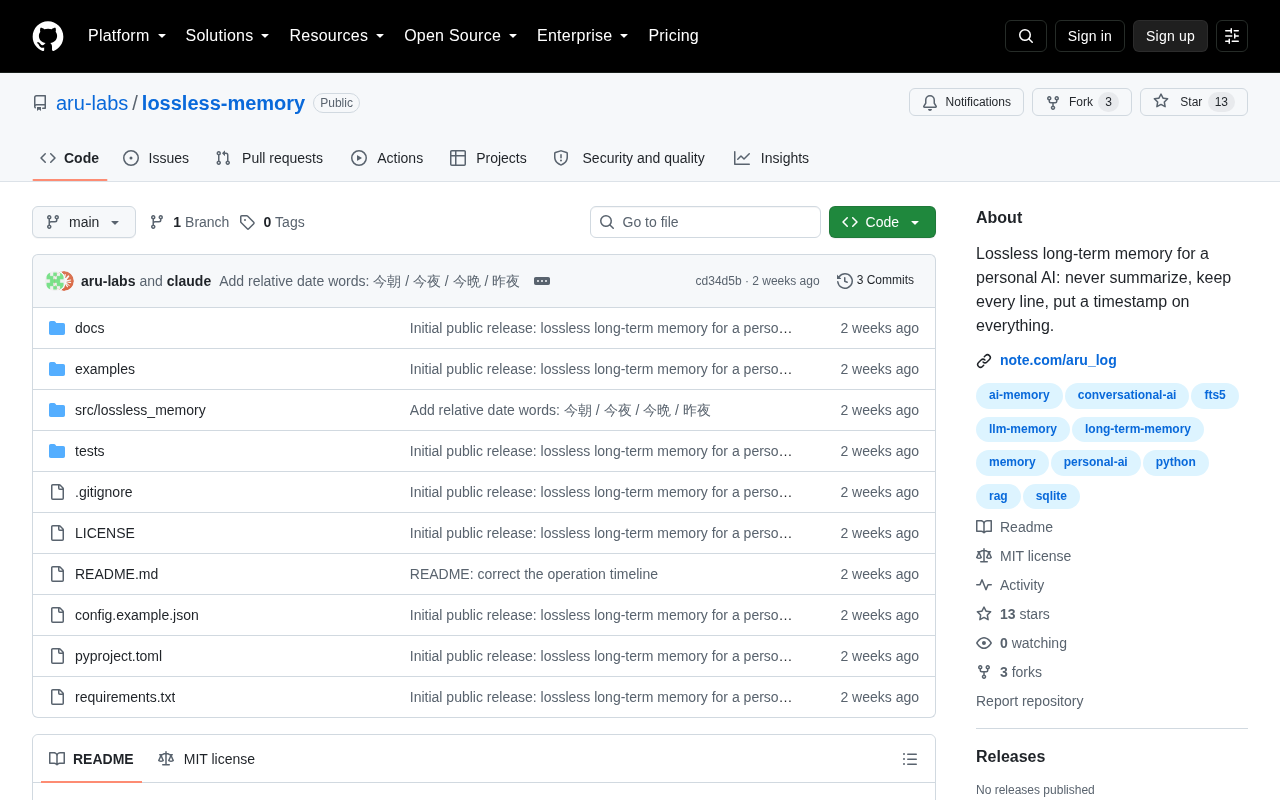
Lossless-memory主张永不摘要、无损保留原始记忆,与主流压缩方案形成对照,但关键技术细节尚未披露。
Lossless-memory是一款面向个人用户的AI记忆系统,其核心理念是彻底放弃摘要压缩,完整保留原始交互信息。相比主流方案以牺牲细节换取存储效率的做法,它将信息保真度置于首位,认为那些当时看似无关紧要的细节日后可能至关重要。个人化定位使其成本压力相对可控,也更契合用户对长期个性化记忆的真实需求。然而,该项目目前公开信息有限,如何解决无损存储带来的检索效率问题、如何在有限上下文窗口内精准调取相关片段,以及隐私保护方式等关键问题均尚未披露。"永不摘要"是一个有价值的设计理念,但能否在工程实践中站稳脚跟,仍有待验证。
一个反直觉的记忆思路:永不摘要
在Hacker News的Show HN板块,一个名为Lossless-memory的项目引起了关注。它的定位十分明确——一个为个人使用打造的AI记忆系统,其最大的特点在于"从不进行摘要"(never summarizes)。这与当前主流的AI记忆方案形成了鲜明对比。
目前市面上大多数AI记忆或长上下文管理方案,都依赖"压缩"和"摘要"来应对上下文窗口的限制。当对话或文档积累过多时,系统会自动生成摘要,用更短的文本替代原始内容。这种做法虽然节省了token和存储,却也带来了不可逆的信息损失。Lossless-memory的名字本身就点明了它的核心主张:记忆应当是无损的。
为什么"无损"值得关注
摘要式记忆的问题在于其"有损"本质。一旦AI将原始交互压缩成摘要,那些当时看似无关紧要、日后却可能变得关键的细节就永久丢失了。对于个人助理类应用来说,这种损失尤其令人困扰——你可能无法预知哪句随口提到的偏好、哪个被一笔带过的背景信息,会在未来的某次对话中变得至关重要。
无损记忆的思路是保留完整的原始信息,在需要时通过检索机制精准调取相关片段,而非依赖预先压缩好的摘要。这本质上是在"存储成本"与"信息保真度"之间做出了偏向后者的权衡。对于重视长期个性化体验的用户而言,这种取舍具有实际吸引力。
从技术角度看,目前主流的有损记忆方案通常采用两种路径:一是直接调用大语言模型生成摘要文本,以较短的叙述替代原始对话;二是将文本编码为向量嵌入(vector embedding)后存入数据库,检索时通过语义相似度召回相关片段。后者虽然保留了原始文本,但向量化本身也是一种有损变换——语义压缩的过程中,措辞细节、情绪语气、语境关联等信息都可能部分流失。Lossless-memory声称的"无损",从工程实现角度来看,最直接的做法是存储完整原始文本,并在检索阶段依赖全文匹配或混合检索策略来定位内容,而非依靠摘要或单一向量来代理原始信息。这使得存储空间与检索延迟成为该方案面临的两个核心工程瓶颈。
个人化定位的意义
值得留意的是,该项目将自己定义为"personal AI memory",即面向个人用户的记忆系统。这个定位有其合理性:个人场景下的数据量相对可控,采用无损存储的成本压力小于企业级海量数据场景。同时,个人助理对记忆连续性和准确性的要求往往更高——用户希望AI真正"记得"自己,而不是记得一份被反复压缩、逐渐失真的自我画像。
这类工具反映出AI应用领域一个持续的探索方向:如何让AI拥有真正持久、可靠的长期记忆,而不仅仅是单次会话内的临时上下文。
客观看待:信息尚有限
需要如实说明的是,这条Show HN帖子目前的公开信息相当有限。截至记录时,该项目获得8个点赞,且尚无评论讨论,社区反馈还不充分。原始素材中也未提供具体的技术实现细节,例如它如何解决无损存储带来的检索效率问题、如何在不摘要的前提下匹配有限的模型上下文窗口,以及数据的隐私与本地化处理方式等。
这些恰恰是评判一个无损记忆方案是否可行的关键。理论上"永不摘要"听起来很美好,但实际落地时,如何在海量原始记忆中快速、准确地找到相关内容,是一个不小的工程挑战。感兴趣的开发者不妨保持关注,等待作者披露更多架构与实测数据后再做深入评估。
上下文窗口限制是无损记忆方案必须正面应对的根本性约束。当前主流大语言模型的上下文窗口通常在8K到200K token之间,即便是最长的窗口,也无法容纳数月甚至数年积累的完整对话记录。因此,"永不摘要"并不意味着每次推理时都将全量记忆塞入上下文,而是意味着系统在检索阶段需要足够精准,只将真正相关的原始片段注入模型的当前上下文——这本质上是一个检索增强生成(RAG, Retrieval-Augmented Generation)的架构问题。RAG的检索质量直接决定了无损记忆的实际效果:如果检索召回了错误的片段,完整保存的原始信息也无法被有效利用。这正是该项目最需要披露技术细节的环节。
小结
Lossless-memory代表了AI记忆设计中一种值得探讨的理念——用无损换取保真。在摘要式方案成为主流的当下,它的"反其道而行"提供了一个有价值的对照视角。不过,从一个概念到真正好用的产品之间,还有检索性能、成本控制、隐私保护等诸多问题需要验证。它是否能在实践中站稳脚跟,仍有待时间和社区检验。
相关推荐

AI温和派的崛起:在狂热与末日论之间寻找中间地带
AI舆论正陷入加速主义与末日论的两极撕裂,但一群"AI温和派"正在崛起。本文梳理福山、"AI作为常规技术"作者及好莱坞制片人卡森伯格的最新观点,呈现在狂热与恐惧之间寻找中间地带的思潮。
我让Claude构建可漫步的物理精确O'Neill圆柱:AI生成3D模拟的边界
我让Claude构建可漫步的物理精确O'Neill圆柱:AI生成3D模拟的边界
一位开发者让Claude构建物理精确、可实时漫步的O'Neill圆柱太空栖息地模拟。本文解析其中的科里奥利力、重力梯度等物理挑战,以及AI生成交互式3D模拟的现实意义与局限。

破解数据锁定:用REGISTER与UNREGISTER API实现目录可移植性
湖仓架构下,开放表格式解决了存储可移植性,但目录锁定成为新难题。本文解析REGISTER与UNREGISTER API如何实现元数据松耦合,帮助企业避免厂商绑定、支持多目录协作并安全迁移数据。