LTX2.5开源本地部署实测:AMD显卡最低8G显存跑视频生成
AMD 7900XTX 在 Windows 11 上本地跑通 LTX2.5,文生视频最快 2 分钟,8G 显存即可入门。
开源视频生成模型 LTX2.5 支持文生视频、图生视频及首尾图生视频等多种模式,官方最低只需 8G 显存。B站UP主林萌通过 AMD 7900XTX(24G 显存)+ Windows 11 的组合完成本地部署实测,证明 A 卡用户无需切换 Linux 系统即可使用。实测效率方面,文生视频 8 步约 2 分钟、图生视频优化至 6 步约 3 分钟、首尾图生视频约 5 分钟,均可生成 5 秒视频。作者提供五套工作流,并认为自建工作流在效率和效果上均优于官方原版;部署上提供整合包(新手开箱即用)和便携版 ComfyUI 手动安装(进阶用户避免环境冲突)两条路径。
开源视频生成模型 LTX2.5 发布后,围绕它的本地部署热度迅速升温。B站UP主林萌带来了一份针对 AMD 显卡与 Windows 11 环境的实测教程,用一块 7900XTX(24G 显存)跑通了整套流程。这份实测的价值在于——它验证了 LTX2.5 并非英伟达独占,A 卡用户同样可以本地部署并获得不错的生成效率。
LTX2.5 是什么,为什么值得关注
LTX2.5 是最新开源的视频生成模型,支持文生视频、图生视频以及首尾图生视频等多种模式。相比闭源云端服务,它最大的吸引力是可以完全本地运行,不受额度和网络限制。
据这位 UP主的实测介绍,该模型对硬件的门槛比想象中低:官方标称最低支持 8G 显存即可运行,虽然低显存下效率会下降,但可用性得到了保证。这一点对于大量中端显卡用户意义重大——过去多数高质量视频生成模型动辄要求 16G 甚至 24G 显存,8G 起步大幅拉低了尝鲜的成本。
值得强调的是,这次实测的核心突破是 AMD + Windows 11 的组合。作者明确提到,之所以坚持在 Win11 而非 Linux 上部署,是因为普通用户不可能"为了跑个模型就把自己日常的系统换掉"。这种从实际使用场景出发的思路,让教程更贴近普通玩家的真实需求。
LTX2.5 基于扩散变换器(Diffusion Transformer,DiT)架构,这是近两年视频生成领域的主流技术路线,相比早期基于 UNet 的架构,DiT 在处理时序一致性和长程依赖方面更具优势。所谓"首尾图生视频"模式,是指同时提供第一帧和最后一帧图像,让模型在两帧之间"补间"出自然的过渡动画,这一功能在制作特定镜头转场或人物动作时尤为实用。
另一个值得了解的背景是 AMD 显卡在 AI 推理领域的生态处境:英伟达的 CUDA 是目前深度学习框架的事实标准,大多数模型默认针对 CUDA 优化。AMD 的对应方案是 ROCm(Radeon Open Compute),但其 Windows 支持长期滞后于 Linux,导致大量 A 卡用户在 Windows 下部署 AI 模型时遭遇兼容性障碍。此次实测能够跑通,意味着该工作流已找到在 Windows ROCm 环境下正确调用 AMD GPU 的方法,这正是其对 A 卡用户最核心的参考价值所在。
实测效率:从 2 分钟到 5 分钟的区间
这份评测最有参考价值的部分是不同工作流下的生成效率对比。测试环境为 7900XTX 24G 显存、32G 物理内存、128G 虚拟内存的 Windows 11 系统。
- 文生视频(自建工作流,8步):生成 5 秒视频耗时约 129 秒,即 2 分钟出头;
- 图生视频(8步):约 5 分钟(317 秒),比纯文生视频慢约 2 分钟;
- 图生视频优化到 6 步:耗时降至约 3 分钟(232 秒),画质、音频依旧正常;
- 首图+尾图生视频(6步):约 5 分钟(306 秒);
- 官方原版改的图生视频工作流:约 5 分钟(259 秒),但作者评价"效果较差"。
作者反复强调步数与质量、效率之间的权衡关系:默认 8 步质量最稳,若追求速度可降到 6 步甚至 4 步。他的实测结论是——在保证音频和画面不损坏的前提下,6 步是较优的平衡点,4 步理论上可把生成时间压到 2 分钟左右。
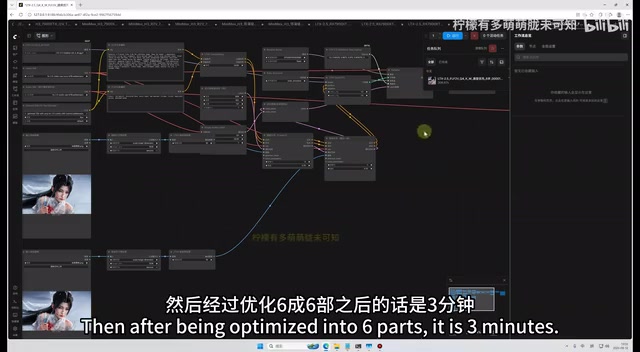
从生成效果看,作者对图生视频的人脸表现给出了肯定:"脸部完全没有变形,说话也正常,音频也正常",纯文生视频则被形容为"电影级"效果,只是 5 秒时长偏短,画面尚未完全展开。
五套工作流的差异
作者一共提供了五套工作流,涵盖不同使用场景:
文生视频工作流
填写提示词控制生成内容,另设约束词防止手脚变形,可调分辨率和步数。这是效率最高的一套,8 步约 2 分钟。
图生视频工作流
上传一张图片,配合提示词和约束词生成动态视频。适合让静态人物图"开口说话",是人脸一致性表现较好的场景。
首尾图生视频工作流
同时上传首帧和尾帧图片,通过提示词控制中间过渡。
官方改版工作流
基于官方原版修改,但作者直言效率慢、效果差,仅作对照。他认为自建工作流通过简化和加速节点、去掉拖慢速度的环节,才是"最优效果"。
这种对官方工作流的批评,反映出开源模型生态中一个常见现象:官方默认配置往往偏保守,社区二次优化的工作流在实际体验上可能更佳。
部署方式:整合包 vs 手动安装
针对不同水平的用户,作者提供了两条路径。
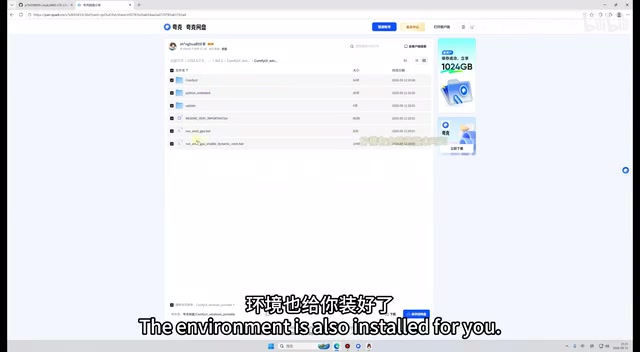
整合包路线(推荐新手):从 GitHub 下载打包好的整合包,模型和环境已全部预装,解压后运行启动程序即可,网页会自动打开本地地址,把工作流拖进去就能用。作者特别说明整合包不再压缩,需要单独文件的高手可以直接取用。
手动部署路线(面向进阶用户):
- 下载便携版 ComfyUI(非安装包版,避免装入用不上的英伟达组件干扰 AMD 环境);
- 解压后先测试能否正常运行;
- 通过 CMD 进入目录,用命令安装所需的两套环境(前提是已安装 Git);
- 每装完一个环境重启 ComfyUI;
- 下载五个模型文件,分别放入 diffusion_models、text_encoders、音频相关等对应目录;
- 加载工作流即可开始生成。
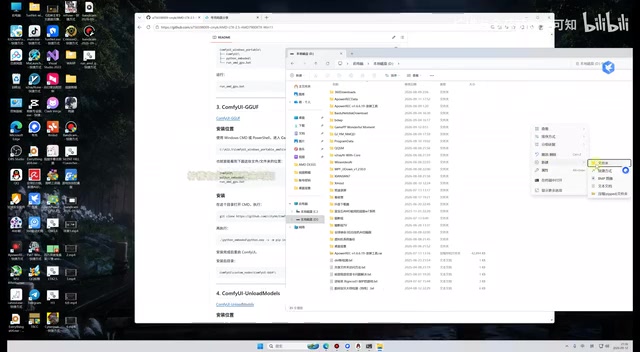
作者提到一个实用的经验:他讲解的每个大模型部署都使用便携版且相互独立,不会与此前部署的其他模型(如 2.3 版本或 MiniMax 相关模型)产生环境冲突。这种"独立开"的做法能有效避免多模型共存时常见的依赖打架问题。
关于硬件兼容性,作者提到理论上 60 系、70 系、90 系英伟达显卡都可使用,而更老的架构(如 580)则无法运行。AMD 一侧则以 7900XTX 完成了实测验证。
ComfyUI 是目前最主流的开源 AI 图像/视频生成前端框架,采用节点式可视化编程界面,用户可以把模型加载、采样器、图像编解码等各功能模块以"节点"形式连接成"工作流",灵活组合而无需编写代码。"便携版"(Portable Version)与安装版的区别在于:便携版将 Python 运行环境和依赖库全部打包在同一目录内,不写入系统注册表,可以多份共存且互不干扰,也方便整体迁移或删除。这正是作者推荐便携版的原因——安装版默认集成了英伟达相关组件,在纯 AMD 环境下可能引发冲突或产生无谓的报错,而便携版可以只装 ROCm 对应的依赖,保持环境干净。
总体评价
这份教程的最大意义在于填补了 AMD + Windows 本地部署 LTX2.5 的空白。对于手持 A 卡、又想在不改动日常系统的前提下尝鲜本地视频生成的用户来说,2 到 5 分钟生成 5 秒视频的效率已经相当可用,8G 显存的门槛也让更多设备有了尝试的可能。
需要留意的是,本文数据均来自单一 UP主 的实测,尚未有多方交叉验证;生成时长与显卡型号、显存大小强相关,低配设备的实际体验可能明显慢于 7900XTX。若你追求稳定质量,建议从 8 步起步再逐步下调;若优先速度,则可尝试 4 到 6 步的配置。
相关推荐
Cursor 3.0 完整入门指南:从零上手 AI 编程 IDE
Cursor 3.0 完整入门教程:从下载安装、创建项目到并行子代理、云端开发、技能与自动化等高级功能。零基础也能上手这款 AI 编程 IDE,掌握模型选择、设计模式与 Git 版本控制的实用技巧。
Codex+Playwright封装测试Skill:UI自动化不再手敲命令
把 Playwright 封装成 Codex Skill,让 AI Agent 通过自然语言完成 UI 自动化测试。本文详解安装加载、Sauce Demo 实战、PO 分层模板,以及 MCP 与 CLI+Skill 的选型对照。
用Obsidian+AI智能体复刻2999元「得到大脑」全功能
用免费的Obsidian笔记软件搭配AI智能体,如何复刻年费2999元的得到大脑专家版?本文拆解发芽、点评、拷问、风格打磨、审稿、排版等核心功能的skills实现逻辑,助你搭建数据本地化、自由扩展的个人AI知识管理系统。