M4 Max实测Qwen 27B:本地模型的tokens/s背后真相
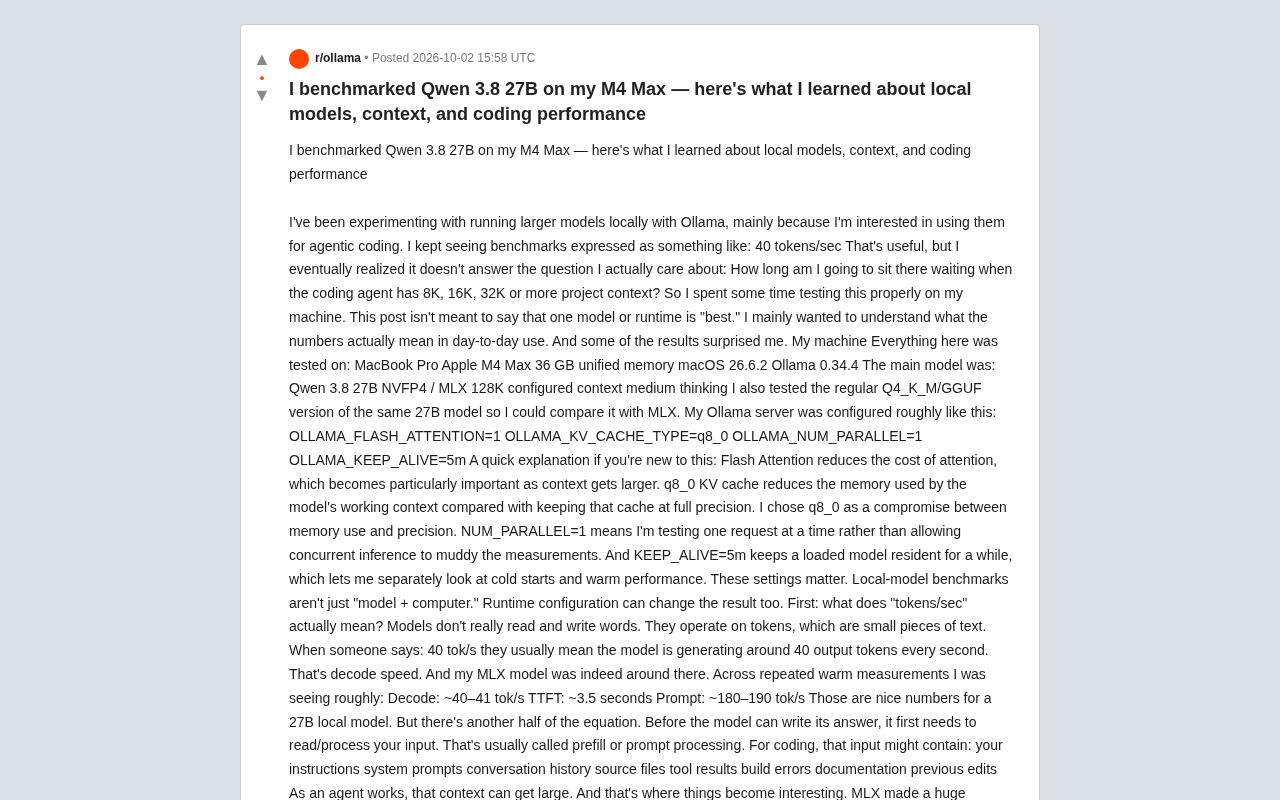
别只看tok/s:实测M4 Max上大上下文让本地模型等待时间从23秒暴增至21分钟。
一位开发者在M4 Max MacBook Pro上对Qwen 27B进行了系统性测试,发现广泛引用的"40 tok/s"解码速度只是本地模型性能的一半真相。真正决定编码体验的是TTFT(首个token延迟)和提示处理速度:随着上下文从4K扩展到30K,生成前等待时间从23秒升至3分15秒;推至115K时需等约21分钟。此外,MLX/NVFP4格式相比GGUF/Q4_K_M在Apple Silicon上解码速度快约3.8倍,大上下文还会对36GB统一内存造成显著压力,引发交换并进一步拖慢性能。作者据此开源了CLI基准工具Devbits Ollama Bench,专门测量上下文扩展下的TTFT与内存压力,帮助用户做出更符合实际使用场景的模型选择。
为什么40 tok/s这个数字在骗你
很多人在选择本地大模型时,只盯着一个数字:每秒多少token。某个模型跑出40 tok/s,听起来相当不错。但一位Reddit开发者在自己的M4 Max MacBook Pro上做了一轮系统性测试后发现,这个数字其实回答不了真正重要的问题——当编码助手要处理8K、16K、32K甚至更多项目上下文时,你到底要等多久?
这位开发者的测试平台是搭载Apple M4 Max、36GB统一内存的MacBook Pro,系统为macOS 26.6.2,运行Ollama 0.34.4。主力测试模型是Qwen 27B(NVFP4/MLX格式,配置128K上下文,中等思考强度),同时对比了同一模型的Q4_K_M/GGUF版本。
他的测试并非要评判哪个模型或运行时「最好」,而是想弄清楚这些基准数字在日常使用中到底意味着什么。结果,有些数据确实出人意料。
tokens/sec只讲了故事的一半
模型不是真的在读写单词,而是处理token——文本的小片段。当人们说「40 tok/s」时,通常指的是模型每秒生成约40个输出token,也就是解码速度(decode)。在反复的热测量中,MLX版本的Qwen 27B确实稳定在约40–41 tok/s。
但在模型写出答案之前,它必须先读取和处理你的输入,这一步叫**预填充(prefill)**或提示处理。对编码场景而言,这部分输入可能包含系统提示、对话历史、源文件、工具结果、构建错误、文档、之前的修改等等。随着智能体工作推进,上下文会越来越大。
因此,衡量本地模型的真实体验,至少需要三个维度:
- Prompt processing(提示处理):模型消化上下文有多快
- TTFT(首个token延迟):真正开始生成前要等多久
- Decode(解码):开始后生成有多快
作者特别强调,TTFT对本地编码模型尤其关键——一个号称40 tok/s的模型完全可能让你在大型上下文下等上三分钟才看到第一个字。
MLX在Apple Silicon上带来近4倍提升
在研究上下文扩展之前,作者先对比了两种量化格式的解码性能,差距相当惊人:
| 模型格式 | 解码速度 |
|---|---|
| Q4_K_M / GGUF | ~10.7 tok/s |
| NVFP4 / MLX | ~40–41 tok/s |
约3.8倍的解码吞吐差距。Q4_K_M版本并没有坏,它能正常工作,但体验天差地别。在约10 tok/s下,一段长编码响应可能要几分钟才能生成完。作者实测让非MLX模型生成一个Next.js/Tailwind/Framer Motion落地页,整个任务等了大约18分钟。
需要澄清的是,MLX是Apple为自家芯片和统一内存架构设计的机器学习框架,它不是另一种Qwen架构,而是模型在机器上的表示/执行方式。NVFP4和Q4_K_M描述的也是权重格式/量化方案,而非不同的模型架构。在这台Apple Silicon机器上,MLX是极其显著的改进。
MLX是Apple于2023年底开源的机器学习框架,专为Apple Silicon(M系列芯片)的统一内存架构设计。与传统的CPU+独立GPU方案不同,Apple Silicon让CPU、GPU和神经网络加速器(ANE)共享同一块物理内存,无需在显存和系统内存之间复制数据。MLX正是利用这一特性,让张量运算可以在不同计算单元间无缝调度,从而大幅减少内存带宽瓶颈。
NVFP4是一种4位浮点量化格式,而Q4_K_M是llama.cpp生态中常用的4位整数量化方案(GGUF容器格式)。两者压缩率相近,但在Apple Silicon上,MLX针对统一内存的访问模式做了深度优化,能更充分地利用GPU的内存带宽。这解释了为何同等参数量的模型,仅因运行时和量化格式不同,就能产生近4倍的解码速度差异——瓶颈不在算力,而在内存带宽的利用效率。
上下文越大,等待越久
这才是作者真正想搞懂的编码场景核心。他没有只测微型提示,而是分别测试了约4K、8K、16K、32K的活跃输入:
| 活跃输入 | 生成前等待 | 提示处理 | 解码 |
|---|---|---|---|
| ~4K | 23.6秒 | 198 tok/s | 46.6 tok/s |
| ~8K | 46.8秒 | 178 tok/s | 41.4 tok/s |
| ~16K | 1分30秒 | 176 tok/s | 30.8 tok/s |
| ~30K | 3分15秒 | 157 tok/s | 31.9 tok/s |
这张表比原始的40 tok/s数字信息量大得多。在8K时等约47秒开始生成,视任务而定可能完全可接受;到16K已经要等一分半;到30K则要等三分多钟。
关键在于:在30K时模型仍以约32 tok/s解码——如果只报告解码速度,听起来还不错。但作为用户,你在这之前已经等了三分钟。
这也带出一个常被混淆的概念:配置的上下文容量不等于当前占用的上下文。你可以配置128K却只用8K。把上下文窗口想象成模型可用的桌面大小——128K的大桌子不代表你已经铺满了文件,但如果真塞进10万token的文档,模型要处理的材料就多得多。
预填充阶段(prefill)的计算复杂度与输入长度呈近似线性关系,但KV缓存(Key-Value Cache)的内存占用则随上下文长度线性增长。KV缓存是Transformer架构的核心机制:模型在处理每个token时,会把当前层的注意力键值对存入缓存,以避免后续生成时重复计算。上下文越长,KV缓存越大,不仅占用更多内存,还会在解码阶段增加每一步的内存读取量,这就是表格中解码速度从4K时的46.6 tok/s下降到30K时约32 tok/s的根本原因。
对于编码助手场景,上下文膨胀往往是无形的:一个典型的智能体循环会把系统提示、文件内容、工具调用结果和对话历史全部拼接成单次输入,用户很少意识到实际提交了多少token。这也是为什么TTFT(首个token延迟)比解码速度更能反映真实体验——它直接决定了用户从发出请求到看到第一个字之间的等待感知。
推到128K极限:能跑,但煎熬
作者接着把配置推向128K上限,测试了约32K、64K、96K、115K。每一级他都在上下文中嵌入四个确定性标记,要求模型检索出来,以此做完整性检查——判断运行时究竟是只是接受了这个巨大提示,还是模型真能访问分布其中的信息。
| 上下文 | 完整性 | 生成前等待 | 提示 | 解码 |
|---|---|---|---|---|
| ~32K | 4/4 通过 | 3分29秒 | 152 tok/s | 29 tok/s |
| ~64K | 4/4 通过 | 7分55秒 | 134 tok/s | 24 tok/s |
| ~96K | 4/4 通过 | 14分55秒 | 107 tok/s | 20 tok/s |
| ~115K | 4/4 通过 | 21分01秒 | 87 tok/s | 14 tok/s |
令人印象深刻的是,即便在约115K时四项完整性检查全部通过,说明模型/运行时确实在处理长上下文。但「技术上能用」和「用着舒服」显然是两回事——在115K时,作者等了约21分钟才开始生成,解码降到约14 tok/s。这是压力测试的范畴,不是你希望每次编码交互都如此。
内存是另一半真相
大上下文还对36GB统一内存造成显著压力。在64K阶段附近,可用内存从89%降到27%,交换空间从529MB涨到2.5GB;96K时可用内存降到24%,交换空间到2.9GB。
这正是作者反对「我的模型支持128K,所以128K应该很舒服」这种读法的原因。模型可能支持,但你的硬件仍要为此买单。在Apple Silicon上CPU和GPU共享统一内存,模型权重、上下文/KV状态、应用程序和整个系统都在同一内存架构里竞争。一旦macOS开始更多依赖压缩和交换,这就是理解基准数字的重要背景,而不是只盯着tok/s。
Apple Silicon的统一内存架构(UMA)意味着GPU显存和系统内存是同一块物理内存,上限固定(此处为36GB)。运行大型语言模型时,内存消耗主要来自三部分:模型权重本身(Qwen 27B的4位量化版本约需14–16GB)、KV缓存(随上下文线性增长),以及操作系统和其他应用的正常占用。当可用内存不足时,macOS会启动内存压缩(Memory Compression)并将冷数据交换到SSD,即"Swap"。
交换对LLM推理的影响尤为显著:模型权重或KV缓存一旦被换出,GPU访问时必须先从SSD调回内存,而M系列芯片的SSD带宽虽然出色(约7GB/s),仍远低于统一内存带宽(M4 Max约400GB/s),由此造成数量级的性能下降。64K上下文时交换空间从529MB涨至2.5GB这一跳变,正是性能开始明显劣化的信号。
顺手做了个开源基准工具
整个实验始于手动发送Ollama API请求,很快变得繁琐。于是作者把这些实验做成了一个CLI工具——Devbits Ollama Bench(GitHub开源,MIT许可),专注于他想搞懂的那些指标:上下文扩展、TTFT、提示处理、解码性能、内存压力以及冷/热启动行为。
工具有四种基准模式:
- Quick:快速、可重复的基线
- Practical:测试4K→8K→16K→32K的隔离工作负载,展示日常上下文扩展如何影响性能
- Stress:推向配置上限,带完整性检查和内存压力警告
- Custom:自定义上下文工作负载
它会自动检测机器和本地安装的Ollama模型,支持思考强度设置,测量提示/解码吞吐和TTFT,监控内存压力,并输出Markdown和JSON报告。它刻意避免静默下载模型或静默削减你要测试的上下文——大上下文运行成本高,所以会在开始前警告。
结语:别再用一个数字看本地模型
这次实验改变了作者对本地模型性能的理解方式。他不再只问「它能跑多少tok/s」,而是更关心「它消化我实际使用的上下文要花多久」。
一个号称40 tok/s的模型可能完全属实,但用户要等三分钟才能处理完大型编码上下文;一个标榜128K上下文的模型也确实能处理接近这个量,却要20多分钟才开始响应。两个规格都没错,它们只是在描述体验的不同部分。
对于用本地模型做编码的人来说,值得反问自己:你平时实际用多大的上下文?在多高的TTFT下,本地模型开始让你觉得「太慢了」?
相关推荐
语音识别远未解决:Mistral音频研究负责人深度解析
Mistral AI音频研究负责人Pavan Kumar Reddy深度解析语音识别为何远未解决:从Voxtral模型架构、连续隐变量生成、流式与批量权衡、说话人分离难题到DPO修复幻觉,以及语音技术在真实企业场景的落地短板。
AI权重可被复制,为何反而扼杀了创造力?
AI模型权重可被随意复制,这种开放权重的无约束特性反而削弱了创造力。本文解析复制为何是反模式、约束如何催生新颖,以及"约束工程师"这一正在浮现的新角色。
NVIDIA Cosmos解析:物理AI如何打通语言、视频与动作
NVIDIA研究负责人Ming-Yu Liu深度解析Cosmos物理AI世界模型:如何用单一架构打通语言、视频、音频与动作,涵盖自回归塔与扩散塔协作、多模态时间对齐、策略验证仿真及Super/Nano/Edge三种开源模型。