M5 Ultra AI性能实测:矩阵算力翻近5倍的最强AI Mac

M5 Ultra凭借GPU内置Neural Accelerator,将本地AI推理与视频生成性能推高至M3 Ultra的约4倍。
苹果M5 Ultra通过在每个GPU核心中嵌入Neural Accelerator,专门加速通用矩阵乘法,使本地AI性能接近上一代M3 Ultra的四倍。实测中,本地运行650亿参数视频模型MiniMax H3生成5秒768P视频仅需9分24秒,是M3 Ultra的四分之一耗时;FP16矩阵乘法算力达107 TFLOPS,为M3 Ultra的4.79倍。大模型推理方面,128K长上下文Prefill速度提升约4倍,显著改善本地Agent应用的首响应体验;内存带宽升至1.2TB/s,Decode速度也提升约六成。文章还从芯片架构角度解析了Ultra"胶水拼接"的工程合理性,并梳理了AI需求如何逐代重塑Apple Silicon的设计重心。
苹果最强芯片再次刷新桌面AI的性能上限。一位B站UP主对M5 Ultra进行了从本地视频生成、大模型推理到芯片架构的全维度深度实测,结论直白:它的AI性能已经接近上一代M3 Ultra的四倍。这个数字背后,究竟是什么在发生变化?
本地视频生成:从“能跑”到“可用”
本地跑最强视频模型一直是Mac的极限挑战。测试选用了MiniMax H3——目前几乎最强的视频生成模型之一。它的规模相当惊人:负责画面生成的Diffusion Transformer有330亿参数,负责理解输入的千问三VL有320亿参数,总参数量高达650亿,8比特量化后大约需要60G内存,本地运行压力可想而知。
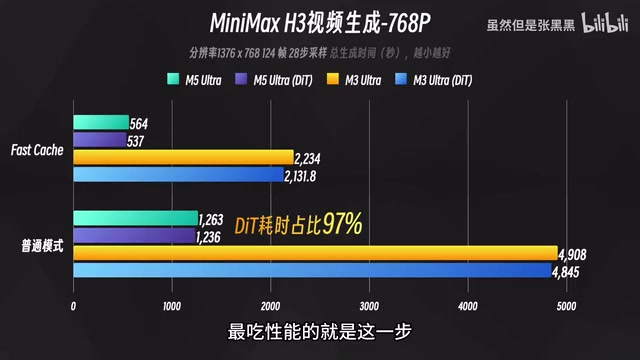
以生成5秒768P视频为例,开启Fast Cache的情况下,M3 Ultra耗时37分14秒,而M5 Ultra只需9分24秒,快了将近4倍。关闭Fast Cache追求更高画面精度时,性能提升同样接近4倍。这个差距的意义在于:本地视频生成从“勉强能跑”变成了真正“可用”。
对多数创作者而言,更实用的是把分辨率降到512×256先出草稿。这种模式下M5 Ultra生成5秒视频只需不到40秒,M3 Ultra则需要161秒。不用排队、不花Token、不到一分钟拿到草稿素材,对AI短视频创作来说性价比很高。
Neural Accelerator:性能飞跃的核心
同样是80核心GPU,为什么视频生成能拉开这么大差距?关键在于M5全系列在GPU核心中新增的Neural Accelerator,它重点加速的是通用矩阵乘法——AI推理中的核心操作。
其工作原理是把大矩阵拆成适合硬件处理的小块并行计算,同时尽量把数据留在附近缓存中多次复用,减少反复访问内存的次数。而MiniMax H3的核心Omni Transformer降噪模块,恰好包含大量此类计算。UP主拆解发现,不开Fast Cache时生成768P视频总耗时约21分钟,其中20分钟都花在Transformer降噪上——这正是矩阵运算最密集的环节。
理论算力测试更能说明问题。在FP16精度、4K×4K×4K转置矩阵乘法任务中:不调用Neural Accelerator时,M5 Ultra实测算力30.75 TFLOPS,比M5 Max提升约96%,比同为80核GPU的M3 Ultra提升约36%。而一旦启用Neural Accelerator,M5 Ultra突破107 TFLOPS,是自身非加速状态的3.51倍,达到M3 Ultra的4.79倍。同样80核GPU,两代芯片在矩阵乘法上差了近5倍。
扩大到4K×4K×16K规模,M5 Ultra仍能达到91 TFLOPS,M5 Max和M3 Ultra分别为34和22 TFLOPS——Ultra对Max的优势进一步扩大。
通用矩阵乘法(GEMM,General Matrix Multiplication)是深度学习推理中最基础也最计算密集的操作。无论是Transformer的自注意力机制、前馈网络,还是卷积神经网络中的卷积层,底层都可以归结为大规模矩阵相乘。现代AI加速器的设计核心,往往就是针对GEMM进行特化优化——英伟达GPU中的Tensor Core、谷歌TPU中的脉动阵列(Systolic Array)都是类似思路。苹果在M5中为每个GPU核心嵌入Neural Accelerator,相当于把这种专用加速能力下沉到GPU的基本执行单元,使得即便是非显式调用神经网络框架的通用矩阵运算,也能自动受益,而不像过去那样只有走特定API路径才能用到加速资源。这种架构选择解释了为什么同样80核GPU,两代芯片在矩阵乘法上能拉开近5倍差距。
大模型推理:Prefill耗时大幅缩短
Neural Accelerator不仅加速视频生成,也解决了Mac长期的老问题:大模型推理时Prefill(读取并理解整段输入)耗时过长。输入越长,首个Token的等待时间越夸张,给模型喂一篇论文或大段代码时尤为明显。由于Prefill同样充满Attention的密集矩阵乘法,视频生成的收益在这里同样体现。
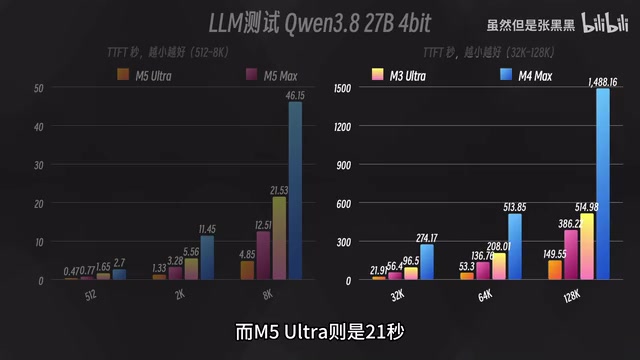
以推荐的本地模型千问3.8 27B为例:512 Token短输入下,M3 Ultra需1.65秒、M5 Ultra仅0.47秒。但真正拉开差距的是长上下文——8K输入时,M4 Max需46秒、M3 Ultra需21秒、M5 Max为12秒,而M5 Ultra只需4.85秒。32K输入下M3 Ultra需96秒、M5 Ultra仅21秒;128K输入时M3 Ultra需8分35秒,M5 Ultra只要2分半左右。
升级到DeepSeek广告 V4 Flash(约2840亿总参数、每Token激活约130亿)和GLM 5.3 Flash(3200亿总参数、激活约180亿)这类更大规模的MOE模型,M5 Ultra在长上下文下依旧保持约3倍以上的Prefill加速。这对本地Agent应用格外利好——Agent调用工具往往涉及项目结构、工具说明等大量上下文,快速首响应正是体验的关键。
大模型推理在工程上分为两个截然不同的阶段,理解这一区分有助于解读性能数据的含义。Prefill阶段(又称预填充或提示处理)负责一次性处理用户输入的全部Token,计算并缓存每个位置的Key-Value状态(KV Cache);这一阶段计算量与输入长度的平方成正比,对算力要求极高,属于计算密集型(Compute-bound)操作。Decode阶段则是逐Token自回归生成,每次只产出一个Token,主要瓶颈在于要把整个KV Cache和模型权重从内存搬到计算单元,属于内存带宽密集型(Memory-bound)操作。正因如此,Neural Accelerator对Prefill的加速效果(约3-5倍)远超对Decode的加速效果,后者更多受益于内存带宽的提升。在实际使用中,Prefill速度决定了"首Token延迟",即提交问题到模型开始回答的等待时间;Decode速度则决定了"流式输出"的流畅程度。
Decode速度与内存带宽
Decode(开始回答后每秒生成Token数)阶段主要受内存带宽影响。千问3.8 27B在512 Token输入下,M3 Ultra约每秒35 Token,M5 Ultra达55 Token;64K输入下两者分别为26和41 Token。M5 Ultra在各档测试中相比M3 Ultra保持了接近六成的提升。
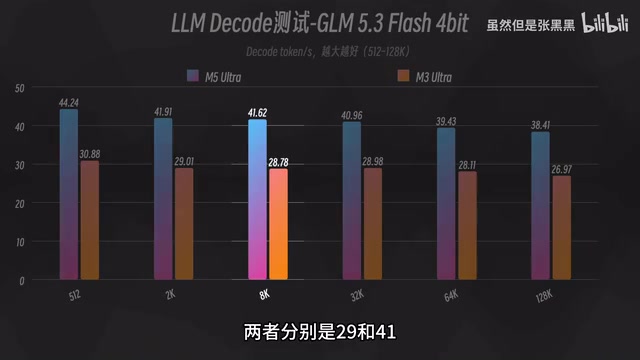
背后是内存带宽的跃升:M3 Ultra为819GB/s,M5 Ultra提高到1.2TB/s,增加约五成,与Decode提升幅度基本一致。UP主指出,1.2TB/s对桌面设备而言已是夸张配置——当年40G版本的A100用HBM显存带宽也就1.6TB/s,M5 Ultra靠LPDDR5X堆到这个程度相当不易。CPU方面,M5 Ultra全核聚合读带宽提升到500GB/s,明显高于M3 Ultra的265GB/s和M5 Max的298GB/s。
为什么Ultra还要用“胶水”
Geekbench测试中,M5 Ultra单核3731、多核约5万,相比M3 Ultra单核提升约26%、多核约31%;Blender渲染中相比M3 Ultra性能提升超70%,部分场景接近翻倍。这说明新一代Ultra Fusion技术在一定程度上解决了过去两颗芯片间通信时间过长、无法发挥全部实力的老问题。
那为什么Ultra都出到第四代还要用“胶水”拼接?UP主给出了工程视角的解释:单颗硅片无法无代价地一直做大,芯片越大制造成本和良率越难控制,还受光刻曝光面积限制。即便做出一颗超大芯片,核心间通信、缓存一致性等问题依然存在,数据传输距离和延迟不会自动消失。因此对Ultra这个规模而言,多芯片是务实且具性价比的选择,苹果真正要做的是不断优化Ultra Fusion,让芯片协作时尽量少付出性能代价。
AI如何重塑苹果芯片设计
把几代Apple Silicon放在一起看,能清晰看到AI的深远影响:M1的统一内存让CPU与GPU共享数据,无心插柳成就了Mac的本地推理优势;M3带来512G内存,让千亿参数MOE模型能装进Mac;M4强化了CPU的机器学习加速;到M5,苹果把Neural Accelerator放进每一个GPU核心,为几乎所有AI应用带来收益;M5 Ultra则将这一优势进一步放大,成为当之无愧最强的AI Mac。据传M6会进一步提升Neural Accelerator性能。
更值得玩味的是趋势本身。半年前UP主还在折腾四台Mac组建集群,如今一台M5 Ultra就相当于过去四台的算力。从占满房间、重达27吨的ENIAC,到口袋里的手机,再到如今AI生成与推理能力逐步走进个人电脑——也许再过一两年,我们就能把接近GPT-6级别的能力装进个人电脑,无需网络、不担心数据泄露。至于M5 Ultra会不会像M3 Ultra那样一路涨价成为“理财产品”,谁也说不准,但算力最终的价值,还是在于我们用它创造出的内容。
背景补充
Ultra Fusion是苹果将两颗相同的Max芯片通过高带宽封装互联技术合并为一颗逻辑芯片的方案,对操作系统和应用程序而言,它呈现为单一的统一芯片。其核心挑战在于维持两颗Die之间的缓存一致性(Cache Coherency)——当一颗Die修改了某块数据,另一颗Die的缓存必须及时失效或同步,否则会出现数据错误。互联带宽越高、延迟越低,两颗Die就越接近"行为上的一颗芯片"。苹果历代Ultra Fusion的主要改进方向正是提升Die-to-Die互联带宽并降低延迟,这也是为什么文章中Blender多核性能提升超70%、接近理论双倍上限的原因——说明在这类并行渲染任务中,Die间通信已不再是主要瓶颈。相比之下,早期Ultra在需要频繁跨Die同步的工作负载下,性能往往无法线性叠加。
相关推荐
GLM 反向代理工具实测:免登录调用背后的技术与风险
GLM 反向代理工具宣称可免登录白嫖 AI 大模型能力,本文实测解析其接口调用原理、防封逻辑,并从稳定性、合规与安全角度提示这类工具的潜在风险。
Opus 5.5 一键生成动画短片:$3.21 API 费用背后的自主创作实验
一位 Reddit 用户用 Opus 5.5 通过单条提示词自主生成手绘风格动画短片,OpenRouter API 花费仅 3.21 美元,调用 8 个 API 完成脚本、图像、配音到动画全流程。本文解析其成本结构与 AI Agent 自主编排能力。
Bessemer募资57.5亿美元加码AI:豪赌AI原生公司高增长
老牌风投Bessemer募集57.5亿美元新基金全力押注AI,称AI原生公司增长速度超过历史上任何技术。本文解析这笔巨额资金背后的行业逻辑与潜在风险。