M5 Ultra Mac Studio评测:本地AI工作站的性能跃迁
M5 Ultra Mac Studio凭借256GB统一内存,成为本地大模型时代最紧凑的私有AI工作站。
苹果将Mac Studio从M3 Ultra跨代升级至M5 Ultra,CPU多核性能提升约68%,GPU光追性能翻倍。得益于Apple Silicon的统一内存架构,256GB内存可直接容纳DeepSeek V4 Flash 284B模型的4bit量化版(155GB),实现完全本地的AI推理,无需消耗API token,且敏感资料全程不出设备。评测团队将其部署为整个部门的端侧AI中心,处理封面评估、会议转写、Blender自然语言建模等任务,GPU性能的跃升也让《赛博朋克2077》在4K超高画质下达到近70帧。相比之下,Mac Mini更适合在线AI工作流,而Mac Studio则面向有本地部署与高定制需求的用户,受众正从少数专业用户扩展至所有希望借AI落地创意的人。
时隔一年半,苹果终于给桌面级最强的Mac Studio换上了新芯片,而且是跨代升级——从M3 Ultra直接跳到M5 Ultra。在这一年半里,半导体行业被AI推着狂奔,Mac Studio的定位也在悄然改变:曾经无人问津的512GB顶配版,因为本地大模型的火爆被抢购一空,二级市场甚至疯狂加价。今年M5 Ultra版首发最高配到256GB,价格直接顶到了10万级别。这台机器到底能给AI时代的创作者带来什么,B站UP主凰家评测(硕硕)用实际工作流给出了答案。
外观依旧,性能翻倍
Mac Studio保持了它一贯紧凑的桌面形态,尺寸、接口、按键布局全部没变,颜色仍然只有银色一种。UP主也吐槽了一句:这么Pro级的能力,苹果是不是可以考虑像MacBook Pro那样加个黑色,视觉上把生产力拉满。
真正的看点在性能。从跑分来看,M5 Ultra相比上代M3 Ultra是一次幅度明显的升级:
- CPU:Geekbench单核、多核分别提升约33.5%和32.5%,Cinebench R26单核提升约36.7%,多核提升高达68.4%
- GPU:Steel Nomad Light提升约25.2%,侧重光追的Solar Bay Extreme成绩直接翻倍,提升108.4%
如果把时间线拉回到M1 Ultra,进步幅度更加夸张:CPU单核提升约70%,Geekbench多核提升约119%,Cinebench多核提升约186%。GPU方面,Solar Bay Extreme从2070分飙升到27048分,提升幅度超过12倍。这组数据直观展现了几代Apple Silicon在GPU架构和光追能力上的跨越式进步。
对于凰家评测这样把视频剪辑、视觉设计全部压在Mac Studio上的团队来说,上百G素材、多机位时间线的流畅拖动和快速渲染早已不是问题。
3A游戏不再是问题
GPU性能的暴涨让Mac Studio有底气走出视频工作室。UP主用《赛博朋克2077》跑基准测试,在不开AI超采、超高画质下:1080P可达178帧,2K为131帧,4K仍能维持在68.8帧。
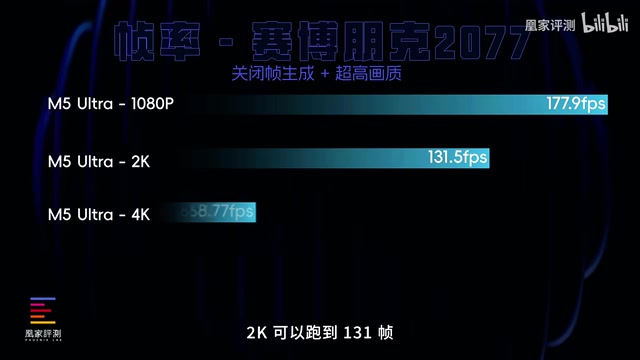
这意味着「Mac能不能玩3A」已经不用讨论,剩下的只是「4K超高画质下哪颗芯片更丝滑」的问题。GPU架构的进化恰好踩中了AI时代对算力的渴求,让这台机器的定位从纯生产力工具向更广阔的场景延伸。
AI超采样(AI Super Sampling) 是现代游戏中提升帧率的关键技术,其原理是用较低分辨率渲染画面,再借助神经网络将图像"脑补"还原成高分辨率输出,从而在画质损失有限的前提下大幅降低GPU负担。NVIDIA的DLSS、AMD的FSR、Intel的XeSS均属此类技术。苹果也有对应的MetalFX超采样方案。测试中刻意关闭AI超采样,是为了展示M5 Ultra GPU的"裸算力"下限——在不借助任何帧率增强技术的情况下,4K超高画质仍能维持接近70帧,已达到绝大多数显示器的流畅阈值。若开启MetalFX或游戏内置的超采样选项,帧率还可进一步提升,这也意味着实际游戏体验会比基准测试数据更好。
大内存 = 本地AI的最佳容器
这次评测最有价值的部分,是把Mac Studio变成了整个部门的端侧处理中心。
UP主团队此前用DeepSeek广告 V4 Flash的在线模型让agent自动判断封面是否受欢迎、整理新品信息,看重的是它在速度和理解力上的平衡且省token。这次他们直接把DeepSeek V4 Flash 284B模型的4bit量化版(共155GB)塞进了这台大内存Mac Studio,再把原有agent接入本地模型,实现「只费电不费token」地处理日常需求。实测下来,无论响应速度还是结果质量,在其使用需求下与在线模型差别不大。
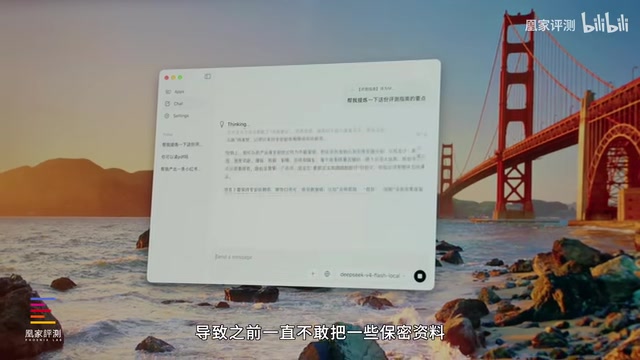
本地部署的核心价值是隐私。作为经常签署高额保密协议的评测博主,UP主此前不敢把保密资料上传到在线模型。他用Codex做了一个完全本地运行的语音转写App,转写结束后调用本地的DeepSeek V4 Flash生成会议总结,整个流程不出本地,既不担心资料泄露,也省去了各类转写App的月费会员。
他进一步指出,金融记录、体检报告这些你不想暴露在互联网上的信息,都可以交给本地模型分析,而Mac Studio「可能就是这个时代最好的容器」。
统一内存架构(Unified Memory Architecture,UMA) 是理解苹果芯片为何适合本地大模型的关键。在传统PC架构中,CPU内存与GPU显存是物理隔离的两块独立硬件,数据在两者之间传输会产生延迟和带宽瓶颈。Apple Silicon将CPU、GPU、神经网络引擎(Neural Engine)以及内存控制器集成在同一颗芯片上,所有计算单元共享同一块物理内存池。这意味着一个155GB的量化模型加载进内存后,GPU可以直接访问,无需在"显存"和"内存"之间复制数据。传统高端PC即便配备24GB显存的旗舰显卡,遇到超过显存容量的模型就必须分片处理或降级到CPU推理,速度断崖式下跌。Mac Studio的256GB统一内存对大模型而言,等效于拥有256GB"显存",这在消费级设备中几乎无对手,也是4bit量化版284B模型能流畅运行的根本原因。
AI + 专业工作流:想象力才是唯一限制
除了文本处理,UP主还演示了AI与专业软件的结合。他用Codex操作Blender,直接用自然语言建模出一个iPhone Duo。得益于充沛的性能,Mac Studio可以一边跑建模、一边继续剪视频,甚至把建好的模型拉进本地视频生成软件,直接产出一个AI短片。
用UP主的话说:「有了AI和Mac Studio,限制你执行力的只能是你的想象力。」自然语言就能写代码、就能在Blender里建模,最终能否交付取决于容器能不能承载你的想法。
Codex 是OpenAI推出的代码生成模型,现已深度集成进ChatGPT及相关工具链,能够理解自然语言指令并将其转化为可执行代码。文章中提到的两个应用场景——本地语音转写App和自然语言驱动Blender建模——本质上都是通过Codex将"我想要什么"翻译成程序或脚本指令,跳过了传统软件开发的学习门槛。Blender是一款开源的三维建模与渲染软件,支持Python脚本控制几乎所有操作,这使得AI生成的代码能够精确操控软件行为。两者结合意味着即便没有编程或三维建模基础,也能通过对话完成复杂的创作任务,而Mac Studio负责的是在本地实时运行这一切所需的算力。
Mac Studio 还是 Mac Mini?
针对同期发布的Mac Mini,UP主给出了清晰的分工建议:
- Mac Mini:更适合在线AI工作流,处理文档、激发创意足够用,低功耗、体积小,放在角落长期在线也不占地方。
- Mac Studio:更适合有本地部署需求的用户,更强的处理器和内存能让AI跑在本地,满足高度定制化的使用需求。
更重要的是选购逻辑的转变。UP主坦言,过去他只会把Mac Studio推荐给极致Pro的专业用户;而在AI时代,他愿意把它推荐给所有想创造的人——统一内存架构让苹果似乎精准踩中了本地大模型的风口,让AI与Mac相互成就,为创作者提供了一个最紧凑的性能容器。
结语
M5 Ultra Mac Studio的意义不只在于跑分翻倍,而在于统一内存架构恰好契合了本地大模型对显存/内存容量的极端需求。当256GB乃至更大内存能装下百G级量化模型时,隐私敏感的创作者和专业用户获得了一个「只费电不费token」的私有AI工作站。对于苹果而言,这或许是神预判,也或许是巧合,但结果是Mac Studio的受众正在从少数Pro用户扩展到每一个想借AI落地想法的人。
相关推荐

无GPU也能跑大模型?老旧DDR3服务器的本地推理性价比探讨
一场Reddit讨论探讨了无GPU本地部署大模型的可行性:用老旧DDR3多路服务器靠内存带宽跑Qwen 3.8 Flash,以及4bit量化、KV缓存与上下文长度的实用权衡与电费成本争议。

拓扑域外泛化:让AI预测系统从未见过的动力学突变
NeurIPS论文提出拓扑域外泛化方法,通过特征分离与物理稀疏先验修复分层DSR模型缺陷,使AI能在不知控制参数的情况下预测系统分岔与动力学突变,适用于PLRNN和Neural ODE。

用不好AI Agent是你的错吗?破解AI工具焦虑的实用指南
用不好AI Agent是你的能力问题吗?本文从产品成熟度、使用预期和场景匹配三个角度剖析AI工具使用困境,提供破解AI焦虑的实用方法与选型建议。