Mac mini M4实战:Ollama本地部署千问3.5并接入聊天工具

Mac mini M4 用 Ollama 部署千问3.5 9B 并接入第三方聊天工具的完整实操
文章基于 B 站 UP 主的实战视频,完整梳理了在 32GB 统一内存的 Mac mini M4 上运行本地大模型的流程:从 ollama.com 下载安装 Ollama,通过 `ollama run 千问3.5:9b` 拉取约 6.6GB 的模型,用 `--force` 关闭默认思考模式以降低延迟,再到第三方聊天工具中以 Local 模式、Node 类型接入本地 Ollama,端口填 `127.0.0.1:11434` 并务必加上 `/v1` 后缀。作者认为 9B 模型已能覆盖约 90% 的日常需求,整个部署无需编译或容器编排,有终端基础的用户半小时内可跑通,同时提醒端口与路径后缀是连接失败的最常见原因。
在本地硬件上跑大模型,早已不是极客的专属游戏。Mac mini M4 凭借统一内存架构,让 CPU 和 GPU 共享同一块内存,理论上可以调用远超传统独立显卡的显存容量。B站 UP 主分享的这期实战教程,完整演示了从安装 Ollama、拉取千问3.5 9B 模型,到将其接入第三方聊天工具的全过程。本文基于该视频内容,梳理关键步骤与实测心得,并补充必要的技术背景。
为什么 Mac mini M4 适合跑本地模型
视频中这台 Mac mini 配备了 32GB 统一内存。UP 主提到,M 系列芯片的 CPU 和 GPU 共享内存,理论上可以跑 32GB 显存的模型,但现实里跑 9B 参数级别的模型“问题不大”。
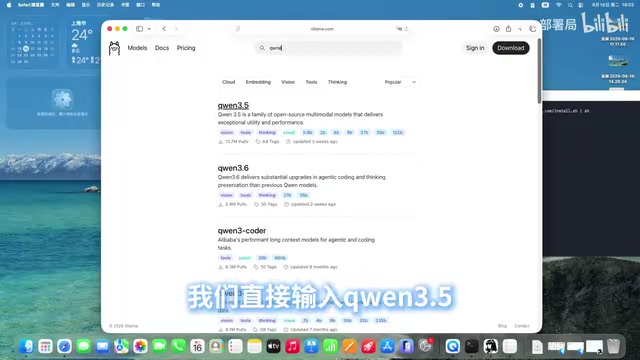
这一点值得展开:统一内存的好处是模型权重只需加载一次,GPU 可以直接访问,避免了传统独显显存不足时的数据搬运开销。对于 9B 级别的模型,在 32GB 内存的 Mac mini 上运行是相当稳妥的选择。UP 主也直言,9B 模型“上路量已经可以解决 90% 的问题了,性能绝对是够的”。
统一内存架构与本地大模型
传统 PC 上,CPU 使用系统内存(DDR),GPU 使用独立的显存(GDDR/HBM),两者之间通过 PCIe 总线交换数据。运行大模型时,模型权重通常需要全部加载到显存中,一旦显存不足,就要把部分层留在系统内存里反复搬运,速度会断崖式下降。Apple Silicon 的“统一内存”(Unified Memory)把 CPU、GPU 和神经引擎放在同一块封装内的共享内存池上,GPU 可以直接寻址全部内存容量,不需要显式的拷贝。这意味着 32GB 内存的 Mac mini 可以像一个拥有 32GB 显存的 GPU 那样加载模型——虽然内存带宽和算力不及高端独显,但“能装下”本身就是本地推理的第一道门槛。也正因如此,Mac 上的可用显存并不是固定值,系统会为 GPU 保留一部分(默认约为总内存的 75%),可通过 sudo sysctl iogpu.wired_limit_mb 调整上限,这也是为什么 32GB 机器实际能稳定跑 9B 模型、却未必能轻松容纳更大参数模型的原因。
安装 Ollama:一条命令搞定
部署的第一步是安装 Ollama。UP 主打开 ollama.com,点击右上角下载,选择 macOS 版本,复制命令后粘贴到终端运行。安装过程在后台进行,大约需要三到五分钟。
这一步没有太多坑,Ollama 的安装脚本会自动处理依赖和后台服务。安装完成后,终端里就可以直接使用 ollama 命令。
Ollama 在本地推理栈中的位置
Ollama 本质上是一个本地大模型运行时与管理器,它把模型下载、量化格式转换、推理引擎(基于 llama.cpp)和 HTTP API 服务打包在一起。安装后会在后台常驻一个服务进程,默认监听 127.0.0.1:11434,这正是后文配置第三方工具时要填写的端口。ollama run 命令会自动完成“拉取模型 → 加载到内存 → 启动交互式对话”三步;模型以 GGUF 量化格式存储,9B 模型约 6.6GB 的体积说明它使用的是 4-bit 级别量化,在精度损失可控的前提下大幅压缩了内存占用。Ollama 默认只监听本机回环地址,不对外网开放,因此本地使用无需额外配置鉴权,但若要让局域网内其他设备访问,需要设置 OLLAMA_HOST 环境变量。
拉取并运行千问3.5 9B 模型
安装好 Ollama 后,进入 models 页面搜索“千问3.5”,选择 9B 版本。UP 主复制了对应的命令,在终端输入 ollama run 千问3.5:9b 并回车。模型体积为 6.6GB,首次运行会自动下载。
下载完成后进入对话界面,可以直接输入“你好”测试。视频中特别提到一个细节:千问3.5 默认可能开启“思考模式”(Sync 模式),UP 主选择将其关闭,重新以 --force 参数启动,这样模型就不会在回答前输出思考过程。
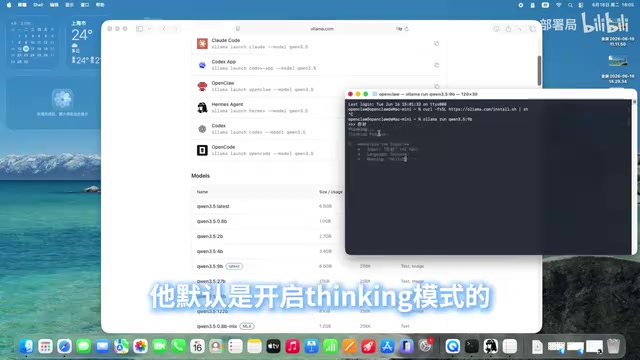
对于日常问答和工具调用场景,关闭思考模式可以显著降低响应延迟,输出也更干净。是否需要开启,取决于具体任务对推理深度的要求。
接入第三方聊天工具:关键配置项
模型在终端里跑通只是第一步。UP 主接下来演示了如何把 Ollama 的本地模型接入一个聊天工具(视频中称为“小龙家”,从描述看是一个支持技能调用的对话应用)。该工具此前已经接入过 DeepSeek广告 模型,并且自带画架构图的能力。
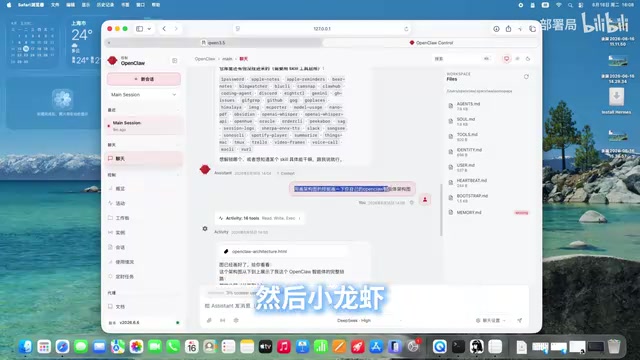
配置入口在终端执行配置命令,选择 Local 模式,然后选择 Node 类型,在模型提供方列表中找到 Ollama,只勾选本地 Ollama,不选远程。端口填写 127.0.0.1:11434。
这里有一个容易踩的坑:UP 主强调地址后面要加 /v1,不加的话可能连接不到。
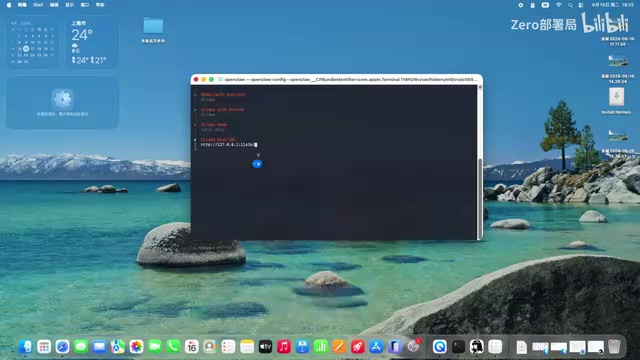
加上 /v1 之后,界面上就能看到本地已下载的模型列表,选中千问3.5 9B,保存配置并刷新页面,即可在聊天工具中切换到该模型。视频中测试了一句“你好”,模型正常回复;随后询问“你是什么大模型”,也正确识别为千问3.5 9B。
UP 主提到上下文长度可能调得比较小,这属于配置层面的微调项,不影响整体跑通。
为什么 Ollama 地址要加 /v1
Ollama 原生提供两套接口:一套是自家的 /api/chat、/api/generate,另一套是模仿 OpenAI 的兼容接口 /v1/chat/completions、/v1/models。大量第三方聊天客户端和 Agent 框架只实现了 OpenAI 协议,它们会默认向配置的 base URL 后面拼接 /v1/... 或直接请求 /models。如果只填 127.0.0.1:11434,客户端可能请求到不存在的路径而报连接失败;加上 /v1 后,请求正好落到 Ollama 的 OpenAI 兼容端点上,模型列表和对话才能正常工作。这也是本地模型接入第三方应用时最高频的排错点——端口对、服务在跑,却因为少了一个路径后缀而一直连不上。
本地部署的实际价值与适用边界
从这期教程可以看出,Mac mini M4 加 Ollama 的组合已经把本地大模型的部署门槛降到了“复制粘贴命令”的程度。整个流程没有编译、没有容器编排,对有一定终端使用经验的人来说,半小时内可以完成。
适用场景上,9B 级别模型适合日常问答、文档摘要、代码辅助和简单的工具调用。UP 主在视频中展示的架构图生成,就是模型配合应用层技能实现的典型例子。如果任务需要更强的推理能力,则需要考虑更大参数的模型,但对内存的需求也会水涨船高。
需要留意的是,视频中的聊天工具名称和部分术语以 UP 主口述为准,实际配置时以软件界面为准。端口地址、/v1 后缀这类细节,是本地模型接入第三方应用时最常见的连接失败原因,值得单独记下来。
9B 模型的定位与“思考模式”
9B 属于中等偏小的稠密模型规模,在消费级硬件上属于“能力与成本”的甜点区:它足以胜任摘要、改写、代码补全和结构化输出,但在多步复杂推理、长文档理解和严谨事实性上明显弱于 30B 以上的模型。文中提到的“思考模式”指的是推理型模型在输出答案前先生成一段思维链(chain-of-thought),类似 DeepSeek-R1 的推理过程。开启后回答质量在数学、逻辑类任务上更好,但首字延迟和 token 消耗都会成倍增加;关闭后模型直接给出答案,更适合闲聊、检索和工具调用等对实时性敏感的场景。是否开启,本质上是延迟与推理深度之间的取舍。
相关推荐

MiniMax H3开源工作流:低显存也能打造呼吸感皮肤
本文介绍B站UP主分享的MiniMax H3双采样工作流,通过融合模型、破线LoRA和低显存节点,解决AI人物面部油腻问题,并让12G显存设备也能运行。包含模型搭配、双采样逻辑与参数设置详解。

手机本地大模型+ESP32:自制热量提醒器
B站UP主开源了一个热量摄入提醒器项目:手机APP用miniCPM开源模型本地拍照识别食物并估算热量,ESP32小屏幕同步数据,用绿黄红圆环展示摄入状态,可磁吸在冰箱门上随时提醒。

12GB显卡跑125B MoE?Strata三级协同引擎解析
开源C++引擎Strata让12GB-16GB家用显卡本地跑125B MoE模型,生成速度达40-95 Token/s。本文拆解其显存、内存、固态三级协同原理,说明模型选型前提、硬件配置门槛与启动方式。