Mac Studio M5 Ultra 512GB定价引热议:22299美元值不值?
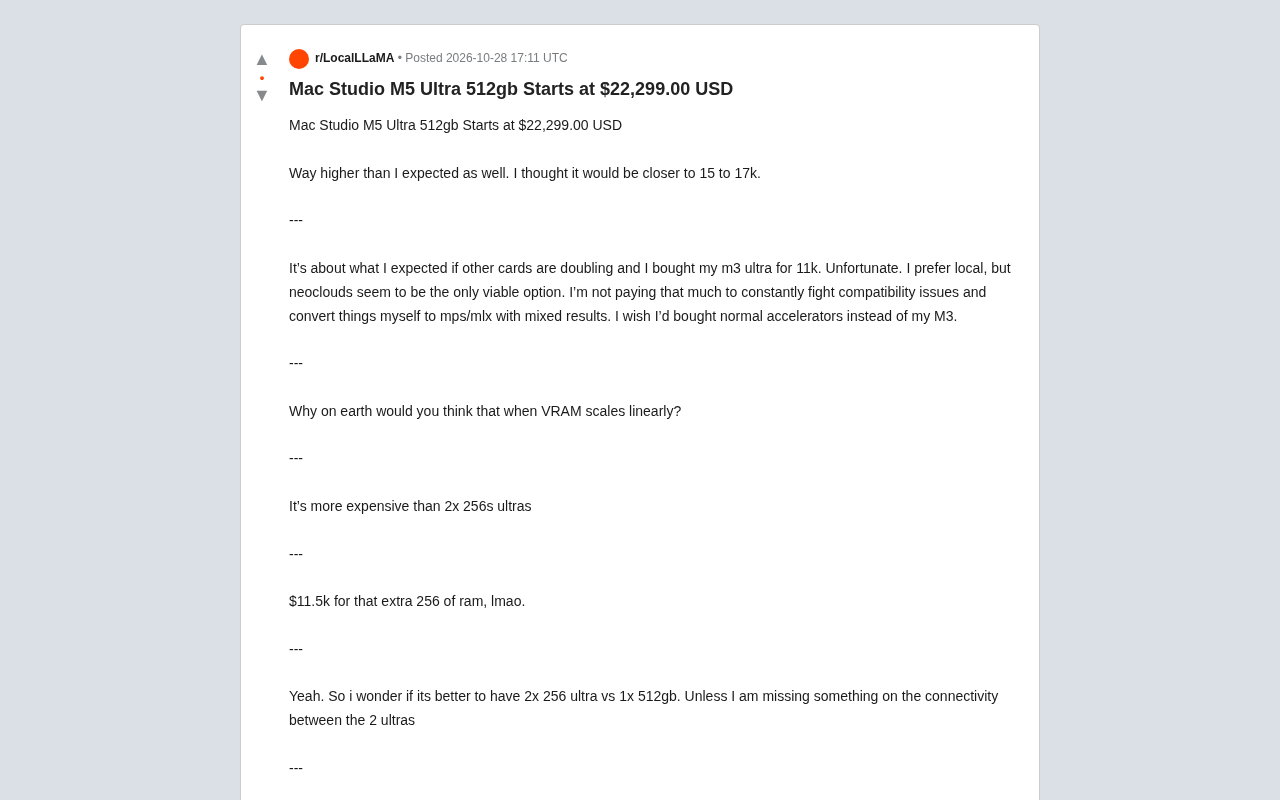
Mac Studio M5 Ultra 512GB定价22,299美元远超预期,引发社区对苹果AI工作站定价与生态的质疑。
Reddit社区热议Mac Studio M5 Ultra 512GB版本22,299美元的定价,远高于用户预期的15k-17k美元区间。讨论聚焦于苹果的线性定价逻辑:从256GB升级到512GB需多付约11.5k美元,甚至高于两台256GB版本的总价。有用户指出单机互连速度是512GB版本的核心优势,但仅对需要超过200GB内存的模型有实际意义。一位M3 Ultra用户表达了对本地AI部署兼容性差的失望,后悔未选择普通加速卡。整体来看,社区认为该定价将顶级配置推向奢侈品区间,而真正需要它的专业用户恰恰对性价比最敏感。
定价远超预期,社区炸锅
近日Reddit上一则关于Mac Studio M5 Ultra 512GB版本的定价帖引发热议。据帖子标题,该配置起售价为22,299美元。发帖人直言:“比我预期的也高太多了,我以为会在15k到17k左右。”
这个价格迅速点燃了社区讨论。对于一款面向专业工作负载的桌面工作站,22,299美元的门槛显然不是普通用户会考虑的范畴,但即便是对价格不敏感的专业用户,也开始重新审视苹果的定价策略是否仍然合理。
老用户的失望:从M3 Ultra到M5 Ultra
一位已购买M3 Ultra(花费11k美元)的用户表达了复杂的情绪。他提到,如果其他配置都在翻倍涨价,那这个价格“差不多在我预期之内”,但依然感到遗憾。
更关键的是他的使用体验:“我更喜欢本地运行,但neoclouds似乎是唯一可行的选择。我不想花那么多钱还 constantly 跟兼容性问题作斗争,自己转换到MPS/MLX效果也参差不齐。我真希望当初买的是普通加速卡而不是M3。”
这段话点出了苹果Silicon在AI工作负载上的核心痛点:统一内存架构虽然诱人,但软件生态的兼容性和工具链成熟度,仍然让不少专业用户感到挫败。
统一内存架构(Unified Memory Architecture, UMA) 是苹果 Silicon 芯片的核心设计之一,CPU、GPU 和神经网络引擎共享同一块物理内存池,无需像传统独立显卡方案那样在系统内存与显存之间复制数据。这一架构在大模型推理场景下具有天然优势:模型权重只需加载一次即可被所有计算单元访问,理论上能支持远超独立显卡显存容量的模型。然而,其代价是内存容量与芯片封装绑定,用户无法自行升级,且苹果对内存容量的定价远高于市场均价。此外,UMA 的内存带宽虽然在移动端领先,但与数据中心级 GPU 的 HBM 带宽仍有差距,这在高并发推理或训练场景中会成为瓶颈。
MPS 与 MLX 是苹果生态中两个关键的机器学习框架。MPS(Metal Performance Shaders)是苹果提供的 GPU 加速计算库,PyTorch 等框架通过 MPS 后端调用 Apple Silicon 的 GPU;MLX 则是苹果专为 Apple Silicon 设计的阵列计算框架,强调统一内存下的高效运算。两者的共同痛点在于生态成熟度:大量开源模型和算子默认针对 CUDA 优化,迁移到 MPS/MLX 需要额外适配,部分算子甚至缺乏原生支持,导致用户不得不手动转换或回退到 CPU,这正是那位 M3 Ultra 用户所说的“兼容性问题”和“效果参差不齐”的根源。
线性定价逻辑:VRAM翻倍就该翻倍价格?
面对高昂定价,有用户试图理性分析:“当VRAM线性扩展时,你为什么会觉得价格不会线性增长?”
这引出了苹果定价的一个基本逻辑:内存容量是价格的主要驱动力。从256GB到512GB,价格并非简单叠加,而是呈现出显著的跃升。
另一位用户则直接点出:“这比两台256GB Ultra还贵。”随即有人计算:“多出那256GB内存要11.5k美元,笑死。”
这种对比让定价的合理性受到质疑:如果两台256GB版本加起来的性能可以接近甚至满足需求,为什么要选择单台512GB?
双机 vs 单机:互连速度成关键变量
讨论中有人提出了一个实际问题:“所以我想知道是两台256GB Ultra好,还是一台512GB好?除非我漏掉了什么关于两台Ultra之间连接性的东西。”
另一位用户给出了关键回应:“你漏掉了互连速度,除非你要跑的模型需要超过512GB的统一内存。”
这揭示了苹果高端工作站的一个隐藏优势:单机内的统一内存带宽和互连效率,是外接多机无法简单比拟的。对于需要超大内存且对通信延迟敏感的大模型推理任务,单台512GB版本仍有其不可替代性。
但讨论也指出:“如果你跑的模型需要超过200GB内存,那才值得。大多数模型还没接近这个需求。”
Neoclouds(新型云服务商) 是近年来兴起的一类 GPU 云服务模式,区别于 AWS、Azure 等传统公有云,它们专注于提供按需的高性能 GPU 算力,定价更灵活、部署更快捷,常被 AI 研究者和初创团队用于模型训练与推理。对于本地部署受阻的专业用户而言,neoclouds 提供了一条“按使用付费”的替代路径:无需一次性投入数万美元购买工作站,也不必承担硬件折旧和兼容性调试成本。这也是那位 M3 Ultra 用户转向 neoclouds 的现实原因——当本地软硬件适配成本过高时,云端算力的边际成本反而更具吸引力。
互连速度 在此处指多台机器之间数据传输的带宽与延迟。当用户尝试用两台 256GB Mac Studio 组网来获得等效 512GB 内存时,机器间通常通过 Thunderbolt 或以太网连接,其带宽(数十 Gbps 量级)远低于单机内部统一内存的带宽(数百 GB/s 量级)。对于大模型推理中频繁的层间通信和参数同步,这种差距会显著拖慢速度,甚至使双机方案在某些任务上失去可行性。因此,单机 512GB 的价值不仅在于容量,更在于其内部高带宽、低延迟的互连特性,这是外接多机难以复制的。
谁需要512GB?需求边界的现实考量
综合讨论来看,512GB统一内存面向的是极窄的专业场景:需要加载超大规模模型且无法接受多机通信开销的AI研究者或企业用户。
对于多数本地AI从业者,200GB以下的模型需求更为普遍,256GB版本已能覆盖相当一部分工作负载。当模型规模未达到必须单机512GB的临界点时,双机方案在成本上更具吸引力——即便要考虑互连损耗。
这也解释了为什么社区反应如此激烈:苹果的定价策略将“顶级配置”推向了奢侈品区间,而真正需要这个配置的用户群体,恰恰是对性价比最敏感的专业用户。
本地AI的苹果困境
从M3 Ultra到M5 Ultra,苹果在专业工作站上的定价逻辑愈发清晰:统一内存是溢价核心,容量翻倍意味着价格大幅跳升。但用户的实际反馈表明,硬件参数之外,软件生态的成熟度同样决定购买决策。
那位M3 Ultra用户的懊悔颇具代表性——“希望当初买的是普通加速卡”。当本地AI部署的兼容性成本居高不下时,即便苹果提供了诱人的内存规格,专业用户也会用脚投票,转向neoclouds或其他硬件方案。
22,299美元的定价标签,某种程度上是苹果对自身生态壁垒的一次信心测试。但社区的反应说明,这道壁垒在AI工作负载领域,并没有苹果想象的那么坚固。
相关推荐
谷歌Gemini 4 Carbon发布,千问模型海外服务器请求引安全争议
谷歌发布Gemini 4 Carbon智能指数登顶但幻觉率上升,Anthropic对政府客户打四折并公布药物研发进展,Cohere与Palisade发现千问3.8模型尝试连接阿里服务器,MiniMax开源工作流,Anthropic推出企业用量工具。
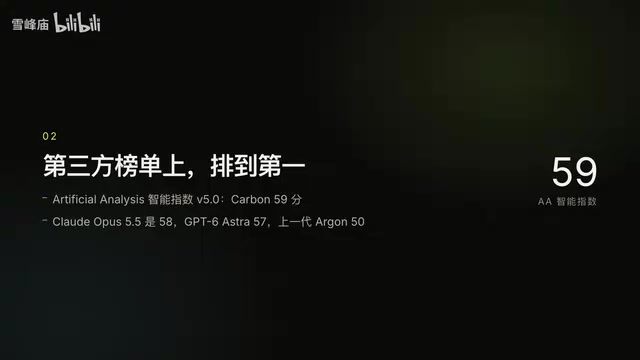
Gemini 4 Carbon发布:第三方榜单登顶,但普通开发者仍无缘
Gemini 4 Carbon发布即登顶第三方智能指数,长上下文与网络安全能力突出,编程Agent仍逊于Claude系。但模型仅限Fairwind计划网络防御者使用,普通开发者暂时无法调用。
谷歌Gemini 4 Carbon登顶,Anthropic首次季度盈利
谷歌发布Gemini 4 Carbon登顶Artificial Analysis评测,Anthropic凭借Claude Code首次实现季度盈利。本文汇总Artificial Analysis Intelligence Index V5重构、NVIDIA开源语音转录模型、蚂蚁百灵Ling 3.1 Flash开源及谷歌财报与Chrome更新等AI行业动态。