Mac本地跑AI:8GB到Mac Studio全档位模型推荐
按内存档位实测Mac本地AI:从8GB到Ultra,哪款模型装得下、跑得动、用得上。
文章以一位海外博主的实测为基础,系统梳理了不同内存容量的Mac适合运行哪些本地AI模型。核心前提是Apple Silicon的统一内存架构:GPU只能使用部分内存,36GB及以下为三分之二,超过则为四分之三,因此8GB Mac实际可用约5.3GB,16GB约10.7GB。在此基础上,作者按8GB、16GB、24GB、32GB、48GB、64GB及Ultra芯片逐档给出推荐模型与实测token速度,并区分混合专家模型与稠密模型的适用场景。结论是本地AI的价值不在于取代云端,而在于按内存精确选型;32GB以上可考虑退订付费服务试一个月。
为什么Mac适合本地跑AI
海外博主在视频里算了一笔账:如果你每月为AI聊天机器人付费,你手上的Mac其实可以免费接管其中一部分工作——飞机上能用,文件不用上传到任何地方,尝试的成本只是一个下载。难的是搞清楚你的Mac到底能装下哪个模型。选大了,它会卡顿甚至根本加载不了。
Mac适合本地AI的根本原因在于统一内存:处理器和图形核心共享同一个内存池。但macOS不会把这个池子全部交给GPU。在36GB及以下的Mac上,GPU默认拿到三分之二;超过36GB则拿到四分之三。换算下来,8GB的Mac实际可用的AI内存约为5.3GB,16GB的Mac约为10.7GB。这个份额才是真正的天花板,也是视频里每张模型截图都严格卡在这个范围内的原因。
博主提到,可以用终端命令(wired limit)调高这个上限,但给AI多少,Mac的其余部分就少多少,所以他建议小内存机器不要动它。应用层面,他的首选是专为Apple Silicon打造的LM Studio,一个窗口就能下载模型并直接对话;另一个常被提到的是Ollama。
统一内存(Unified Memory) 是Apple Silicon芯片的架构特性:CPU、GPU和神经网络引擎共享同一块物理内存池,而非像传统PC那样由CPU和独立显卡各自拥有独立显存。这意味着GPU可以直接访问系统内存中的模型权重,无需在显存与内存之间复制数据。对于本地AI推理而言,这消除了"显存容量"这一传统瓶颈——你不需要一张24GB显存的显卡,只需要足够大的统一内存。代价是GPU能使用的内存份额受macOS的wired limit(有线内存上限)约束,系统会为GPU预留一部分并锁定,防止被换出到磁盘。这也解释了为什么Mac的"可用AI内存"总是小于标称内存。
8GB M1:最小的Mac能做什么
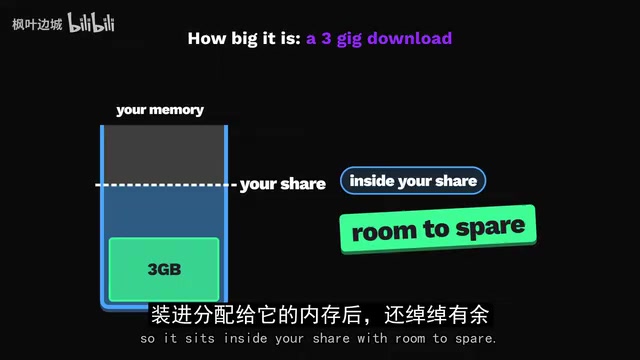
好消息是它确实能跑一个真正的聊天机器人。博主的选择是Google的Gemma 4 E2B,下载体积3GB,在可用份额里还有富余。一位用户在同样的M1上用Ollama运行它,速度达到每秒15-20个token。token大致是一个短词或词的一部分,而多数人的阅读速度是每秒5-10个token,所以答案出现得比你读完还快。适合用来改写邮件、总结粘贴进来的网页,或者在没WiFi的航班上回答快速问题。
再往上一档就触到极限了:Gemma 4 E4B下载体积5GB,几乎吃满整个份额。LM Studio自己的指南也建议8GB Mac坚持用小模型。这类模型只在加载时占用你其他应用的内存,用完退出应用,内存就会还给系统。
16GB:本地AI开始变得实用
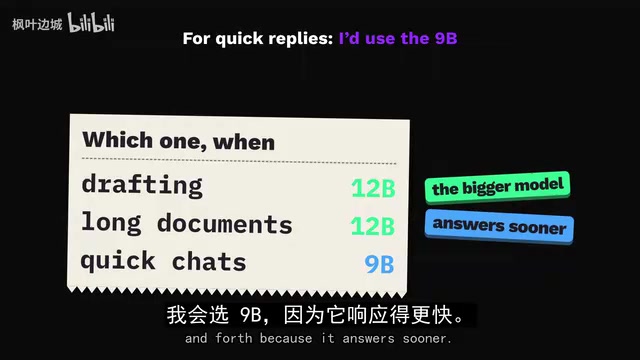
16GB是近年MacBook Air的常见配置,可用份额10.7GB,是8GB机器的两倍。博主日常使用的选择是Gemma 4 12B,下载体积7GB,还能留出空间应付长对话。在一台16GB的M4 Mac mini上,有用户实测每秒13.1个token,略快于阅读速度。想要更跟手的体验,可以试QWEN 3.5 9B,同样在M4上跑到每秒17.7个token。他的用法是:12B负责起草和总结长文档,9B负责快速来回问答。
老机器怎么办?有公开基准测试把同一个模型跑在不同芯片上:M1每秒14个token,M4每秒24个,换算下来M1保留了接近60%的速度。所以在老M1上,博主倾向选更小的模型——有用户在M1上跑Gemma 4 E4B,每秒8.2个token,仍然可读。
有观众问M5芯片的Air能跑什么。博主回答:M5的内存速度是历代Air芯片里最快的,同样的搭配只会更快——Gemma 4 12B作日常模型,QWEN 3.5 9B作快速模型。有用户在这台Air上把9B跑到每秒25个token,不过用的是自定义MLX引擎,普通应用里会略低一些。他不建议在这台Air上追大模型:超过10GB基本都要调高限额,浏览器就会和AI抢内存。
24GB:混合专家模型登场
24GB是M2到M5 Air的可选配置,也出现在M4 Pro Mac mini上。可用份额16GB,足够跑另一类模型——混合专家(MoE)。这类模型整体很大,但每个词只激活一小部分参数,所以懂得比它的速度看起来更多。
博主的选择是Gemma 4 26B,每个词只有40亿参数参与计算。一位24GB M4 Pro用户在Ollama里把它跑到每秒36-38个token,是阅读速度的数倍,但属于紧巴巴的装法:当时只剩9%的内存空闲,交换文件几乎满了,所以跑长任务前要先关掉吃内存的应用。他把编码问题、长PDF、比邮件更大的草稿都交给它。
这一档他明确跳过的是QWEN 3.8 27B:它很流行也很强,但属于稠密模型,每个词都要调动全部参数,在基础芯片上就慢。同样那台M4 Pro上,有用户只跑到每秒11.4个token,Gemma快了约3倍。它的下载体积16.5GB,份额只有16GB,装不下——除非调高限额,那样又几乎不剩什么给别的应用。32GB上能装下,但速度提升有限。
混合专家模型(Mixture of Experts, MoE) 是一种稀疏激活架构:模型整体包含大量参数,但每个token只路由到少数几个"专家"子网络进行计算。例如Gemma 4 26B总参数260亿,但每个词仅激活40亿参数。这带来两个后果:其一,推理速度接近一个小模型,因为实际计算量小;其二,模型文件体积仍按总参数计算,所以对内存容量的要求高。与之相对的是稠密模型(Dense Model),如QWEN 3.8 27B,每个token都要调动全部参数,计算量大、速度慢,但同等参数下通常能力更强。在内存受限的Mac上,MoE是"用小算力撬动大知识"的关键手段——装得下大文件,跑得出小模型的速度。
32GB与48GB:把本地模型接进编辑器
32GB的可用份额约为21GB,恰好够一个特别的模型:QWEN 3.6 35B,同样是混合专家,任一时刻只有30亿参数在工作。MLX版本略超20GB,塞进去后所剩无几。有用户用普通M6在LM Studio里跑到每秒63.8个token——基础芯片上达到阅读速度的6倍。这是博主第一次建议把本地模型接进代码编辑器:回答这么快,你就不用等,可以一直干活。代价是空间紧张,所以要控制对话长度,需要长对话时退回Gemma 4 26B。
如果你在这个容量上有老的M1 Max或M2 Max,情况不同:这些芯片的内存带宽远高于普通芯片。有用户在那样的M1 Max上跑QWEN 27B达到每秒15.8个token,所以在Max上他反而会保留稠密模型。
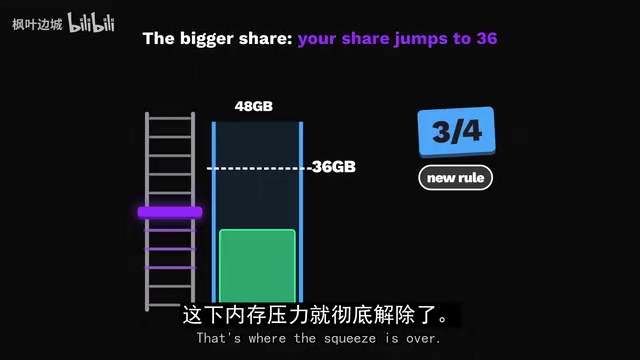
36GB和48GB分别对应Pro和Max芯片。36GB仍适用三分之二规则,份额24GB,同一个35B装得下且比32GB宽裕一点。到48GB规则切换为四分之三,份额跳到36GB,拥挤感消失了,35B可以支撑真正的长对话。有用户在一台M5 Max上用原生llama.cpp把它跑到每秒124个token——博主换算下来,大约4秒输出一整页文字。空间宽裕了,更大的稠密模型也能装:Gemma 4 31B在同一台机器上每秒25.2个token,慢一些,但每个词都调动全部参数,所以答案真正重要时他会切过去。在48GB的M4 Pro上要打折扣,因为那款芯片的内存速度远低于M5 Max,35B仍是首选。
LM Studio 和 Ollama 是Mac上最常用的两个本地模型运行器。LM Studio提供图形界面,内置模型搜索与下载,支持GGUF和MLX两种格式,并可为每个模型单独设置上下文长度、GPU卸载层数等参数,适合初学者快速上手。Ollama则以命令行和API为中心,一条ollama run即可启动模型,便于脚本调用和集成到开发工具中。两者底层都依赖llama.cpp(C++推理引擎)或MLX(Apple专为Apple Silicon优化的数组框架)。文中提到的"自定义MLX引擎"指绕过LM Studio/Ollama的默认后端,直接用MLX运行模型,通常能获得更高吞吐,但缺少现成的对话界面。
64GB到Ultra:双模型与巨兽模型
64GB是Mac Studio里Max芯片开始发力的地方,可用份额48GB,可以玩点新花样:同时加载两个模型。快的那个是QWEN 3 35B,有用户在一台M2 Max上用LM Studio推到每秒83.8个token,快到可以整天挂在代码编辑器后面;仔细的那个是QWEN 27B,在M4 Max上每秒23.9个token,慢一些,但适合难题。快模型处理大多数事情,仔细的那位在答案重要时接手。
老M1 Max还撑得住吗?撑得住,而且这是整条阶梯上最好的消息:一位M1 Max用户报告,在加速版本上35B跑到每秒62个token——一台老Mac依然远超你的阅读速度。
再往上是最挑内存的一档。所有人都想要的模型是QWEN 3.8 Flash Next:1250亿参数,但每个词只有60亿参数工作,是个跑得动的巨人。完整下载体积太大,好在有个精简版,刚好塞进份额里。在一台对应内存的M4 Max上,3-bit版本在llama.cpp里跑到每秒27.3个token,依然远超阅读速度——这是一台笔记本能装下的最大模型之一。容量更小的那一档则完全装不下,因为下载页上最小的文件都超过可用份额,博主在那里改用GPT OSS 120B,OpenAI的开放模型,63GB的下载还留有余地。这一档他把小模型能干的活全包了,外加长报告和棘手代码——那些小模型最先失手的地方。
阶梯的顶端是Ultra芯片的Mac Studio,Flash在这上面能跑到512GB。在一台最大的M3 Ultra上,有用户跑QWEN 3.5 397B,每秒29.2个token,模型体积是Flash Next的三倍。在一台内存减半的M5 Ultra上,GLM 5.3 Flash跑到每秒61.7个token,这是一个3200亿参数的模型,仍然快过你的眼睛。当然还有更大的开放模型,所以Ultra也有天花板,但没有别的Mac能这么接近它。
一张速查表与最后的建议
博主把每一档压缩成一句话:8GB跑Gemma 4 E2B做快速任务,别硬推;16GB用Gemma 4 12B作日常、QWEN 3.5 9B作快速;24GB跑Gemma 4 26B,跳过QWEN 27B;32GB跑QWEN 3.6 35B并保持短对话;48GB跑同一个模型但空间宽裕,难题留给Gemma 31B;64GB同时挂一个快的和一个仔细的;96GB装不下Flash Next就上GPT OSS;128GB则是Flash Next的天下。
至于要不要退订付费聊天机器人,他的态度很务实:在8GB Mac上他不会取消,但在32GB及以上,他会试着停一个月,看看自己到底想念什么。如果是他的16GB Air,他会今晚就装上LM Studio,从Gemma 4 12B开始。
这套实测的价值不在于鼓吹本地AI取代云端,而在于给出了一条按内存档位精确踩点的路线:先算清GPU实际能拿到多少内存,再按「能装下、跑得动、用得上」三层筛选模型。对大多数用户来说,真正的问题从来不是模型不够强,而是装不下或者跑不动。
相关推荐

OpenAI 11月30日关停Agent Builder等三项服务,开发者需紧急迁移
OpenAI 将于 11 月 30 日关停 Agent Builder、evals 仪表盘和可复用提示三项开发者功能,evals 已转为只读。本文梳理受影响范围、OpenAI 官方给出的迁移路径(Agent SDK、PromptFu、自有代码)以及开发者本周应完成的导出与重建动作。

RankSpot:按次付费的SEO与AI搜索执行层,让Agent替你写文、发布、换外链
RankSpot 是面向 AI Agent 的 SEO 与 AI 搜索执行层,通过 MCP 接入 Claude 或 ChatGPT,让 Agent 完成写文、发布和外链获取。按次付费,每篇文章 3 美元,读数据免费,支持 100 多种语言。

Appxiom:给AI编程助手装上生产环境上下文
Appxiom为AI编程Agent提供生产环境上下文,覆盖崩溃、卡顿、内存泄漏与失败的网络调用,支持Android、iOS、Flutter、KMP和Web,并通过Goal Friction Impact按业务目标排序Bug。