MacBook自训练PPO:隐藏信息卡牌游戏Cabo的浏览器实战

开发者用Self-play PPO在MacBook上从零训练Cabo卡牌AI,并部署到浏览器直接游玩。
该项目展示了在消费级硬件上训练隐藏信息卡牌游戏AI的完整闭环。Cabo因部分可观测性成为强化学习的理想试验场,开发者采用Self-play PPO让模型与历史版本对弈,逐步从随机出牌进化出记忆与推理能力。训练全程在MacBook完成,通过轻量化网络和并行环境设计平衡算力限制;模型经ONNX等格式导出后在前端本地推理,用户无需安装即可在浏览器对战。项目降低了多智能体强化学习的实践门槛,为个人开发者提供了可复用的训练—导出—部署范式,但尚缺训练曲线和胜率等量化指标,策略鲁棒性有待进一步验证。
从零训练一个隐藏信息卡牌AI:Self-play PPO遇上Cabo
在强化学习社区中,隐藏信息卡牌游戏因其不完美信息特性,被视为比棋类更接近真实决策场景的挑战。近期,一位开发者在Reddit分享了一个引人注目的项目:基于Cabo规则(一款流行的隐藏信息卡牌游戏),使用Self-play PPO算法从零训练AI,全程在MacBook上完成,并提供了可直接在浏览器中游玩的Demo。
这个项目的核心价值在于降低了多智能体强化学习的实践门槛。不需要GPU集群,不需要海量分布式采样,一台消费级笔记本就能跑通完整的训练闭环,并让模型与人类玩家实时对战。
为什么Cabo是强化学习的理想试验场?
Cabo(类似记忆翻牌与换牌的机制)规则简单,但信息结构复杂:每位玩家只能看到自己部分手牌,其余信息被隐藏,且需要通过抽牌、交换、记忆来推断对手状态。这种部分可观测性(Partially Observable)天然适合用强化学习来探索策略。
开发者选择PPO(Proximal Policy Optimization)的变体进行self-play(自对弈),让模型不断与历史版本的自己博弈,从而在无监督信号下学习出牌策略。相比监督学习依赖人类标注,自我对弈能持续推动策略进化,这在AlphaZero后已成为复杂博弈任务的标配思路。
值得留意的是,Cabo的随机性(抽牌堆)对策略稳定性提出更高要求。PPO的裁剪目标(clipped objective)能在更新时限制策略突变,配合自我对弈的课程效应,使模型逐步从随机出牌过渡到具备记忆和推理的决策。
部分可观测马尔可夫决策过程(POMDP) 是描述隐藏信息游戏的标准数学框架。与完全可观测的MDP不同,POMDP中智能体无法直接获知环境的真实状态,只能通过观测(observation)间接推断。在Cabo中,玩家看不到对手手牌和牌堆顺序,只能基于已公开的交换动作和自身手牌形成信念状态(belief state)。PPO等策略梯度方法在POMDP下通常需要结合记忆机制(如RNN或Transformer)来整合历史观测,否则策略会因信息缺失而退化。这也解释了为何Cabo对网络结构设计提出了更高要求——模型必须学会从动作序列中提取隐藏信息。
用MacBook跑通训练:工程上的关键取舍
据项目分享,训练全程在MacBook上完成,这暗示了团队在算法效率与硬件限制之间做了精细平衡。通常,隐藏信息游戏需要更长的训练周期来收敛,而消费级硬件内存和算力有限,意味着网络结构、并行环境和经验回放机制都需轻量化设计。
浏览器可玩则进一步降低了体验门槛:模型可能是通过ONNX或类似格式导出,在Web前端本地推理,避免了服务器依赖。这种“训练—导出—前端游玩”的闭环,为其他爱好者提供了可复用的范式。对于想入门多智能体强化学习的开发者,这个项目提供了一个可直接跑通的模板,而非停留在论文公式里。
PPO的裁剪目标(clipped objective) 通过限制新旧策略的概率比在[1-ε, 1+ε]区间内,避免单次更新步长过大导致策略崩溃。在自对弈场景中,这一机制尤为重要:对手策略随训练不断变化,若更新过于激进,模型容易过拟合当前对手而丧失泛化能力。配合广义优势估计(GAE),PPO能在偏差与方差之间取得平衡,适合Cabo这类回合制、奖励稀疏的游戏。工程上,轻量化设计通常包括减小隐藏层维度、使用多环境并行采样(如向量化环境)以及缩短rollout长度,从而在笔记本内存限制下维持稳定的样本吞吐。
浏览器即开即玩:从训练到部署的最后一公里
项目将模型部署在浏览器端,用户无需安装任何环境即可对战。这背后通常需要将PyTorch模型转换为轻量推理格式,并在前端用JavaScript引擎执行。对于Cabo这类回合制卡牌游戏,推理延迟要求不高,前端推理完全可行。
这种部署方式有一个隐性好处:保护用户隐私,所有对局都在本地计算。同时,它也展示了强化学习模型落地的另一种可能——不一定要上云,端侧也能承载策略推理。
ONNX(Open Neural Network Exchange) 是一种跨框架的模型交换格式,支持将PyTorch训练好的模型导出为与框架无关的计算图。导出后,可通过ONNX Runtime Web在浏览器中利用WebAssembly或WebGPU执行推理,无需Python后端。对于Cabo这类回合制卡牌游戏,单次推理仅涉及少量矩阵运算,前端延迟通常在毫秒级,完全满足实时对战需求。这种端侧推理方案还避免了网络传输开销和服务器成本,使Demo可以静态托管,进一步降低了分享门槛。
对AI应用开发者的启示
这个项目最直接的启发是成本可控的强化学习实验不再遥不可及。许多开发者对RL的印象停留在“需要大算力”,而Self-play PPO + 消费级硬件的组合说明:对于规则明确、状态空间适中的游戏,个人开发者完全可以在本地完成训练和验证。
其次,隐藏信息游戏为AI研究提供了丰富的测试床。不同于完全信息博弈,这类游戏要求模型在不确定下做决策,更贴近现实世界的推荐、谈判或资源调度场景。如果能把Cabo上的训练经验迁移到更复杂的现实问题,价值会更大。
最后,浏览器可玩意味着成果可被快速验证。开源社区中,能直接玩的Demo往往比仅放出代码的项目获得更多反馈,反过来帮助开发者迭代。
局限与未来方向
目前该项目仍属个人实验性质,原文未披露训练时长、模型规模或胜率等量化指标。Cabo的随机性也意味着策略评估需要大量对局才能稳定。未来若能公开训练曲线和基准测试,将更有利于社区复现与改进。此外,自对弈策略可能陷入局部最优,需要引入多样性机制或对手池来提升鲁棒性——这些是项目从演示走向可靠AI的必经之路。
相关推荐
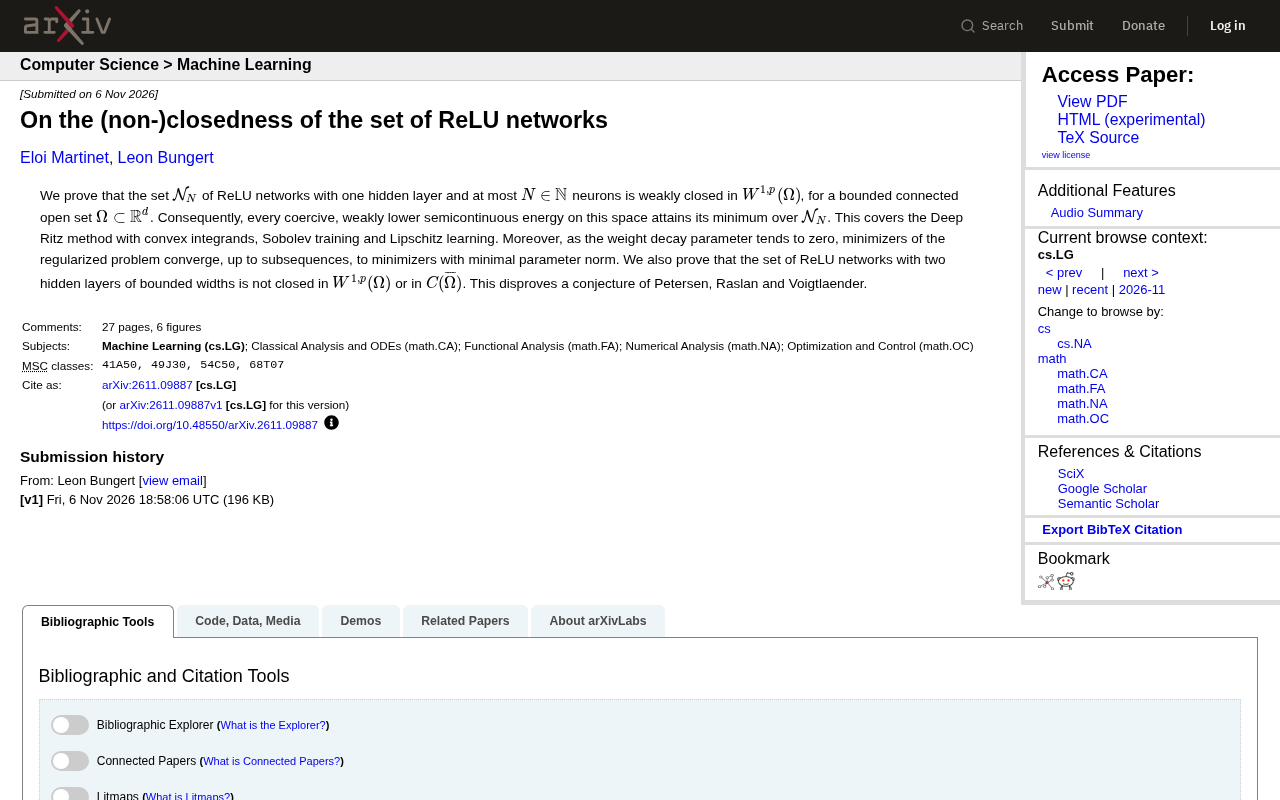
ReLU网络集合的闭性新证:单隐层弱闭,双隐层非闭
新研究证明单隐层ReLU网络集合在W^{1,p}中弱闭,保证Deep Ritz等方法解的存在性;而双隐层网络集合非闭,推翻已有猜想。
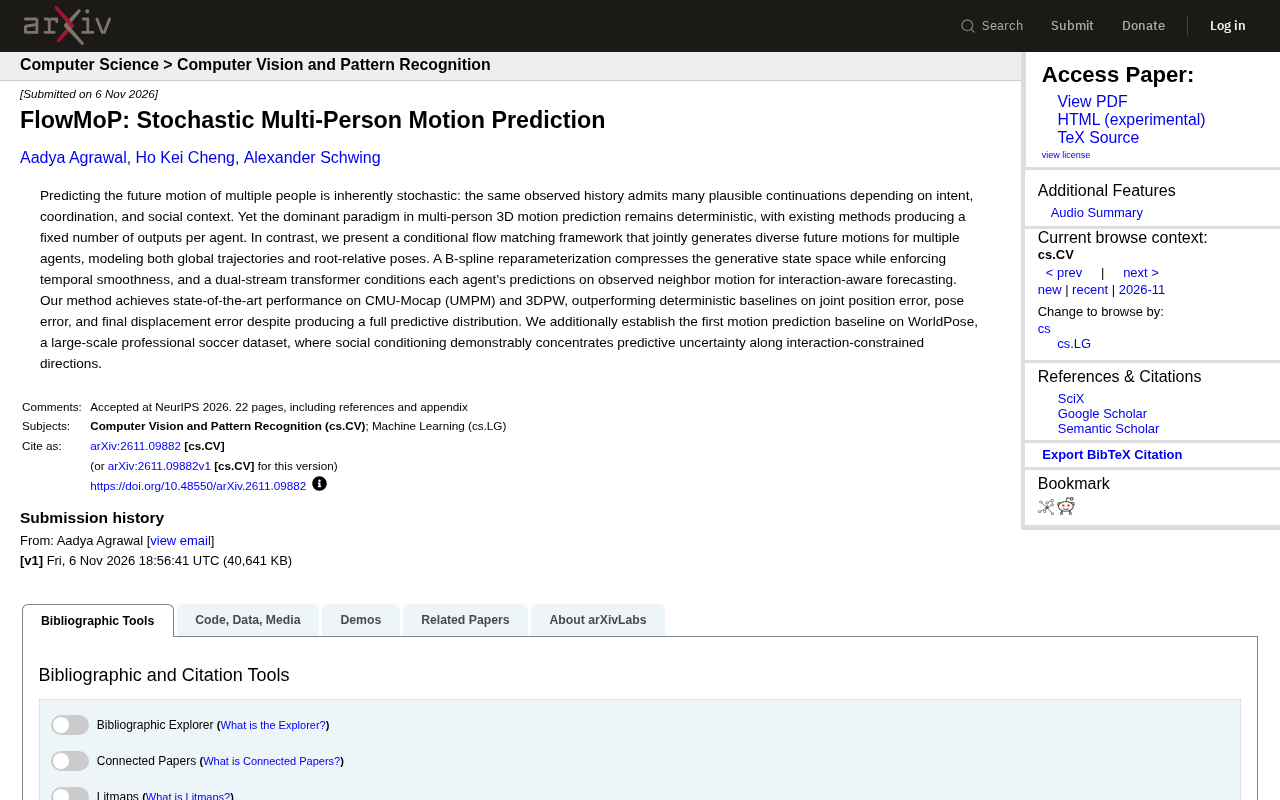
FlowMoP:随机多人运动预测新框架
FlowMoP提出条件流匹配框架,联合生成多个智能体的多样化未来运动,通过B样条重参数化与双流Transformer实现交互感知预测,在CMU-Mocap和3DPW上超越确定性基线,并建立WorldPose首个运动预测基线。
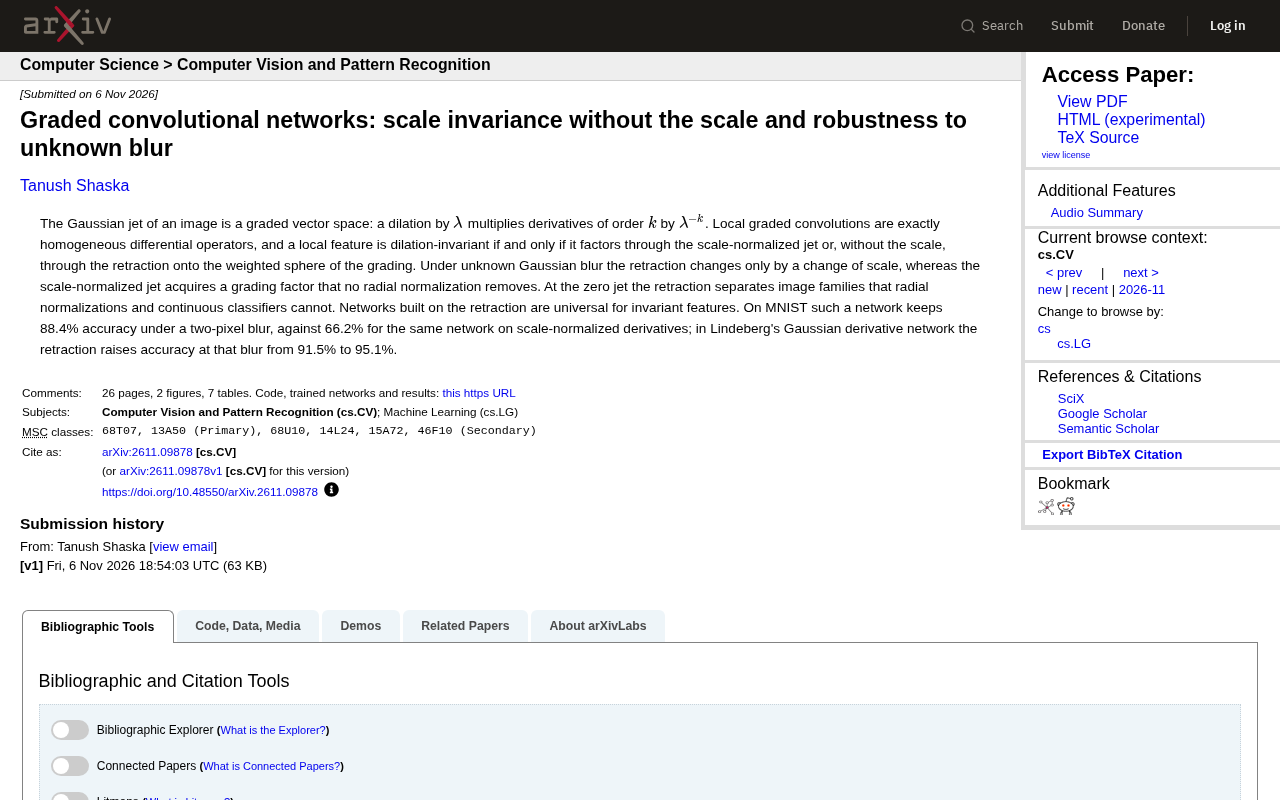
分级卷积网络:无需尺度参数的尺度不变性与抗模糊鲁棒性
分级卷积网络利用图像高斯射流的分级向量空间结构,通过回缩操作实现无需尺度参数的尺度不变性,并在未知高斯模糊下显著提升鲁棒性。MNIST实验显示,两像素模糊下准确率保持88.4%,优于尺度归一化导数的66.2%。